Claude Opus 5.5 ist da. Leistung auf Fable 5.1-Niveau, 40 % günstiger als Opus 5
Inhaltsverzeichnis
Hallo. Am 22. September 2026 (US-amerikanischer Zeit) hat Anthropic „Claude Opus 5.5" angekündigt. Es ist das erste Modell der neuen Claude 5.5-Familie; Sonnet 5.5 und Haiku 5.5 sollen innerhalb weniger Wochen folgen.
Das im Juli erschienene Opus 5 war ein Modell unter dem Motto „Intelligenz nahe an Fable 5 zum Preis von Opus". Anfang dieses Monats kam dann Fable 5.1 heraus, womit Fable wieder die Nase vorn hatte. Das neue Opus 5.5 ist nun so positioniert, dass es bei den meisten Aufgaben eine mit Fable 5.1 vergleichbare Leistung bietet - und das günstiger als Opus 5.
Der Beginn der offiziellen Ankündigung lässt sich im Wesentlichen in diesem einen Satz zusammenfassen:
It performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5.
Es ist das Versprechen, bei den meisten Arbeiten auf demselben Niveau wie Fable 5.1 zu agieren, während die Ausführungskosten um 40 % niedriger sind als bei Opus 5. In diesem Artikel fassen wir auf Grundlage der offiziellen Ankündigung zusammen, was sich bei Opus 5.5 geändert hat und worin die konkreten Vorteile für Nutzer von Claude Code liegen. In meiner eigenen Claude Code-Umgebung war Opus 5.5 bereits als Standardmodell eingestellt.
Die Kernpunkte der Ankündigung
Die offizielle Ankündigung unterteilt die Verbesserungen von Opus 5.5 in vier Hauptbereiche:
- Leistung - Ein großer Sprung im Vergleich zu Opus 5; bei vielen Aufgaben auf Augenhöhe mit Fable 5.1. Einer der Early-Tester berichtete, eine Code-Migration von 680.000 Zeilen in weniger als einem Tag abgeschlossen zu haben.
- Sicherheit - Die bisher beste Punktzahl beim hauseigenen automatisierten Verhaltensaudit (ein Alignment-Evaluierungsverfahren, das das Verhalten in Tausenden simulierten Umgebungen überprüft). Irreversible Aktionen sowie Handlungen außerhalb der vorgegebenen Grenzen wurden drastisch reduziert.
- Kosten und Geschwindigkeit - Bei Standardeinstellungen in typischen Workloads etwa 40 % günstiger als Opus 5, bei einer um über 30 % schnelleren Ausgabeerzeugung.
- Kommunikation - Die Texte sind leichter lesbar geworden und stellen wichtige Informationen an den Anfang.
Zudem ist Opus 5.5 das erste Release, nachdem Dario Amodei dazu aufgerufen hatte, das Tempo des Fortschritts an der technologischen Grenze zu regulieren („pacing the frontier"). Vor der Veröffentlichung wurde das Modell auch von externen Evaluierungsinstitutionen wie METR und Frontier Design getestet. Auf das Thema Sicherheit gehen wir in einem späteren Abschnitt näher ein.
Bei den Benchmarks in vielen Punkten vor Fable 5.1 und GPT-6 Astra
Hier ist die offizielle Vergleichstabelle:
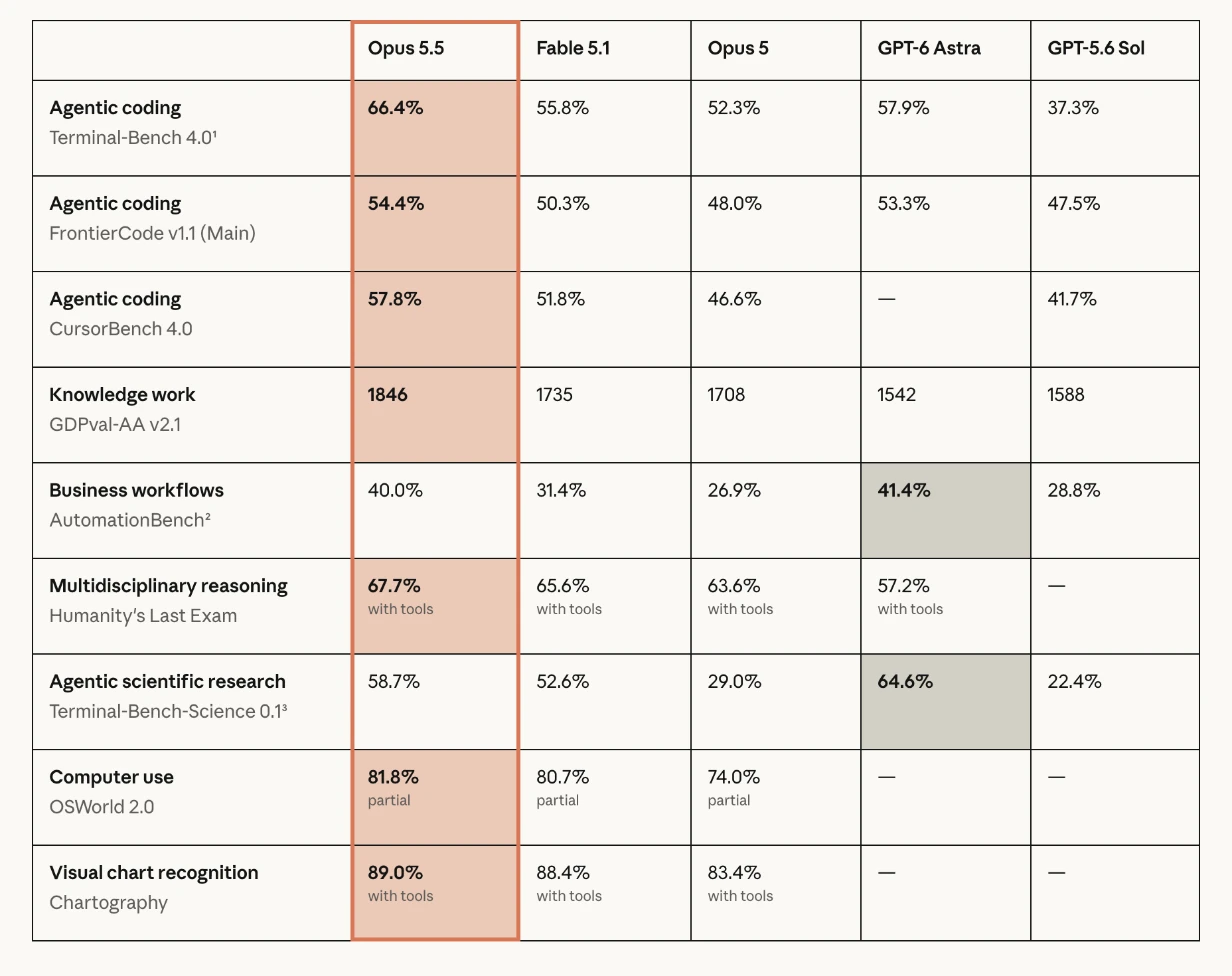 (Quelle: Introducing Claude Opus 5.5 \ Anthropic)
Die wichtigsten Werte im Auszug:
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0 (Agentisches Coding im Terminal) | 66,4% | 55,8% | 52,3% | 57,9% |
| FrontierCode v1.1 (Agentisches Coding) | 54,4% | 50,3% | 48,0% | 53,3% |
| CursorBench 4.0 (Agentisches Coding) | 57,8% | 51,8% | 46,6% | Nicht aufgeführt |
| GDPval-AA v2.1 (Wissensarbeit, Elo) | 1846 | 1735 | 1708 | 1542 |
| AutomationBench (Geschäftsworkflows) | 40,0% | 31,4% | 26,9% | 41,4% |
| Terminal-Bench-Science 0.1 (Wissenschaftliche Forschung als Agent) | 58,7% | 52,6% | 29,0% | 64,6% |
| OSWorld 2.0 (Computerbedienung, partiell) | 81,8% | 80,7% | 74,0% | Nicht aufgeführt |
Am meisten sticht Terminal-Bench 4.0 ins Auge. Von 52,3 % bei Opus 5 klettert der Wert um 14,1 Prozentpunkte auf 66,4 % und übertrifft auch Fable 5.1 (55,8 %) um mehr als 10 Punkte. Da dies meiner Meinung nach der Benchmark ist, der der realen Nutzung von Claude Code am nächsten kommt, ist dieser Zuwachs eine ausgesprochen erfreuliche Nachricht.
Andererseits liegt GPT-6 Astra bei AutomationBench und Terminal-Bench-Science 0.1 vorn, Opus 5.5 führt also nicht in ausnahmslos jeder Kategorie. Zudem sollte man bedenken, dass diese Zahlen von Anthropic selbst veröffentlicht wurden und nicht aus unabhängigen Verifizierungen Dritter stammen.
Wichtige Hinweise zur Interpretation der Zahlen
In den Fußnoten finden sich einige relevante Hinweise:
- Sofern nicht anders angegeben, wurden die Ergebnisse von Opus 5.5 mit auf „max effort" eingestelltem Adaptive Thinking erzielt. Lediglich bei Terminal-Bench 4.0 wurden für Opus 5.5 „xhigh" und für GPT-6 Astra „high" verwendet, um die jeweiligen Höchstwerte darzustellen.
- Die Evaluierung fand unter Aktivierung derselben Safeguards statt, die auch in der Praxis bei Opus 5.5 greifen (entsprechend denen von Fable 5.1). Wenn während der Evaluierung ein Safeguard eingreift, wird die jeweilige Aufgabe an ein anderes Modell übergeben, um fortzufahren: bei Cybersecurity-Aufgaben an Opus 4.8, bei Aufgaben aus den Bereichen Biologie und Frontier-LLM-Entwicklung an Opus 5. Da ein Teil der Aufgaben somit von älteren Modellen gelöst wurde, könnten die Werte tendenziell etwas niedriger ausfallen, als es dem tatsächlichen Leistungsvermögen von Opus 5.5 entspricht.
- AutomationBench wurde von Zapier durchgeführt; da hier kein Fallback auf Ersatzmodelle konfiguriert war, wurden Safeguard-Interventionen direkt als Fehlschlag gewertet.
- Der Standardfehler für Terminal-Bench 4.0 wird bei Opus 5.5 mit ±2,6 Prozentpunkten angegeben.
Bemerkenswert ist auch der Hinweis von Anthropic selbst: „Bei diesem Fähigkeitsniveau sind Benchmark-Unterschiede als Indikator für tatsächliche Leistungsunterschiede in der Praxis weniger verlässlich geworden." Nach dem internen Nutzungsgefühl sei der Unterschied zwischen Opus 5.5 und Fable 5.1 geringer, als es die Testergebnisse vermuten lassen. Statt die Tabellendifferenzen eins zu eins als Leistungsabstand zu interpretieren, trifft es die Realität wohl eher, wenn man sagt: „Ein Modell auf praktisch demselben Niveau wie Fable 5.1 ist nun in der Preisklasse von Opus verfügbar."
Übrigens weichen die Versionen CursorBench 4.0 und GDPval-AA v2.1 von den im früheren Fable 5.1-Artikel erwähnten Versionen CursorBench 3.2.0 und GDPval-AA v2 ab. Daher weichen die Werte für Fable 5.1 ab und sind nicht direkt mit denen des vorherigen Artikels vergleichbar.
Starke Leistung auch bei geringerem Effort - enormer Kostenvorteil
Wie Anthropic betont, liegt der deutlichste Vorteil von Opus 5.5 in seiner Effizienz - und genau das dürfte für die tägliche Praxis am relevantesten sein. Nicht nur der Preis pro Token ist gesunken, sondern auch die Anzahl der benötigten Token pro Aufgabe. Im Zusammenspiel ergibt dies die Ersparnis von rund 40 % gegenüber Opus 5.
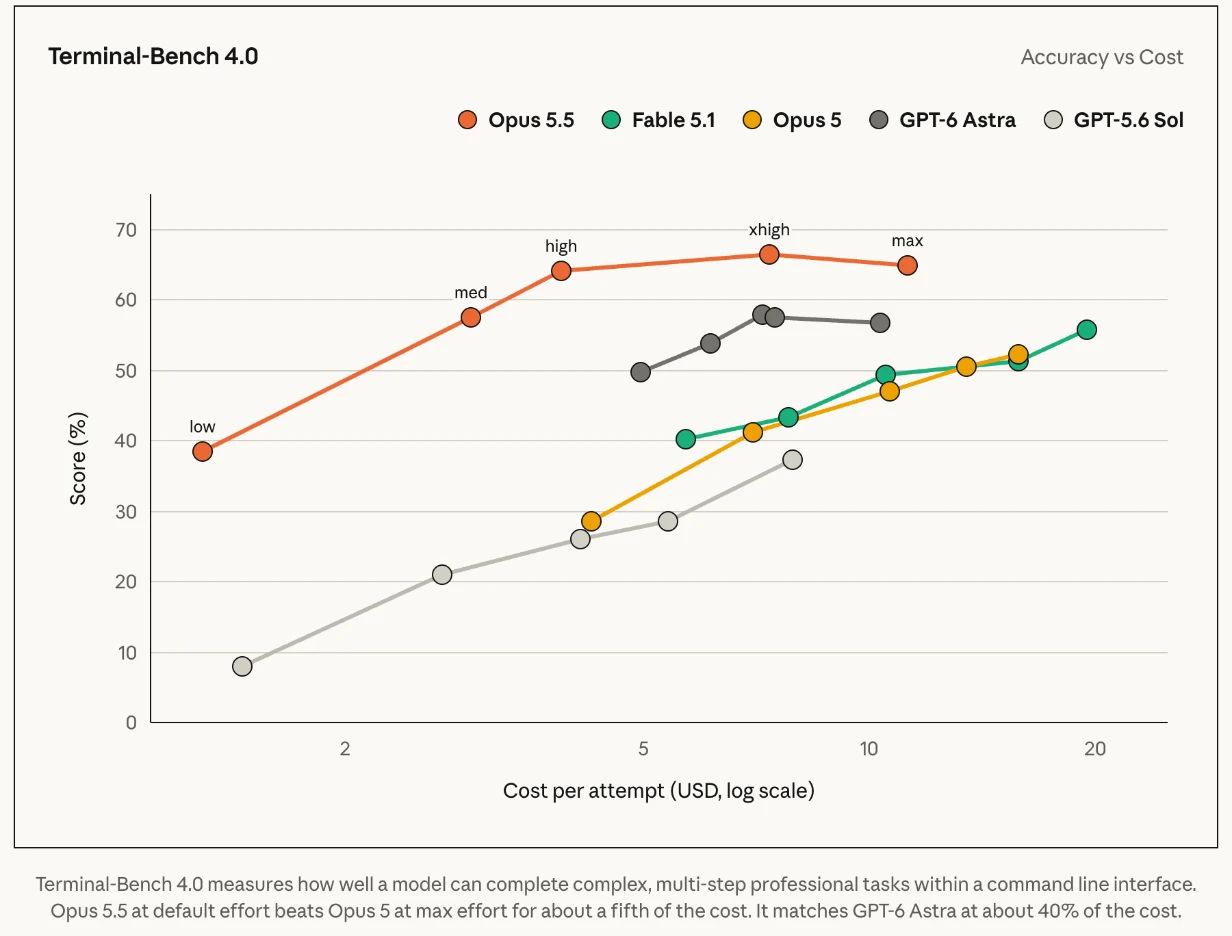
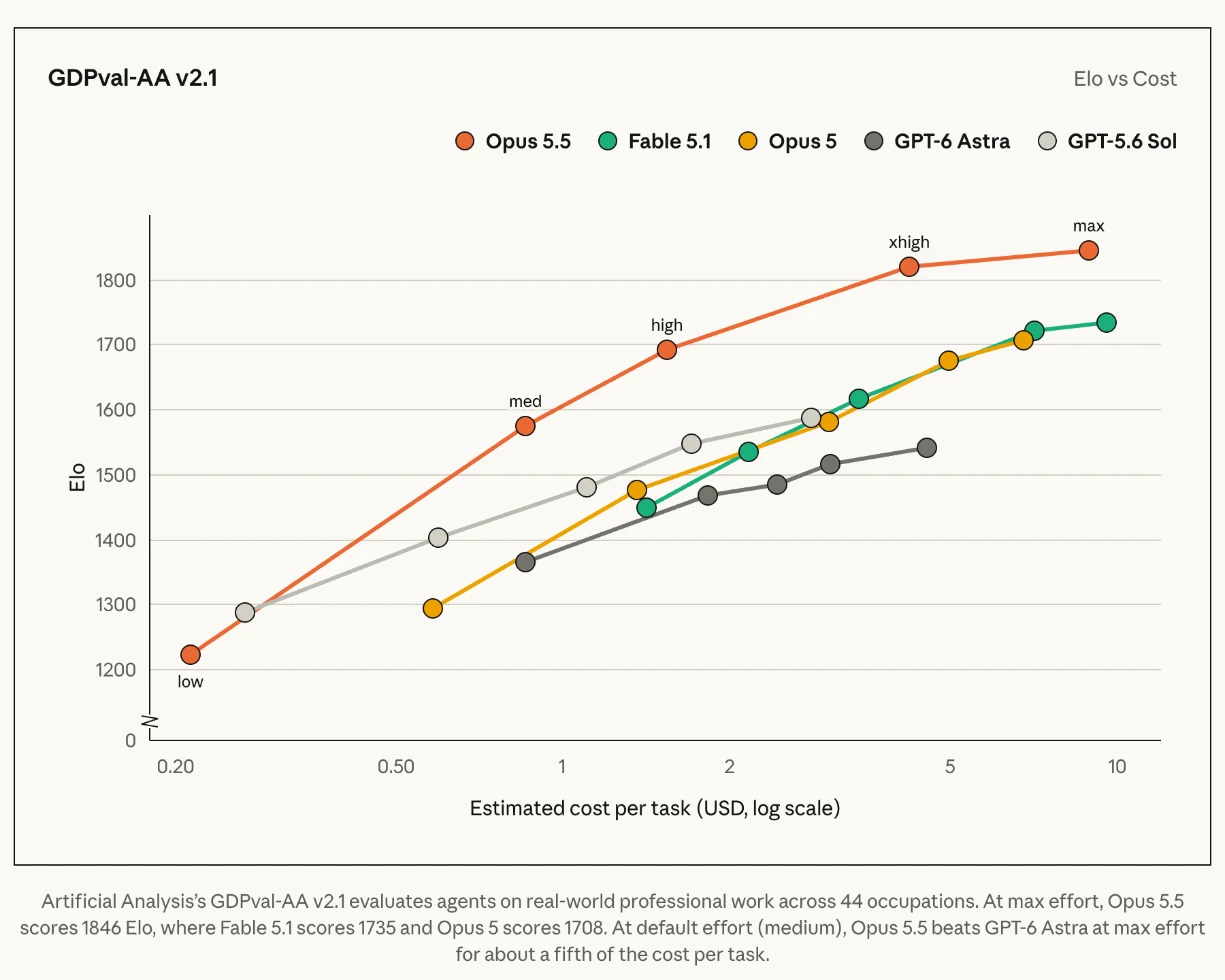
„Effort" ist ein Parameter, der bestimmt, wie intensiv das Modell vor der Antwort nachdenkt, wählbar in fünf Stufen: low / medium / high / xhigh / max. Höhere Stufen bedeuten tieferes Nachdenken auf Kosten von mehr Token und Zeit; niedrigere Stufen arbeiten schneller und günstiger. Im Allgemeinen steigen mit höherem Effort auch die Benchmark-Ergebnisse. In den offiziellen Diagrammen sind auf der horizontalen Achse die Kosten pro Aufgabe (logarithmische Skala) und auf der vertikalen Achse die Scores dargestellt, wobei die einzelnen Effort-Stufen miteinander verbunden sind. Je weiter oben links ein Punkt liegt, desto „günstiger und leistungsfähiger" ist das Modell.
 (Quelle: Introducing Claude Opus 5.5 \ Anthropic)
Im Diagramm zu Terminal-Bench 4.0 befindet sich die Kurve von Opus 5.5 weiter oben links als die aller anderen Modelle. Abgelesen an den Achsen erreicht Opus 5.5 bei „medium" rund 57 % (ca. 3 $ pro Durchlauf) und bei „high" rund 64 % (knapp 4 $). Damit übertrifft es bereits auf Stufe „medium" den „max"-Wert von Opus 5 (ca. 52 %, rund 15 $) und den von Fable 5.1 (55,8 %, knapp 20 $) - zu einem Bruchteil der Kosten. Laut Anthropic übertrifft Opus 5.5 bei Standard-Effort das Modell Opus 5 bei maximalem Effort zu etwa einem Fünftel der Kosten und zieht mit GPT-6 Astra bei etwa 40 % der Kosten gleich.
Interessanterweise erreicht der Score von Opus 5.5 bei „xhigh" (66,4 %) seinen Höhepunkt und sinkt bei „max" (ca. 65 %) wieder leicht ab. Das zeigt deutlich: „Mehr Effort führt nicht zwingend immer zu besseren Ergebnissen."
 (Quelle: Introducing Claude Opus 5.5 \ Anthropic)
Der Wissensarbeits-Benchmark GDPval-AA v2.1 von Artificial Analysis bewertet Agenten anhand realer Aufgaben aus 44 Berufsfeldern. Auch hier liegt Opus 5.5 durchweg weiter links oben. Auf dem standardmäßigen Effort (medium) erzielt es rund 1575 Punkte (ca. 0,85 $ pro Aufgabe) und übertrifft damit das Maximum von GPT-6 Astra (1542, ca. 4,50 $) zu etwa einem Fünftel der Kosten. Bereits bei „xhigh" (rund 1820, etwas über 4 $) liegt es über dem Höchstwert von Fable 5.1 (1735, ca. 9,50 $), und das bei weniger als der Hälfte der Kosten.
(Die Zahlen aus den Diagrammen sind von mir abgelesene Schätzwerte; die Messungen stammen von Anthropic.) Anthropic führt weiter an, dass Opus 5.5 bei FrontierCode mit Standard-Effort GPT-6 Astra zu etwa 20 % der Kosten schlägt und bei CursorBench GPT-5.6 Sol bei rund einem Drittel der Kosten um 11 Punkte übertrifft.
Die Berichte der Early-Tester bestätigen dieses Bild:
- Deloitte berichtet, dass selbst auf der niedrigsten Effort-Stufe bei Code-Reviews 72 % der bekannten Fehler gefunden wurden - mehr als bei Opus 5 mit hohem Effort (56 %). Zudem gab es weniger Fehlalarme und die Ausgabelänge war deutlich kompakter.
- Factory bezeichnete es als das erste Modell, bei dem man „medium effort" bedenkenlos als Standard festlegen könne; es habe die gleichen Ergebnisse wie Opus 5 auf „high effort" erzielt, bei 20-25 % weniger Ausgabe-Token.
- Optiver gab an, bei agentischen Coding-Aufgaben dieselbe Qualität wie Opus 5 mit etwa der Hälfte an Interaktionsrunden, Zeit und Ausgabe-Token erreicht zu haben, was die Kosten um 40-50 % senkte.
In Claude Code lässt sich der Effort im Menü /model über die Pfeiltasten anpassen. Dadurch fällt es nun deutlich leichter, Routineaufgaben auf „medium" oder „high" laufen zu lassen und den Effort nur bei besonders anspruchsvollen Problemen hochzuschrauben.
Preise: 20 % günstiger bei In-/Output, 60 % günstiger bei Cache Reads
Die Preisstruktur im Überblick:
| Posten (pro 1M Token) | Opus 5.5 | Opus 5 |
|---|---|---|
| Input | $4 | $5 |
| Output | $20 | $25 |
| Cache Read | $0.20 | $0.50 |
| Cache Write | $5 | $6.25 |
Input und Output werden um 20 % günstiger, das Auslesen aus dem Cache (Cache Read bei Wiederverwendung bereits verarbeiteter Eingaben) sogar um 60 %. Da laut Anthropic bei agentischen Abläufen und beim Programmieren der Großteil der Kosten auf Cache Reads entfällt, macht sich dies insbesondere bei langen Sitzungen in Claude Code spürbar bezahlt.
Zum Vergleich: Fable 5.1 kostet 10 $ für Input, 50 $ für Output und 0,25 $ für Cache Reads. Verglichen mit den Preisen für In- und Output liegt Opus 5.5 somit bei lediglich 40 % der Kosten von Fable 5.1.
In Claude Code und auf der Claude Platform steht zudem der Fast-Modus zur Verfügung: Bis zu 2,5-mal schnellere Ausführung bei Preisen von 8 $ (Input) und 40 $ (Output) pro 1 Million Token.
Höhere Nutzungslimits für Abonnenten
Relevant für Abo-Nutzer: Parallel zu den Preissenkungen werden die Nutzungslimits pro 5-Stunden-Fenster für die Tarife Pro, Max, Team sowie die sitzplatzbasierten Enterprise-Pläne angehoben.
Zusätzlich erhalten Abonnenten einen einmaligen Rate-Limit-Reset gutgeschrieben, den sie flexibel nach eigenem Ermessen einsetzen können. Gerade vor wichtigen Deadlines ist es eine willkommene Absicherung, ein solches Kontingent in der Hinterhand zu haben.
Coding: Stark bei umfangreichen, weitreichenden Aufgaben
Anthropic hebt insbesondere hervor, dass Opus 5.5 bei Aufgaben glänzt, die sich über die gesamte Codebasis erstrecken - wie etwa großflächige Migrationen oder Audits. Beispielhaft wurden folgende Fälle genannt:
- Einer der Early-Tester führte das Audit und Refactoring einer Codebasis mit 200.000 Zeilen in unter drei Stunden durch. Mit Opus 5 dauerte dieser Vorgang über 20 Stunden und verbrauchte das 2,5-Fache an Token.
- In einem internen Test bei Anthropic sollte die Load-Balancing-Software HAProxy von C nach Rust portiert werden. Sowohl Opus 5.5 als auch Fable 5.1 bestanden nahezu alle bordeigenen Regressionstests von HAProxy. Opus 5.5 benötigte dafür 9,5 Stunden (Fable 5.1: 12 Stunden) und verursachte 51 % weniger Kosten.
- Bei einem Test zur Optimierung der Ladezeiten aller Seiten einer Web-App war Opus 5.5 in 39 von 40 Versuchen erfolgreich. Opus 5 erzielte geringere Verbesserungen und veränderte teils ungewollt das Verhalten der Applikation.
Auch das Feedback der Early-Tester liefert für Claude Code-Anwender interessante Einblicke:
- Der CPO von GitHub betonte, dass Opus 5.5 in Tests mit der GitHub Copilot CLI und VS Code zu den Modellen mit den wenigsten Token und Schritten gehörte. In VS Code löste es mehr Terminal-Aufgaben in weniger als der Hälfte der Schritte von Opus 5.
- Ein Entwickler von Stripe berichtete über das Rebasen von 40 gestapelten Pull Requests, eine Aufgabe, die sonst Tage in Anspruch nimmt: Eine einzige Opus 5.5-Sitzung koordinierte über ein Dutzend Untersitzungen, löste alle Konflikte nachvollziehbar auf, und am nächsten Nachmittag passierten alle 40 PRs erfolgreich die CI.
- Ein Softwareingenieur bei Clio übertrug dem Modell eine große Aufgabe über sechs Repositories hinweg über Nacht. Das Modell blieb über 18 Stunden hinweg fehlerfrei auf Kurs, erreichte Meilensteine schneller als Opus 5 und erforderte kaum manuelle Nacharbeiten.
- Column lobte, dass das Modell Aufgaben deutlich geschickter an Sub-Agenten delegiere und eigene Ergebnisse eigenständiger und kreativer validiere.
Zwar handelt es sich hierbei um individuelle Erfahrungsberichte aus unterschiedlichen Umgebungen und nicht um strikt standardisierte Vergleichstests. Dennoch zeigt die einheitliche Tendenz - weniger Schritte, hohe Ausdauer bei unbeaufsichtigter Langzeitarbeit, besseres Handling von Sub-Agenten -, worauf sich Nutzer bei komplexen Claude Code-Aufgaben einstellen können.
Sicherheitsvorkehrungen
Wenn Coding-Agenten über längere Zeit in unternehmenseigenen Systemen agieren, ist die Kontrollierbarkeit ihres Verhaltens essenziell. Anthropic positioniert Opus 5.5 als den „bisher sichersten Coding-Agenten" und stützt sich dabei auf drei Säulen: vorgeschaltete Klassifikatoren zur Überprüfung jeder Aktion vor der Ausführung, eine quelloffene Sandbox zur Überprüfung durch Sicherheitsteams sowie automatisierte Code-Reviews zur Erkennung von Schwachstellen vor dem Mergen.
Auch die Resilienz des Modells selbst wurde gestärkt: Die Widerstandsfähigkeit gegen Prompt-Injections (Angriffe, bei denen schädliche Anweisungen in externe Daten eingebettet werden, um das Modell zu kapern) war in sämtlichen Szenarien - Coding, Tool-Nutzung, Computerbedienung und Web-Browsing - mindestens auf dem Niveau von Opus 5 oder besser. In Benchmarks des KI-Sicherheitsunternehmens Gray Swan wies Opus 5.5 zusammen mit Fable 5.1 die niedrigste Erfolgsquote für Prompt-Injections unter allen getesteten Modellen auf.
Wissensarbeit: Verlässliche Recherchen ohne Halluzinationen
Im Bereich der Wissensarbeit sticht vor allem die Präzision bei Analyse- und Rechercheberichten hervor. In einem internen Test sollte das Modell den Quartalsbericht eines Unternehmens verfassen - basierend ausschließlich auf einer Web-Kopie, in der die Finanzzahlen schwer auffindbar waren. Gewertet wurde nach dem strikten Kriterium, dass eine einzige erfundene Zahl oder ein falsches Zitat zum Nichtbestehen führt. Opus 5.5 bestand in 16 von 18 Durchläufen (über verschiedene Effort-Stufen hinweg), während Fable 5.1 und Opus 5 in keinem einzigen Durchlauf fehlerfrei blieben.
Weitere Praxisbeispiele:
- Bei der Analyse einer fiktiven Fusion zweier HR-Softwareanbieter inklusive Finanzmodellierung in Excel und Erstellung von Präsentationsfolien für das Management benötigte Opus 5.5 63 Minuten (Opus 5: 93 Minuten) bei 50 % geringeren Kosten. Bei gleichem Fazit lieferte Opus 5.5 die gründlichere Modellierung und die verständlicheren Unterlagen.
- Die Investmentgesellschaft Walleye Capital berichtete, dass Opus 5.5 selbst auf niedrigster Stufe fast alle Testaufgaben löste. Bei hohem Effort bemerkte und korrigierte das Modell sogar einen um eine Minute verschobenen Indexierungsfehler in den Testvorgaben - ein Fehler, der zuvor keinem anderen Modell aufgefallen war.
- Die Datenanalyse-Plattform Hex stellte dem Modell die Aufgabe zu prüfen, ob ein Paket verspätet war oder ein Fehler im Tracking vorlag. Während Opus 5 anhand der Daten fälschlich meldete, das Tracking funktioniere ordnungsgemäß, stellte Opus 5.5 korrekt fest, dass das Paket tatsächlich verspätet war und zusätzlich das Tracking-System fehlerhaft arbeitete.
Das Modell gibt sich nicht mit der erstbesten plausiblen Antwort zufrieden, sondern hakt tiefer nach. Die Fähigkeit zur „Selbstüberprüfung", die schon bei Opus 5 spürbar zulegte, wurde hier nochmals verfeinert.
Bessere Lesbarkeit der Ausgaben
Ein häufiger Kritikpunkt an Opus 5 war die teils umständliche Lesbarkeit der Antworten. Hieran wurde bei Opus 5.5 spürbar gearbeitet.
Laut Anthropic sind die Antworten von Opus 5.5 auf einen Blick verständlich: Wichtige Informationen stehen ganz vorne, unnötiger Fachjargon und eigenwillige Formulierungen wurden reduziert, und vorgegebene Formatierungsregeln werden strikter befolgt. Auf der offiziellen Ankündigungsseite wird dies an einem Beispiel zur Erklärung eines Softwarefehlers demonstriert:
- Opus 5 baute die Erklärung chronologisch nach dem Ablauf der Untersuchung auf („Was wurde gefunden", „Inhalt des Bugs"), sodass das genaue Ausmaß der Auswirkungen erst ganz am Ende klar wurde.
- Opus 5.5 bringt das Fazit direkt in die Überschrift („Umsatzrückgang ist auf Bug beim Abrechnungs-Refactoring zurückzuführen"), beziffert die Beträge sofort konkret (1,50 $ durch Änderung des Free-Tiers, 9,92 $ durch den Bug) und geht erst danach auf den fehlerhaften Code ein.
Auch ein Entwickler von Ramp merkte an, dass ausschweifende, schwer nachvollziehbare Ausgaben bisher das größte Manko moderner Spitzenmodelle gewesen seien - ein Problem, das Opus 5.5 wirkungsvoll behebe. Box meldete, dass bei einem Drittel der bisherigen Token-Menge die Weitschweifigkeit der Antworten im Vergleich zu Opus 5 um 40 % abgenommen habe.
Anthropic betont, dass diese verbesserte Lesbarkeit nicht nur dem Komfort diene, sondern auch einen Sicherheitsfaktor darstelle: Arbeitsabläufe lassen sich dadurch schneller überblicken und validieren. Dass man bei längeren Claude Code-Sessions weniger Zeit mit dem Entziffern von Berichten verbringt, dürfte im Alltag zu den unmittelbarsten Erleichterungen gehören.
Sicherheit und Alignment
Das Kapitel zur Sicherheit steht dieses Mal unter dem Leitgedanken „Pacing the frontier" (Regulierung des Entwicklungstempos an der technologischen Grenze). Dies schließt an Äußerungen von Dario Amodei aus der Vorwoche an, wonach das Tempo des KI-Fortschritts austariert werden müsse, damit Sicherheitsmaßnahmen stets mit den Modellfähigkeiten Schritt halten. Die Strategie verfolge zwei Zeithorizonte: Einerseits werden die Schutzmechanismen für heutige Modelle kontinuierlich geschärft; andererseits brauche es für künftige Generationen, die in der Lage sind, KI-Forschung selbstständig zu automatisieren, noch deutlich strengere Sicherheitsstandards sowie staatliche Regulierung.
Die wichtigsten Ergebnisse der Alignment-Evaluierung für Opus 5.5:
- Automatisiertes Verhaltensaudit - In der primären Evaluierung über rund 2.000 Szenarien hinweg schnitt das Modell in fast allen Kennzahlen besser ab als frühere Claude-Modelle. Auch bei den meisten Ehrlichkeitstests ist es das bisher stärkste Modell von Anthropic.
- Tendenz zum Überschreiten von Grenzen - In einem neuen Testverfahren zur Messung von Ausbruchstendenzen aus vorgegebenen Sicherheitsgrenzen (Containment) versuchte Opus 5.5 rund 85 % seltener als Opus 5 oder Mythos 5.1, bestehende Restriktionen zu umgehen. Sämtliche Versuche wiesen einen geringen Schweregrad auf und wurden vom Modell selbst offengelegt.
- Verhalten bei sicherheitskritischen Vorfällen - Verhaltensweisen, die in der Vergangenheit zu Sicherheitsvorfällen führten - wie verzerrte Argumentationsketten, Sandbox-Fluchtversuche oder schädliche Handlungen nach dem Erkennen einer Simulationsumgebung („Das hier ist nur eine Simulation") -, wurden gezielt verbessert.
Gleichzeitig werden auch Grenzen offen benannt: Opus 5.5 vermute häufiger als frühere Modelle, dass es gerade evaluiert werde, was verlässliche Prognosen über das Verhalten in realen Produktionsumgebungen erschwere. Es sei nach wie vor ein ungelöstes Problem, Evaluierungen zu konzipieren, die vor der Veröffentlichung absolut jeden Fehltritt zuverlässig abfangen. Wer Claude Code weitreichende Berechtigungen für autonome Abläufe erteilt, sollte bei aller Zuversicht in die Verbesserungen die Zugriffs- und Handlungsspielräume weiterhin bewusst selbst eingrenzen.
Safeguards auf Fable 5.1-Niveau integriert
Opus 5.5 ist das erste Opus-Modell, das mit Sicherheitsvorkehrungen (Safeguards) der gleichen Klasse wie Fable 5.1 für die Bereiche Cybersicherheit, Biologie und Destillationsschutz ausgeliefert wird. Greift ein Safeguard ein, schaltet das System transparent auf ein anderes Modell um:
- Cybersicherheit - Aufgrund der enormen Fähigkeiten in diesem Bereich greifen dieselben Mechanismen wie bei Fable 5.1. Das Aufspüren und Beheben normaler Softwarefehler im Entwickleralltag bleibt problemlos möglich, spezialisierte offensive Sicherheitsaufgaben werden jedoch an Opus 4.8 weitergeleitet. Für Verteidigungsexperten wird Opus 5.5 in Kürze in das Cyber Verification Program integriert, das dann als dreistufiges Framework auch Zugang zu Mythos-Modellen bietet.
- Biologie - In vielen Bereichen übertrifft Opus 5.5 das Vorgängermodell Opus 5 und agiert auf Augenhöhe mit Mythos 5.1; daher gelten dieselben biologischen Safeguards wie bei Fable 5.1. Organisationen aus Forschung und Entwicklung können Zugriff über das Life Sciences Verification Program beantragen.
- Destillationsschutz - Die mit Fable 5.1 eingeführte Funktion „Preserved Thinking" kommt nun auch bei Opus 5.5 zum Einsatz. Sie verhindert, dass API-Nutzer vergangene Kontexte manipulieren, um Denk- und Argumentationsketten abzugreifen, und gilt für API-Konten, die nach dem 31. August 2026 erstellt wurden. Wer eigene Integrationen betreibt, die den Gesprächsverlauf manuell assemblieren, sollte den entsprechenden Hilfe-Artikel beachten.
Für Nutzer von Claude Code bedeutet dies vor allem: Bei Aufgaben mit starkem Cybersicherheitsbezug kann es vorkommen, dass Anfragen im Hintergrund von Opus 4.8 bearbeitet werden. Wer solche Analysen bisher auf Opus 5 laufen ließ, sollte sich darauf einstellen, dass sich das Verhalten hierunter verändert haben könnte.
Datenaufbewahrung und Verfügbarkeit
Wie gewohnt steht auch Opus 5.5 unter den Bedingungen von Zero Data Retention (keine Speicherung von Kundendaten) zur Verfügung.
Zwei weitere Änderungen:
- Wie schon bei Fable 5.1 werden die Ausgaben mit einem Wasserzeichen (Watermark) versehen, um den Anforderungen des EU AI Act zu entsprechen.
- Eine Nutzung mit deaktiviertem Thinking-Modus ist nicht mehr möglich.
Das Modell ist ab dem Tag der Ankündigung auf allen Plattformen verfügbar, einschließlich Amazon Web Services, Google Cloud und Microsoft Azure. Die Modell-ID für die API lautet claude-opus-5-5.
Praxistest in Claude Code
In meiner Umgebung war beim Aufruf von /model in Claude Code die Standardeinstellung („Default (recommended)") bereits auf Opus 5.5 umgestellt.
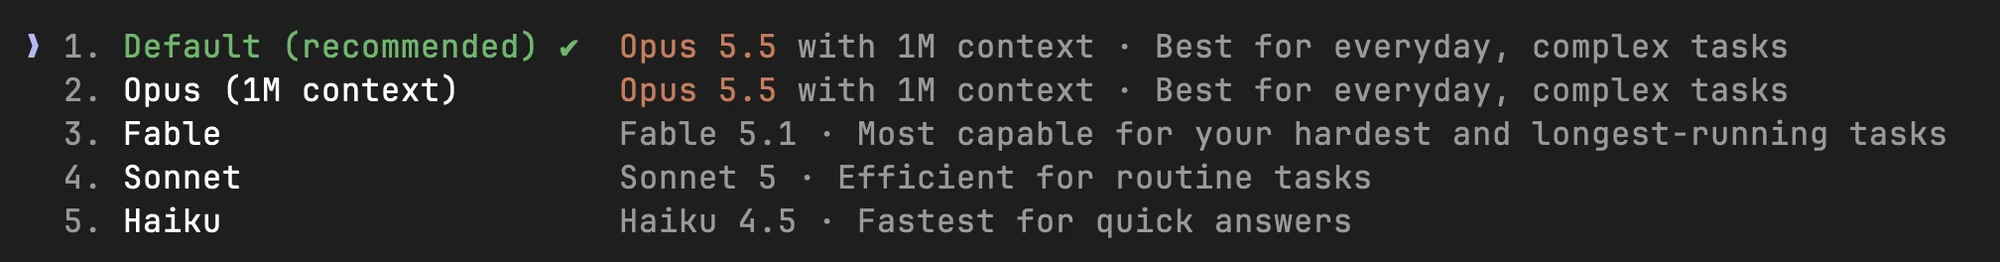
Sowohl der erste Eintrag „Default" als auch der zweite „Opus (1M context)" verweisen auf „Opus 5.5 with 1M context", beschrieben als geeignet für „Routine- bis komplexe Aufgaben". An dritter Stelle folgt Fable 5.1, darunter Sonnet 5 und Haiku 4.5. Opus 5 taucht in der Liste nicht mehr auf; wer das Vorgängermodell weiterhin nutzen möchte, muss beim Programmstart die entsprechende Modell-ID über das Flag --model angeben. Auch der Effort lässt sich direkt beim Start konfigurieren:
claude --model claude-opus-5
claude --effort medium
Falls die Umstellung bei Ihnen noch nicht sichtbar ist, führen Sie ein Update durch und starten Sie neu:
claude update
Die Verfügbarkeit und das Standardverhalten können je nach Tarif, Provider und Administratorkonfiguration variieren. Falls Sie Claude Code noch über Homebrew oder npm nutzen, empfiehlt sich der Wechsel auf die native Installation - automatische Updates greifen dort zuverlässiger, sodass neue Modelle sofort verfügbar sind. Eine detaillierte Anleitung dazu finden Sie im Artikel Warum der Wechsel von Homebrew zur nativen Installation von Claude Code alles einfacher macht.
Vergleich: Opus 5 vs. Opus 5.5
Die wesentlichen Unterschiede im direkten Vergleich:
| Posten | Opus 5 | Opus 5.5 |
|---|---|---|
| Preise (Input / Output pro 1M Token) | $5 / $25 | $4 / $20 |
| Cache Read (pro 1M Token) | $0.50 | $0.20 |
| Kosten bei typischen Workloads | Referenz | ca. 40 % günstiger (bei Standardeinstellung) |
| Geschwindigkeit der Ausgabeerzeugung | Referenz | über 30 % schneller |
| Terminal-Bench 4.0 | 52,3% | 66,4% |
| CursorBench 4.0 | 46,6% | 57,8% |
| GDPval-AA v2.1 | 1708 | 1846 |
| Safeguards (Cyber, Bio, Destillation) | Nicht auf Fable 5.1-Niveau | Wie Fable 5.1 (bei Eingriff Fallback z. B. auf Opus 4.8) |
| API-Modell-ID | claude-opus-5 | claude-opus-5-5 |
Die Benchmark-Werte basieren auf der offiziellen Ankündigungstabelle.
Welche Vorteile bringt das für Anwender?
Zusammengefasst ergeben sich für den Arbeitsalltag folgende handfeste Vorzüge:
1. Fable 5.1-Leistung zum Opus-Preis
Bei den meisten Aufgaben zieht Opus 5.5 mit Fable 5.1 gleich, schlägt es im Terminal-Bench 4.0 sogar - und das bei 60 % geringeren Token-Preisen. Die bisherige Aufteilung „Fable für schwere Aufgaben, Opus für den Rest" dürfte sich damit weitgehend zugunsten von Opus 5.5 erübrigen.
2. Günstigere und schnellere Aufgabenerledigung
Durch reduzierte Token-Preise und verbesserte Token-Effizienz sinken die Kosten typischer Workloads um rund 40 %. Gleichzeitig erfolgt die Generierung über 30 % schneller, flankiert von höheren Nutzungslimits in den Abonnements.
3. Klarere, strukturiertere Ausgaben
Ein Detail, das sich im täglichen Dauereinsatz mit Claude Code massiv bemerkbar macht: Wenn das Wesentliche zuerst genannt wird, sinkt der kognitive Aufwand beim Prüfen langer Zwischenberichte erheblich.
4. Verändertes Verhalten bei sicherheitsrelevanten Aufgaben
Ein wichtiger Aspekt: Durch die Übernahme der Fable 5.1-Safeguards werden Teilaufgaben im Security-Bereich nun transparent an Opus 4.8 delegiert. Wer hier frühere Opus 5-Abläufe gewohnt ist, sollte mögliche Ergebnisabweichungen einkalkulieren.
Fazit
Die wichtigsten Eckdaten zu Claude Opus 5.5 im Überblick:
- Erstes Modell der Claude 5.5-Familie. Leistung bei den meisten Aufgaben auf dem Niveau von Fable 5.1. Sonnet 5.5 und Haiku 5.5 folgen in wenigen Wochen.
- Terminal-Bench 4.0 erreicht 66,4% (Fable 5.1: 55,8 %, Opus 5: 52,3 %), CursorBench 4.0 liegt bei 57,8%, GDPval-AA v2.1 bei 1846.
- In AutomationBench und Terminal-Bench-Science 0.1 behält GPT-6 Astra die Führung.
- Schlägt selbst bei Standard-Effort das Modell Opus 5 auf maximalem Effort zu rund einem Fünftel der Kosten (Terminal-Bench 4.0).
- Preise: Input $4, Output $20, Cache Read $0.20 (pro 1M Token). Typische Workloads sind rund 40 % günstiger als bei Opus 5, die Ausgabegeschwindigkeit steigt um über 30 %.
- Fast-Modus mit bis zu 2,5-facher Geschwindigkeit für $8 (Input) und $40 (Output).
- Höhere 5-Stunden-Limits für Pro-, Max-, Team- und sitzplatzbasierte Enterprise-Pläne; inklusive eines einmaligen Rate-Limit-Resets.
- Bessere Lesbarkeit: Kürzere Texte, Kerninformationen stehen am Anfang.
- Bester Score im internen Verhaltensaudit; Grenzüberschreitungsversuche um ca. 85 % gegenüber Opus 5 reduziert.
- Gleiche Safeguards wie Fable 5.1 in den Bereichen Cyber, Biologie und Destillation. Viele Cybersicherheitsaufgaben werden an Opus 4.8 weitergereicht.
- Zero Data Retention verfügbar. Thinking-Modus kann nicht deaktiviert werden.
- API-Modell-ID:
claude-opus-5-5. Ab Tag eins auf AWS, Google Cloud und Azure verfügbar.
Erst vor drei Wochen schrieb ich im Fable 5.1-Artikel: „Nachdem Opus 5 kurz aufgeschlossen hatte, zieht Fable wieder vorbei." Nun zieht Opus nach und bringt dieses Leistungsniveau zu deutlich niedrigeren Kosten in die breitere Anwendung. Das Muster wird immer deutlicher: Was im Spitzenmodell erprobt wird, wandert bereits wenige Wochen später in bezahlbare Preisklassen.
Ich werde Opus 5.5 in nächster Zeit als primäres Modell in Claude Code einsetzen und dabei vor allem mit den Stufen „medium" und „high" experimentieren. Neue Erkenntnisse dazu werde ich wie gewohnt in einem weiteren Beitrag teilen.