Claude Sonnet 5.5 ist da. Zum gleichen Preis wie Sonnet 5, über 30 % schneller und reicht an Opus 5.5 heran.
Inhaltsverzeichnis
Hallo. Am 28. September 2026 (US-amerikanischer Zeit) hat Anthropic „Claude Sonnet 5.5" angekündigt. Nach dem Opus 5.5 der vergangenen Woche ist dies das zweite Modell der Claude 5.5-Familie.
Zu Beginn der offiziellen Ankündigung wird es als klares Upgrade gegenüber Sonnet 5 vorgestellt: Es ist über 30 % schneller und bei vielen Aufgaben bis zu 30 % günstiger. Die Preisstruktur selbst hat sich gegenüber Sonnet 5 nicht geändert. Die Erklärung lautet, dass die Kosten sinken, weil dieselbe Aufgabe zum selben Einheitspreis mit weniger Token erledigt werden kann.
Auch die Positionierung ist eindeutig. Komplexe Aufgaben, die ein sorgfältiges Urteilsvermögen erfordern, übernimmt Opus 5.5; alltägliche Aufgaben mit klar definiertem Umfang, Bugfixes sowie die Erstellung von Dokumenten, Präsentationen und Tabellenkalkulationen fallen Sonnet 5.5 zu. Offiziell wird Sonnet 5.5 als „schnelleres und günstigeres" Modell positioniert, das Opus 5.5 ergänzt.
In diesem Artikel fassen wir auf der Grundlage der offiziellen Ankündigung und Beiträgen des offiziellen Claude-Accounts auf X zusammen, was sich bei Sonnet 5.5 geändert hat und wie man es am besten im Zusammenspiel mit Opus 5.5 einsetzt.
Die wichtigsten Punkte der Ankündigung
Die offizielle Ankündigung unterteilt die Verbesserungen gegenüber Sonnet 5 in fünf Bereiche:
- Leistung - Terminal-Bench 4.0 stieg von 10,3 % bei Sonnet 5 auf 70,6 %. Bei GDPval-AA liegt es fast gleichauf mit Opus 5.5. Zudem ist es das erste Sonnet-Modell, das „Pokémon Rot" allein anhand von Screenshots durchgespielt hat.
- Zusammenarbeit - Genau wie Opus 5.5 schreibt es verständlicher als die Vorgängergeneration. Dank seiner Schnelligkeit eignet es sich hervorragend für schnelle Iterationen bei Aufgaben von moderater Komplexität.
- Kosten - Die Preise bleiben dieselben wie bei Sonnet 5. Da für dieselbe Aufgabe deutlich weniger Token verbraucht werden, sinken die Kosten pro Aufgabe um bis zu 30 %.
- Geschwindigkeit - Die Ausgabegenerierung ist über 30 % schneller als bei Sonnet 5 - damit ist es das bisher schnellste Sonnet.
- Alignment und Sicherheit - Bei automatisierten Verhaltensprüfungen schneidet es in fast allen Metriken gleichwertig oder besser als Sonnet 5 ab. Als erstes Sonnet-Modell wird es mit Cybersecurity-Safeguards veröffentlicht, die denen des Spitzenmodells ähneln.
Das verbleibende Mitglied der Familie, Claude Haiku 5.5, das für die Massenverarbeitung und kostenkritische Einsatzzwecke gedacht ist, soll innerhalb weniger Wochen folgen.
Benchmarks: Deutlicher Zuwachs gegenüber Sonnet 5 und nah an Opus 5.5
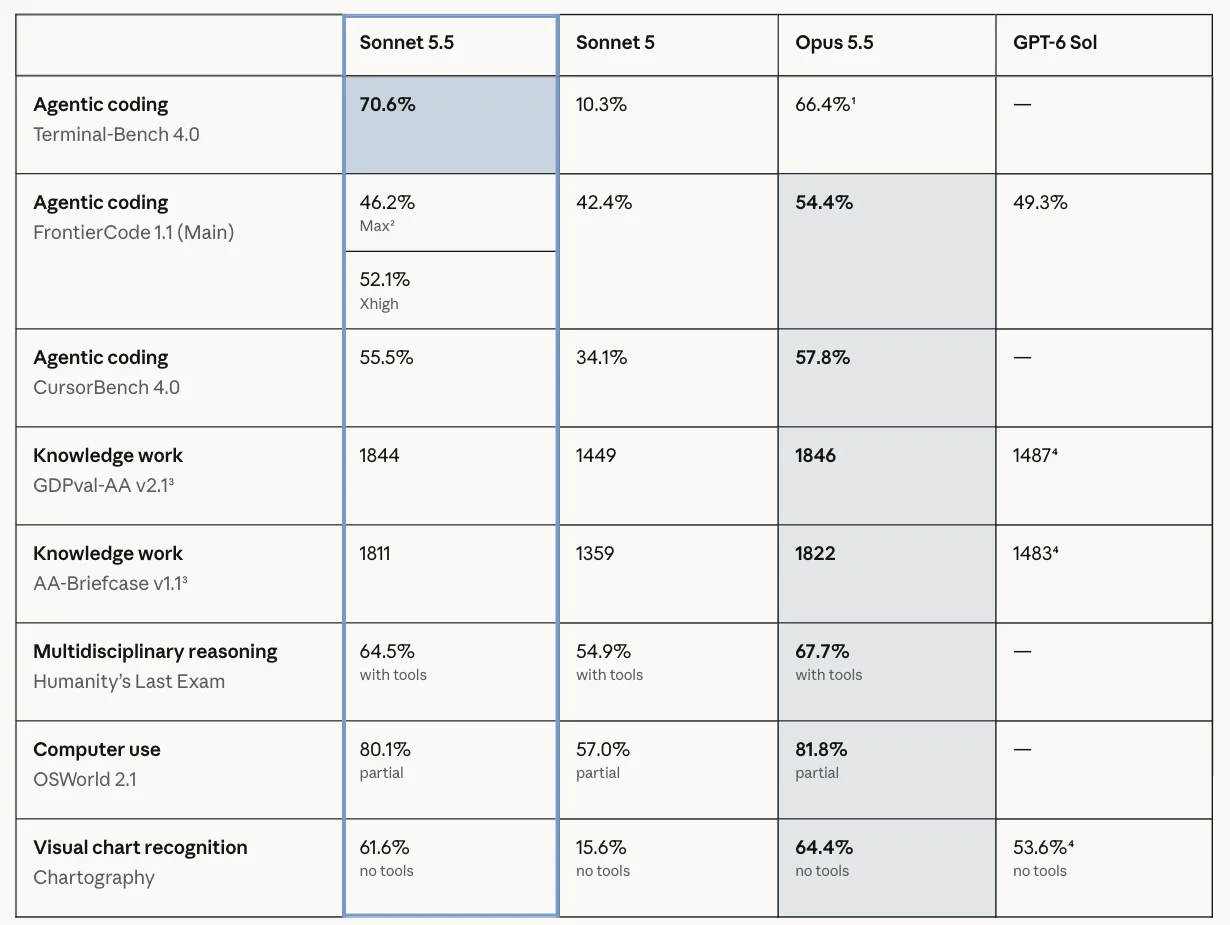
Hier ist die von Anthropic veröffentlichte Vergleichstabelle:
 (Quelle: Introducing Claude Sonnet 5.5 \ Anthropic)
Die wichtigsten Werte im Überblick:
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (Agentenbasiertes Coden im Terminal) | 70,6 % | 10,3 % | 66,4 % | Nicht angegeben |
| FrontierCode 1.1 Main (Agentenbasiertes Coden) | 46,2 % (Max) / 52,1 % (Xhigh) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 (Agentenbasiertes Coden) | 55,5 % | 34,1 % | 57,8 % | Nicht angegeben |
| GDPval-AA v2.1 (Wissensarbeit, Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Langwierige Wissensarbeit, Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (Interdisziplinäres Denken, mit Tools) | 64,5 % | 54,9 % | 67,7 % | Nicht angegeben |
| OSWorld 2.1 (Computer-Bedienung, partiell) | 80,1 % | 57,0 % | 81,8 % | Nicht angegeben |
| Chartography (Diagramminterpretation, ohne Tools) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
In allen Bereichen gibt es deutliche Zuwächse gegenüber Sonnet 5, doch besonders sticht Terminal-Bench 4.0 hervor. Der Sprung von 10,3 % bei Sonnet 5 auf 70,6 % ist ein gewaltiger Dimensionswechsel und übertrifft auf dem Papier sogar die 66,4 % von Opus 5.5. Auch Chartography, das das Lesen von Diagrammen misst, stieg von 15,6 % auf 61,6 %, was die enormen Fortschritte beim Bildverständnis verdeutlicht.
Der GDPval-AA v2.1 für Wissensarbeit liegt bei 1844 - nur 2 Punkte hinter den 1846 von Opus 5.5. GDPval-AA ist ein Benchmark, der auf realer Arbeit aus 44 Berufsfeldern und 9 Hauptbranchen basiert; hier hat sich Sonnet gegenüber Version 5 um rund 400 Punkte gesteigert.
Abgesehen von Terminal-Bench 4.0 liegt Opus 5.5 jedoch in allen anderen Kategorien vorn. Anthropic weist ausdrücklich darauf hin, dass Benchmarks nur eine Facette der Modellfähigkeiten erfassen und Opus 5.5 bei komplexen, ergebnisoffenen Aufgaben, die kontinuierliches Urteilsvermögen erfordern, deutlich überlegen ist. Zudem sollte man im Hinterkopf behalten, dass die Zahlen von Anthropic stammen und nicht von unabhängigen Dritten verifiziert wurden.
Hinweise zur Interpretation der Zahlen
In den Fußnoten finden sich einige wichtige Hinweise:
- Das Ergebnis von Opus 5.5 bei Terminal-Bench 4.0 basiert auf der Einstellung „Xhigh effort", bei der der beste Wert erzielt wurde.
- FrontierCode bewertet, ob Änderungen ohne menschliches Eingreifen direkt gemergt werden können, und zieht Punkte ab, wenn Änderungen über den vorgegebenen Umfang hinausgehen - selbst wenn sie qualitativ hochwertig sind. Bei Sonnet 5.5 war der Score bei Max effort niedriger als bei Xhigh. Dies wird damit erklärt, dass bei Max der Claude-Code-Skill „code-review" (der Reviews auf viele Sub-Agenten aufteilt) häufiger ausgeführt wurde, was zu Timeouts und ungefragten Zusatzanpassungen führte.
- GDPval-AA und AA-Briefcase wurden von Artificial Analysis mit einer Vorabversion von Sonnet 5.5 durchgeführt, die einen Bug aufwies, der bei Anfragen mit Structured Outputs zu schlechteren Antworten führte (inzwischen behoben). Die Auswirkungen gelten, falls überhaupt vorhanden, als gering und drückten das Ergebnis eher nach unten.
Der Vorfall bei FrontierCode liefert einen wertvollen Hinweis für die Erhöhung des Effort-Levels in Claude Code: Ein höherer Effort führt zwar dazu, dass das Modell gründlicher arbeitet, verleitet es jedoch mitunter dazu, über das eigentliche Ziel hinauszuschießen. Wie schon im Artikel zu Opus 5.5 beschrieben, wo der Score bei Terminal-Bench 4.0 bei Xhigh seinen Höhepunkt erreichte und bei Max leicht abfiel, zeigt sich auch hier in den Fußnoten: „Mehr Effort ist nicht automatisch immer besser."
Selbst bei niedrigem Effort besser als der Spitzenwert von Sonnet 5
Dies ist vermutlich der für die Praxis relevanteste Punkt der gesamten Ankündigung: Laut Anthropic übertrifft Sonnet 5.5 bei mehreren Benchmarks bereits mit der Einstellung „Low" oder „Medium" den Maximalwert von Sonnet 5 - und das bei rund einem Zehntel der Kosten pro Aufgabe.
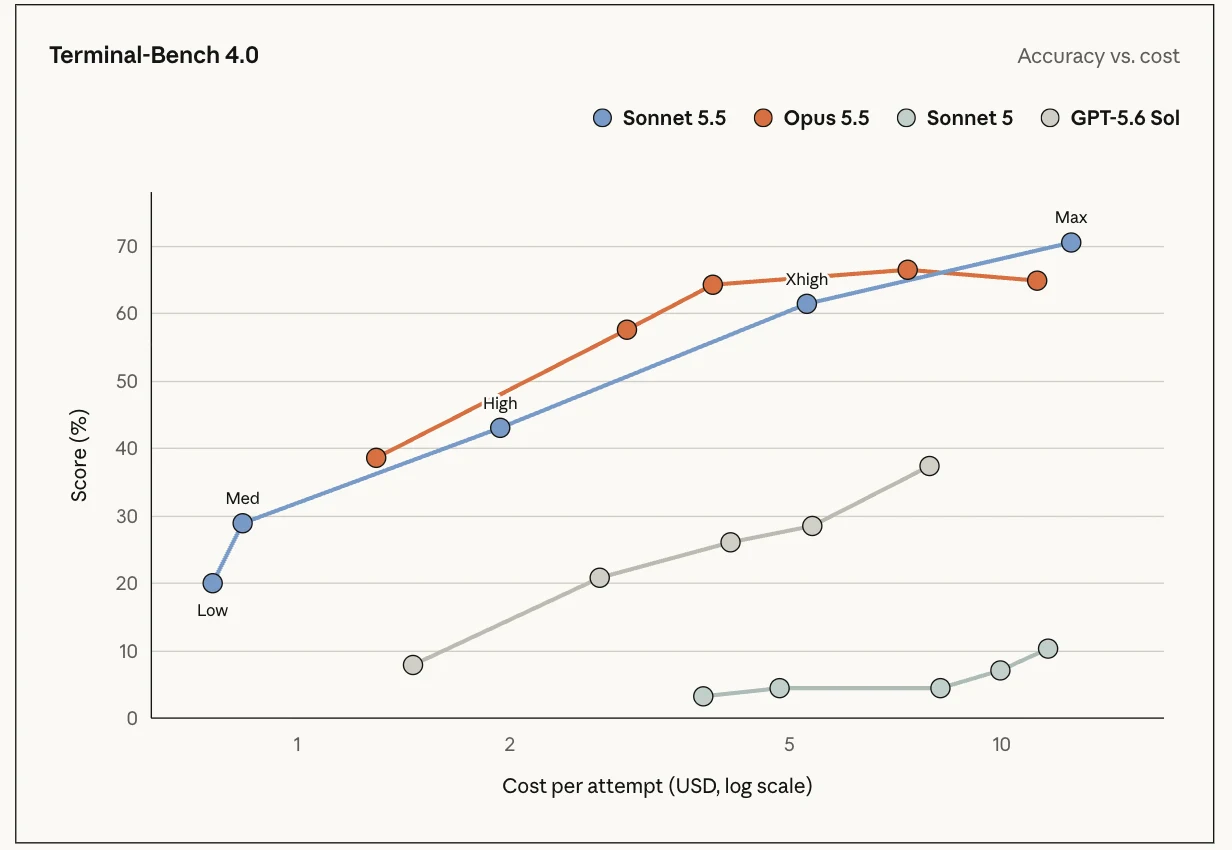
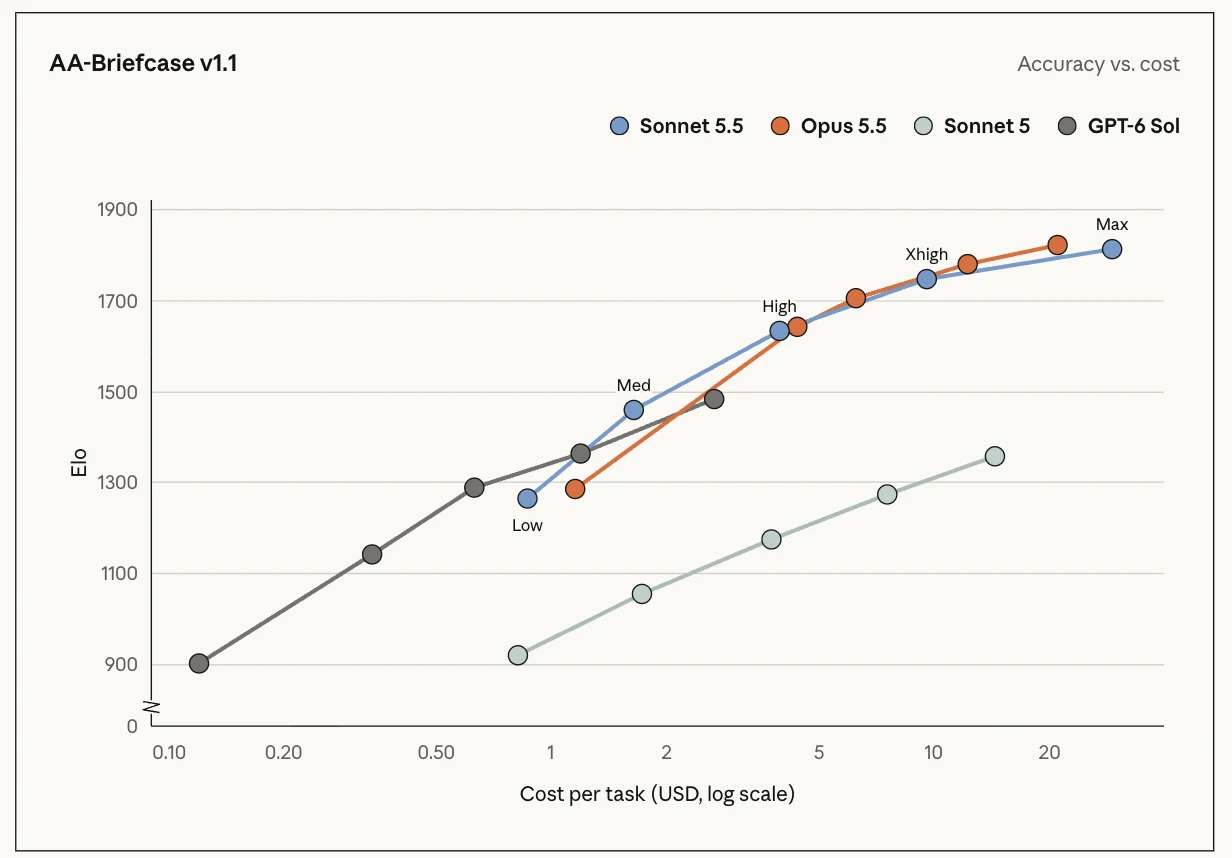
„Effort" ist ein Parameter, der festlegt, wie intensiv das Modell vor der Antwort nachdenkt, wählbar in fünf Stufen: Low / Medium / High / Xhigh / Max. Je höher die Stufe, desto tiefer denkt das Modell nach, was allerdings mehr Token und Zeit beansprucht; je niedriger, desto schneller und günstiger ist es. In den offiziellen Diagrammen sind die Kosten pro Aufgabe auf der horizontalen Achse (logarithmische Skala) und der Score auf der vertikalen Achse abgetragen, wobei die Messpunkte der einzelnen Effort-Stufen durch Linien verbunden sind. Je weiter oben links ein Punkt liegt, desto „günstiger und leistungsfähiger" ist das Modell.
 (Quelle: Introducing Claude Sonnet 5.5 \ Anthropic)
Im Diagramm zu Terminal-Bench 4.0 verharrt die Kurve von Sonnet 5 selbst beim höchsten Effort bei rund 10 % (bei etwa 12 $ pro Durchlauf). Im Gegensatz dazu erreicht Sonnet 5.5 bei „Medium" - dem Standardwert in den Claude-Apps - bereits etwa 29 % (bei ca. 0,80 $). Wie offiziell beschrieben, übertrifft es damit den Spitzenwert von Sonnet 5 bei weniger als einem Zehntel der Kosten deutlich.
Das Verhältnis zu Opus 5.5 variiert hingegen je nach Effort. Bis etwa zur Stufe „High" liegt die Kurve von Opus 5.5 darüber. Die 70,6 % erreichte Sonnet 5.5 erst bei „Max" (bei rund 13 $). Opus 5.5 kommt bei „Xhigh" (rund 7,50 $) auf 66,4 %; auch wenn Sonnet 5.5 also bei Terminal-Bench 4.0 an Opus 5.5 vorbeizieht, hat dies seinen Preis.
 (Quelle: Introducing Claude Sonnet 5.5 \ Anthropic)
AA-Briefcase v1.1 ist ein neuer Benchmark von Artificial Analysis für zeitintensive Wissensarbeit. Sonnet 5.5 erzielt hier bei „Medium" rund 1460 (ca. 1,60 $) und schlägt damit den Bestwert von Sonnet 5 (1359, ca. 14 $) bei rund einem Neuntel der Kosten. Bemerkenswert ist, dass die Kurven von Sonnet 5.5 und Opus 5.5 ab der Stufe „High" praktisch deckungsgleich verlaufen.
Der Verlauf dieses Diagramms bietet einen hervorragenden Leitfaden für die Praxis. Anthropic erklärt, dass Sonnet 5.5 Opus 5.5 am besten bei niedrigen Effort-Stufen ergänzt, während es bei hohem Effort zu ähnlichen Kosten vergleichbare Resultate erzielen kann. Die sinnvollste Aufteilung lautet demnach: Schnelle und kostengünstige Arbeitsabläufe erledigt man mit Sonnet 5.5 auf „Low" oder „Medium"; Aufgaben, die tiefgründiges Nachdenken verlangen, übergibt man Opus 5.5.
Die Diagrammwerte sind von mir abgelesene Schätzwerte; die Messungen selbst stammen von Anthropic. Zudem wird offiziell hervorgehoben, dass Sonnet 5.5 bei FrontierCode mit der Standardeinstellung der Claude-Plattform („High") zum Spitzenwert von GPT-6 Sol aufschließt - und das bei rund einem Fünftel der Kosten.
Standard-Effort: Medium für Claude Code und Apps
Laut Angaben von Anthropic ist der Standard-Effort bei Claude Code und den Claude-Apps auf „Medium" eingestellt, auf der Claude-Plattform (API) hingegen auf „High". Niedrigere Einstellungen arbeiten schnell und token-sparend und eignen sich für Routineaufgaben; höhere Einstellungen lassen das Modell länger nachdenken und seine Arbeit sorgfältiger überprüfen.
Schnelleres Verständnis von Codebases beim Programmieren
Als Bereich mit den auffälligsten Fortschritten hebt Anthropic das Coding hervor. Bei FrontierCode liegt Sonnet 5.5 bei identischem „High effort" um 10 Punkte vor Sonnet 5, während die Kosten pro Aufgabe rund ein Fünfzehntel betrugen. Auch bei CursorBench, das anhand realer Cursor-Sitzungen evaluiert, liegt der Höchstwert nur etwa zwei Punkte hinter Opus 5.5.
Frühe Tester heben übereinstimmend das schnelle Erfassen von Codebases und die Effizienz hervor. Im direkten Vergleich zeigte sich, dass Sonnet 5.5 Tool-Aufrufe häufiger bündelt, wodurch die Schrittanzahl und die Kosten sanken. Hier einige Auszüge aus den Rückmeldungen:
- Epic Games lobt, dass das Modell dieselben Qualitätsstandards erfüllt, die man von Flaggschiffmodellen erwartet. Beim Systemdesign von Gameplay-Mechaniken habe es Codebases mit zehntausenden Zeilen bewältigt und mehrstündige Aufgaben erfolgreich abgeschlossen.
- CodeRabbit berichtet, dass sowohl das übermäßige Ausweichen auf die Websuche als auch der hohe Token-Verbrauch - zwei Kritikpunkte an Sonnet 5 - behoben wurden. Man plane, einfache bis mittelschwere Reviews nun auf Sonnet 5.5 zu migrieren.
- Base44 berichtet, dass das Modell beim Erstellen von 118 realen Anwendungen eine mit Opus 5 vergleichbare Qualität erreichte. Die durchschnittliche Anzahl der Iterationen pro Build lag bei 3,6 - weniger als die Hälfte der 7,7 Iterationen von Opus 5.
- Lovable gibt an, dass bei internen Coding-Evaluierungen die Tool-Aufrufe bis zum Abschluss einer Aufgabe um ein Drittel und die Shell-Ausführungen um etwa die Hälfte sanken.
Ein weiterer Kommentar des Spieleentwicklers Kevin Ngo fasst die Arbeitsteilung mit Opus 5.5 treffend zusammen:
When Claude Opus 5.5 sets the architecture and general framework for a game, I would feel confident in letting Sonnet 5.5 implement it.
Wenn Opus 5.5 die Architektur und den Rahmen vorgibt, kann man die Implementierung beruhigt Sonnet 5.5 anvertrauen. In Claude Code bietet sich damit ein Workflow an, bei dem Opus 5.5 die Planung übernimmt und Implementierungen sowie Detailanpassungen an Sub-Agenten mit Sonnet 5.5 delegiert werden.
Wissensarbeit: Gespür für Design wird gelobt
In der Wissensarbeit liegt Sonnet 5.5 bei der Bedienung von Computern und der Interpretation von Diagrammen nah an Opus 5.5; bei langwieriger Wissensarbeit übertrifft es Sonnet 5 und GPT-6 Sol deutlich.
Als schwer in Zahlen zu fassende Neuerung hebt Anthropic das Gespür für Design hervor: Das Modell verfeinere Benutzeroberflächen und erstelle Präsentationen anhand von Vorlagen, die kaum noch manueller Nacharbeit bedürfen. In einem internen Test wurden dem Modell Quartalszahlen, das Transkript einer Analystenkonferenz eines börsennotierten Unternehmens und eine Folienvorlage übergeben, um einen zehnseitigen Performance-Review zu erstellen. Zwei Experten stuften den allerersten Entwurf als direkt versandbereit ein.
Auch auf X wurde ein Video geteilt, das zeigt, wie Sonnet 5 und Sonnet 5.5 denselben Prompt bearbeiten: „Stelle in einer einzigen HTML-Datei dar, wie Wind Sanddünen formt." Auf der offiziellen Website finden sich zudem Vergleiche zu Simulationen eines Schwarms aus 400 Staren oder einer Uhr, die aus 24 kleineren Uhren besteht.
Hier einige Rückmeldungen früher Tester aus diesem Bereich:
- Slack berichtet, dass Sonnet 5.5 bei identischen Prompts in fast allen Offline-Slackbot-Tests besser abschnitt als Sonnet 5 - mit weniger Schritten und etwa 14 % weniger Ausgabe-Token.
- Box lobt, dass das Modell nun Quelldokumente erneut gegenprüft, um Daten zu verifizieren, und Fehler bemerkt, die Sonnet 5 entgangen waren. Es sei präziser, 2,4-mal schneller und verbrauche in der Summe 12 % weniger Token.
- Die Investmentgesellschaft Balyasny Asset Management stellte fest, dass Sonnet 5.5 bei 2.441 Finanzaufgaben Sonnet 5 übertraf - bei einem Token-Verbrauch von rund 121.000 Token pro Antwort im Vergleich zu ca. 497.000 Token bei Sonnet 5.
Gerade der Unterschied beim Token-Verbrauch sticht in den Berichten der Unternehmen hervor. Selbst bei identischen Listenpreisen dürfte die tatsächliche Rechnung spürbar niedriger ausfallen.
Preise: Identisch mit Sonnet 5, halb so teuer wie Opus 5.5
Die Preise gestalten sich wie folgt:
| Posten (pro 1M Token) | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Input | 2 $ | 4 $ |
| Output | 10 $ | 20 $ |
| Cache Read | 0,20 $ | 0,20 $ |
| Cache Write | 2,50 $ | 5 $ |
Input und Output kosten exakt die Hälfte von Opus 5.5. Cache Read (das Auslesen wiederverwendeter Inputs) liegt nach der Preissenkung von Opus 5.5 bei beiden Modellen gleichauf bei 0,20 $.
Da der Einheitspreis derselbe wie bei Sonnet 5 ist, pro Aufgabe jedoch weniger Token verbraucht werden, sinken die Kosten pro Aufgabe in internen Tests um bis zu 30 %. Die Ausgabegenerierung ist zudem über 30 % schneller - ein Effizienzgewinn, der auch in den Demovideos auf der Website sofort ins Auge fällt.
Sicherheit und Alignment
Das Sicherheitskapitel beginnt mit dem Hinweis: „Sonnet 5.5 verschiebt nicht die Grenzen der absoluten Spitzenleistung unserer Modelle." Daher konzentrierte sich die Alignment-Evaluierung auf allgemeine Risiken, die unabhängig vom Leistungsniveau gelten: Handlungen gegen die Interessen der Nutzer, Irreführung von Nutzern und Unterstützung bei schwerwiegendem Missbrauch.
Die Kernpunkte der Evaluierung:
- Automatisierte Verhaltensprüfungen - In Audits mit rund 1.850 Szenarien schnitt Sonnet 5.5 bei fast allen Indikatoren für Alignment, Missbrauchsresistenz und Ehrlichkeit gleich gut oder besser als Sonnet 5 ab.
- Containment-Prüfungen - Die Wahrscheinlichkeit von Sandbox-Ausbruchsversuchen liegt nahe am Bestwert von Opus 5.5; die Neigung, die Grenzen von Containern auszuloten, ist die geringste unter allen Modellen des Anbieters.
- Gesamtergebnis - Zwar schnitt Opus 5.5 im Gesamtaudit minimal besser ab, doch fanden sich keinerlei Hinweise darauf, dass Sonnet 5.5 Ziele verfolgt, die den Absichten des Nutzers zuwiderlaufen.
Anthropic betont jedoch auch, dass keine Evaluierung jeden potenziellen Fehler lückenlos aufdecken kann und Sonnet 5.5 noch unentdeckte Tendenzen aufweisen könnte. Aus diesem Grund wird es mit den folgenden Sicherheitsvorkehrungen kombiniert.
Cybersecurity-Safeguards auf das Niveau von Opus 5.5 angehoben
Sonnet 5.5 verfügt über Sicherheitsmechanismen (Safeguards) in drei Bereichen. Dies bedeutet nicht, dass Sonnet zuvor ungeschützt war: Bei der Ankündigung von Sonnet 5 im Juni war das Modell standardmäßig mit denselben Cybersecurity-Safeguards wie Opus 4.7 und 4.8 versehen worden. Da das Cyber-Risiko als gering eingestuft wurde, waren die Beschränkungen lockerer als bei Fable 5. Mit Sonnet 5.5 wird dieser Schutz nun auf das Niveau von Opus 5.5 angehoben.
- Cybersicherheit - Da die Cyber-Fähigkeiten im Vergleich zu Sonnet 5 drastisch gestiegen sind und mit Opus 5 konkurrieren, wird Sonnet 5.5 mit denselben Safeguards wie Opus 5.5 veröffentlicht. Das Finden und Beheben von Bugs im normalen Entwicklungsprozess ist uneingeschränkt möglich; stuft das System eine Aufgabe jedoch als hochriskante Cybersecurity-Aktivität ein, schaltet es spürbar auf Sonnet 5 zurück. Für Sicherheitsexperten auf Verteidigerseite wird in Kürze die Bewerbung für das erweiterte Cyber Verification Program geöffnet, das schrittweisen Zugriff auf erweiterte Funktionen von Sonnet 5.5, Opus 5.5 und Mythos-Modellen bietet.
- Biologie - Die biologischen Safeguards entsprechen denen von Sonnet 5. Sie zielen auf schädliche Anfragen ab und beeinträchtigen den Großteil der Forschungs-, Bildungs- und klinischen Arbeit nicht. Anthropic merkt jedoch an, dass vereinzelt Anfragen aus der Mikrobiologie und Virologie fälschlicherweise blockiert werden können. Organisationen, die das Modell für breitere biologische Arbeiten nutzen möchten, können sich für das Life Sciences Verification Program bewerben.
- Schutz vor Destillation - Als erstes Sonnet-Modell verfügt es über Sicherheits-Klassifikatoren gegen die Extraktion von Reasoning-Prozessen, um Destillationsangriffe über großflächige Fake-Accounts zu unterbinden. Zudem wurde die Reichweite von preserved thinking ausgeweitet, sodass Denkprozesse von Claude nicht mehr von dem Account getrennt werden können, der sie erzeugt hat.
Vom Destillationsschutz dürften die meisten Entwickler nichts bemerken. Wer jedoch Konversationen über mehrere Accounts hinweg überträgt - etwa bei einem Accountwechsel während einer aktiven Claude-Code-Sitzung -, könnte betroffen sein. In diesem Fall empfiehlt sich ein Blick in die verlinkte Dokumentation.
Für Claude-Code-Nutzer ist vor allem relevant, dass sicherheitsnahe Arbeiten teilweise auf Sonnet 5 umgeleitet werden. Normale Bugfixes sind davon unberührt, bei der Untersuchung potenziell kritischer Schwachstellen sollte man eine Verhaltensänderung jedoch einkalkulieren.
Wichtige Änderung bei API-Migration: Thinking-Konfiguration
Wie frühere Versionen kann Sonnet 5.5 unter Einhaltung von Zero Data Retention (keine Speicherung von Daten) genutzt werden. Das Modell ist ab dem Tag der Ankündigung auf allen Plattformen verfügbar, einschließlich Amazon Web Services, Google Cloud und Microsoft Azure. Die Modell-ID für die API lautet claude-sonnet-5-5.
Wer über die API von Sonnet 5 migriert, muss aufpassen, falls Thinking (das Nachdenken vor der Ausgabe) deaktiviert war. Laut dem Migrationsleitfaden führt der bisherige Parameter zur Deaktivierung (thinking: {"type": "disabled"}) bei Sonnet 5.5 zu einem 400-Fehler. Stattdessen muss der neue Parameter between_tools verwendet werden.
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 16000,
  "thinking": {"type": "between_tools"},
  "output_config": {"effort": "high"},
  "messages": [{"role": "user", "content": "..."}]
}
between_tools ist die niedrigste Thinking-Einstellung bei Sonnet 5.5: Es denkt vor der finalen Antwort nicht nach, gibt jedoch Thinking-Blöcke zwischen einzelnen Tool-Aufrufen zurück. Der Migrationsleitfaden nennt weitere Einschränkungen:
- Gültige Effort-Werte sind nur
low,mediumundhigh; eine Kombination mitxhighodermaxführt zu einem 400-Fehler. - Der Effort kann nicht mitten in einer Konversation geändert werden. Wer den Effort von Turn zu Turn anpassen möchte, muss Adaptive Thinking verwenden.
- Ältere SDKs, die
between_toolsnoch nicht definieren, schlagen bei Type-Checks in Python und TypeScript fehl. Hier muss das SDK aktualisiert oder der Wert als raw JSON übergeben werden.
Zudem ist Thinking bei Sonnet 5.5 standardmäßig aktiviert, wenn der Parameter thinking nicht explizit gesetzt wird. Bestehender Code, der zuvor ohne Thinking lief, sollte auf folgende Punkte überprüft werden:
- Da ein
thinking-Block am Anfang der Antwort stehen kann, sollte nicht blind aufcontent[0].textzugegriffen, sondern der Block-typeausgewertet werden. - In Tool-Call-Schleifen müssen alle
thinking-Blöcke (auch leere) unverändert zurückgesendet werden. max_tokensschließt die Denkprozesse mit ein. Da Thinking-Token als Ausgabe-Token abgerechnet werden, sollte das Limit gegebenenfalls angehoben werden.
Der Migrationsleitfaden beschreibt auch, wie die Migration mittels /claude-api migrate in Claude Code über den integrierten Claude-API-Skill automatisiert werden kann. Das Tool ersetzt Modell-IDs, korrigiert ungültige Parameter, passt den Effort an und erstellt eine Checkliste mit Punkten, die manuell geprüft werden müssen.
Ausprobieren in Claude Code
In meiner Umgebung mit Claude Code (Version 2.1.284) verwies der Modell-Alias sonnet bereits auf claude-sonnet-5-5. Beim Start lässt sich das Modell über beide Befehle aufrufen:
claude --model sonnet
claude --model claude-sonnet-5-5
Wie die Diagramme zeigen, liegt die Stärke von Sonnet 5.5 in den geringen Kosten bei moderatem Effort. Es bietet sich daher an, Routine-Bugfixes oder kleinere Features zunächst mit dem Standard-Effort „Medium" zu testen.
Falls bei Ihnen noch nicht Sonnet 5.5 verwendet wird, prüfen Sie zunächst mit claude --version Ihre Version und führen Sie gegebenenfalls ein Update mit anschließendem Neustart durch:
claude update
Die Verfügbarkeit und das Standardverhalten können je nach Plan, Provider und Administratorkonfiguration variieren. Falls Sie Claude Code noch über Homebrew oder npm nutzen, ist dies ein guter Zeitpunkt für den Wechsel zur nativen Installation: Diese unterstützt automatische Updates, sodass neue Modelle sofort verfügbar sind. Eine detaillierte Anleitung finden Sie unter Claude Code を Homebrew からネイティブインストールに切り替えたら快適になった話.
Vergleich: Sonnet 5 vs. Sonnet 5.5
Die wichtigsten Unterschiede im Überblick:
| Kategorie | Sonnet 5 | Sonnet 5.5 |
|---|---|---|
| Preise (Input/Output pro 1M Token) | 2 $ / 10 $ | 2 $ / 10 $ (Unverändert) |
| Kosten pro Aufgabe | Basis | Bis zu 30 % günstiger |
| Ausgabegeschwindigkeit | Basis | Über 30 % schneller |
| Terminal-Bench 4.0 | 10,3 % | 70,6 % |
| CursorBench 4.0 | 34,1 % | 55,5 % |
| GDPval-AA v2.1 | 1449 | 1844 |
| Cybersecurity-Safeguards | Wie Opus 4.7/4.8 (lockerer als Fable 5) | Wie Opus 5.5 (Umschaltung auf Sonnet 5 bei Intervention) |
| Thinking deaktivieren | disabled | between_tools |
| API-Modell-ID | claude-sonnet-5 | claude-sonnet-5-5 |
Die Benchmark-Zahlen basieren auf der Vergleichstabelle der offiziellen Ankündigung.
Der Mehrwert für Anwender
Fassen wir zusammen, was diese Änderungen für den Arbeitsalltag bedeuten:
1. Deutlich mehr Leistung zum selben Preis
Terminal-Bench 4.0 springt von 10,3 % auf 70,6 %, und GDPval-AA schließt praktisch zu Opus 5.5 auf. Da die Preise identisch geblieben sind, genügt bei Standardeinstellungen ein simpler Austausch der Modell-ID. In API-Setups, die Thinking deaktiviert haben, ist die oben beschriebene Anpassung erforderlich.
2. Enorm stark bei niedrigem Effort
Mit den Einstellungen „Low" oder „Medium" übertrifft Sonnet 5.5 das Maximum von Sonnet 5 bei etwa einem Zehntel der Kosten. Dieser Hebel macht sich vor allem bei Workflows mit hoher Frequenz bemerkbar - etwa bei Sub-Agenten oder umfangreichen Batch-Verarbeitungen.
3. Klarere Rollenverteilung mit Opus 5.5
Da Sonnet 5.5 bei hohem Effort in einigen Benchmarks ähnliche Ergebnisse zu vergleichbaren Kosten wie Opus 5.5 liefert, ist die Aufteilung nun intuitiver: Für tiefe Überlegungen nutzt man Opus 5.5; für schnelle, kostengünstige Ausführungen reicht Sonnet 5.5 bei niedrigem Effort.
4. Anpassungen bei Cybersecurity-Tasks und API-Thinking beachten
Zwei wichtige Einschränkungen: Sicherheitskritische Aufgaben werden teilweise auf Sonnet 5 umgeleitet. Zudem müssen API-Implementierungen, die Thinking bisher per disabled abgeschaltet haben, zwingend auf between_tools umgestellt werden.
Fazit
Die wichtigsten Fakten zu Claude Sonnet 5.5 im Überblick:
- Zweites Modell der Claude 5.5-Familie. Positioniert als schnellere, günstigere Ergänzung zu Opus 5.5. Haiku 5.5 folgt in wenigen Wochen.
- Terminal-Bench 4.0 liegt bei 70,6 % (Sonnet 5: 10,3 %, Opus 5.5: 66,4 %), CursorBench 4.0 bei 55,5 %, GDPval-AA v2.1 bei 1844 (Opus 5.5: 1846).
- Abseits von Terminal-Bench 4.0 behält Opus 5.5 die Oberhand; bei komplexen, ergebnisoffenen Aufgaben ist Opus 5.5 klar im Vorteil.
- Selbst auf den Stufen „Low" und „Medium" übertrifft es die Bestwerte von Sonnet 5 in mehreren Benchmarks bei rund einem Zehntel der Kosten.
- Die Preise bleiben gleich: Input 2 $, Output 10 $, Cache Read 0,20 $ (pro 1M Token). Pro Aufgabe ist es bis zu 30 % günstiger und generiert Text über 30 % schneller.
- Der Standard-Effort liegt bei Claude Code und Apps auf „Medium", bei der Claude-Plattform auf „High".
- Großes Lob für visuelles Gespür bei UI-Designs und Folienlayouts.
- In automatisierten Verhaltensprüfungen in fast allen Punkten gleichauf mit oder besser als Sonnet 5.
- Cyber-Safeguards wurden auf das Niveau von Opus 5.5 angehoben; erstmals gibt es bei Sonnet Klassifikatoren gegen Destillation. Riskante Sicherheitsaufgaben schalten auf Sonnet 5 zurück.
- Die API-Modell-ID lautet
claude-sonnet-5-5. Zur Deaktivierung von Thinking wirdbetween_toolsstattdisabledverwendet.
Im Artikel zu Opus 5.5 ging es darum, wie Fähigkeiten aus der Spitzenklasse oft nach wenigen Wochen in erschwinglicheren Modellen ankommen. Diesmal hat es gerade einmal eine Woche gedauert, bis die Neuerungen Sonnet erreicht haben. Dass ein Modell, das in einigen Benchmarks für Wissensarbeit an Opus 5.5 heranreicht, für die Hälfte der Token-Kosten verfügbar ist, lädt dazu ein, die Aufgabenverteilung zwischen den Modellen neu zu überdenken.
Ich werde in Claude Code vorerst Opus 5.5 als Hauptmodell beibehalten, Detailanpassungen und Sub-Agenten-Aufgaben jedoch an Sonnet 5.5 übergeben, um ein besseres Gefühl für die Praxis zu bekommen. Neue Erkenntnisse werde ich wie gewohnt in einem weiteren Artikel teilen.