Claude Sonnet 5.5 が登場。Sonnet 5 と同じ料金のまま、30% 以上速く Opus 5.5 に迫る
目次
こんにちは。2026年9月28日(米国時間)、Anthropic から「Claude Sonnet 5.5」が発表されました。先週の Opus 5.5 に続く、Claude 5.5 ファミリーの2番目のモデルです。
公式アナウンスの冒頭では、Sonnet 5 からの明確なアップグレードであり、30% 以上速く、多くの作業で最大 30% 安くなる、と紹介されています。料金表そのものは Sonnet 5 から変わっていません。同じ単価のまま、同じ仕事を少ないトークンで終えるので、結果として安くなる、という説明です。
位置づけもはっきりしています。慎重な判断が要る複雑な作業は Opus 5.5、範囲がはっきりした日々のタスク、バグ修正、資料・スライド・スプレッドシートの作成は Sonnet 5.5、という分担です。公式は Sonnet 5.5 を、Opus 5.5 を補う「より速く、より安い」モデルとして位置づけています。
この記事では 公式アナウンス と Claude 公式アカウントの X の投稿をもとに、Sonnet 5.5 で何が変わったのか、Opus 5.5 とどう使い分けるとよさそうかを整理していきます。
今回の発表のポイント
公式アナウンスは、Sonnet 5 からの改善点を5つに分けて紹介しています。
- 性能 - Terminal-Bench 4.0 は Sonnet 5 の 10.3% から 70.6% へ。GDPval-AA では Opus 5.5 とほぼ並びました。スクリーンショットだけを頼りに『ポケットモンスター 赤』をクリアした、初めての Sonnet モデルでもあります
- コラボレーション - Opus 5.5 と同じく、前の世代より文章が分かりやすくなりました。速さを活かして、複雑すぎないタスクを素早く繰り返す使い方に向いています
- コスト - 料金は Sonnet 5 と同じ。同じ作業に使うトークンが大きく減り、1タスクあたり最大 30% 安くなります
- 速度 - 出力の生成は Sonnet 5 より 30% 以上速く、Sonnet としてはこれまでで最速
- アライメントと安全性 - 自動行動監査で、ほとんどの指標が Sonnet 5 と同等以上。Sonnet として初めて、上位モデルと同じようなサイバーセキュリティの safeguards を備えて公開されます
なお、ファミリーの残る1つ、大量処理やコスト重視の用途向けの Claude Haiku 5.5 も、数週間のうちに加わる予定です。
ベンチマークでは Sonnet 5 から大きく伸び、Opus 5.5 に迫る
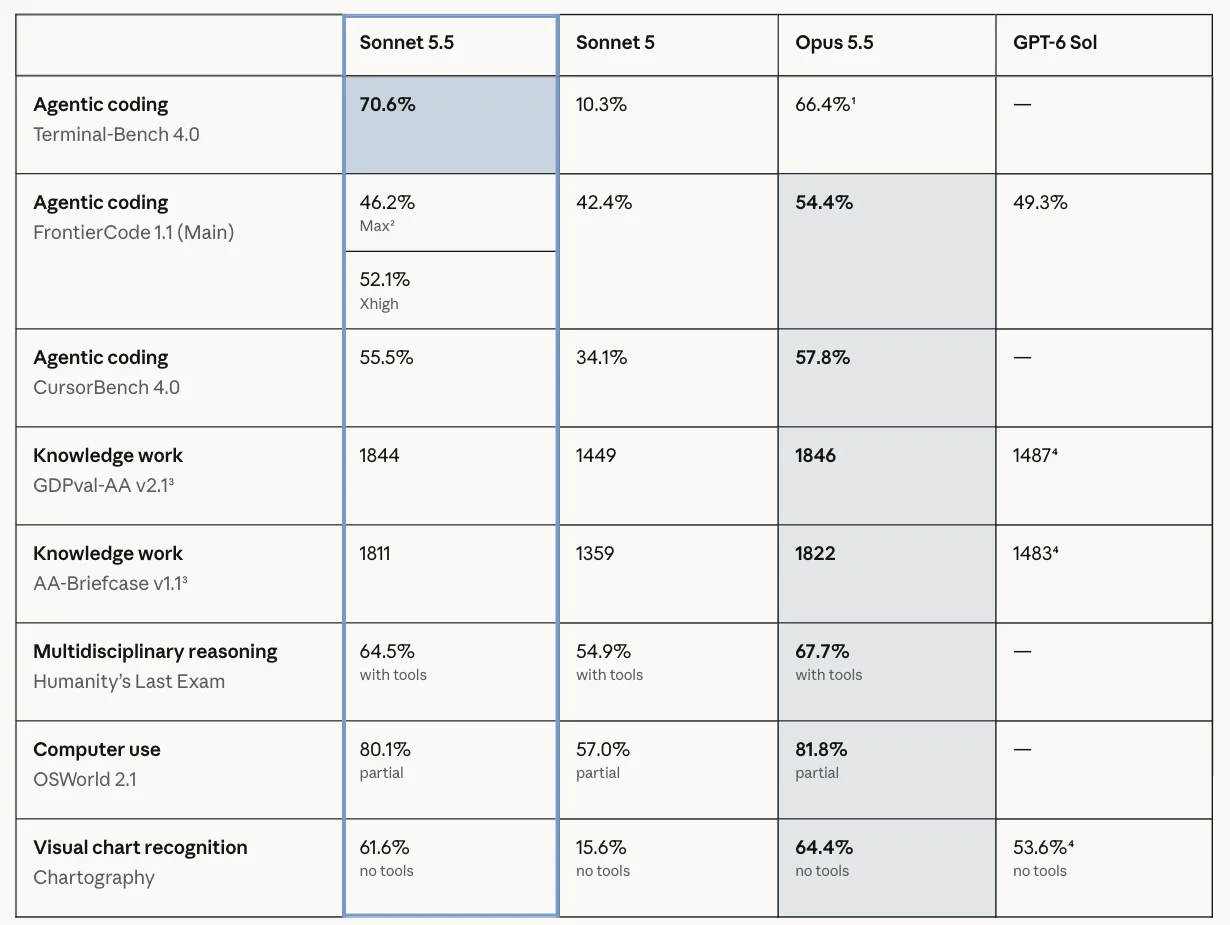
公式が掲載している比較表がこちらです。
 (出典:Introducing Claude Sonnet 5.5 \ Anthropic)
主な項目を抜き出すと、次のようになります。
| ベンチマーク | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0(ターミナルでのエージェント的コーディング) | 70.6% | 10.3% | 66.4% | 掲載なし |
| FrontierCode 1.1 Main(エージェント的コーディング) | 46.2%(Max)/ 52.1%(Xhigh) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0(エージェント的コーディング) | 55.5% | 34.1% | 57.8% | 掲載なし |
| GDPval-AA v2.1(知識労働、Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1(長時間の知識労働、Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam(分野横断の推論、ツールあり) | 64.5% | 54.9% | 67.7% | 掲載なし |
| OSWorld 2.1(コンピュータ操作、partial) | 80.1% | 57.0% | 81.8% | 掲載なし |
| Chartography(グラフの読み取り、ツールなし) | 61.6% | 15.6% | 64.4% | 53.6% |
どの項目も Sonnet 5 から大きく伸びていますが、特に目立つのは Terminal-Bench 4.0 です。Sonnet 5 の 10.3% から 70.6% へと、桁が変わるほどの伸び方で、表の上では Opus 5.5 の 66.4% も上回っています。グラフの読み取りを測る Chartography も 15.6% から 61.6% に上がっていて、画像を理解する力の伸びも大きいことが分かります。
知識労働の GDPval-AA v2.1 は 1844 で、Opus 5.5 の 1846 とわずか2ポイント差です。GDPval-AA は、44 の職種と9つの主要産業の実務を題材にしたベンチマークで、Sonnet 5 からはおよそ 400 ポイント上がりました。
一方で、Terminal-Bench 4.0 以外の項目では、どれも Opus 5.5 が上回っています。公式も、ベンチマークはモデルの能力の一面しか捉えておらず、持続的な判断が要る複雑で答えの決まっていない作業では、Opus 5.5 のほうがはっきり強い、と明記しています。表の数字は Anthropic が公表したもので、第三者による独立検証ではない点も押さえておきたいところです。
数字を読むときの注意点
脚注には、読み方に関わる注意がいくつか書かれています。
- Terminal-Bench 4.0 の Opus 5.5 は、最高スコアが出た Xhigh effort の結果です
- FrontierCode は、人の手を加えずにそのままマージできる変更かどうかを評価し、タスクの範囲外の変更は質が高くても減点します。Sonnet 5.5 は Max effort のほうが Xhigh よりスコアが低く、これは Max では Claude Code の code-review スキル(レビューを多数のサブエージェントに分けて行う)を走らせることが増え、タイムアウトや範囲外の追加修正につながったためと説明されています
- GDPval-AA と AA-Briefcase は、Artificial Analysis が公開前の Sonnet 5.5 で実施したもので、structured outputs を使うリクエストの応答が劣化するバグがありました(修正済み)。影響があったとしても小さく、スコアを低めに見せる方向だとされています
FrontierCode の件は、Claude Code で effort を上げるときの参考になります。effort を上げるほどモデルは念入りに作業しますが、頼んだ範囲の外まで手を広げることもある、ということです。Opus 5.5 の記事でも、Terminal-Bench 4.0 のスコアが xhigh でピークを迎えて max でわずかに下がる例を紹介しましたが、「effort は上げるほど良い」とは限らないことが、今回も脚注から読み取れます。
effort を下げても Sonnet 5 の最高スコアを超える
今回の発表でいちばん実務に効きそうなのが、ここです。公式によると、いくつかのベンチマークでは Low や Medium の Sonnet 5.5 が、Sonnet 5 の最高スコアを、1タスクあたりおよそ10分の1のコストで上回っています。
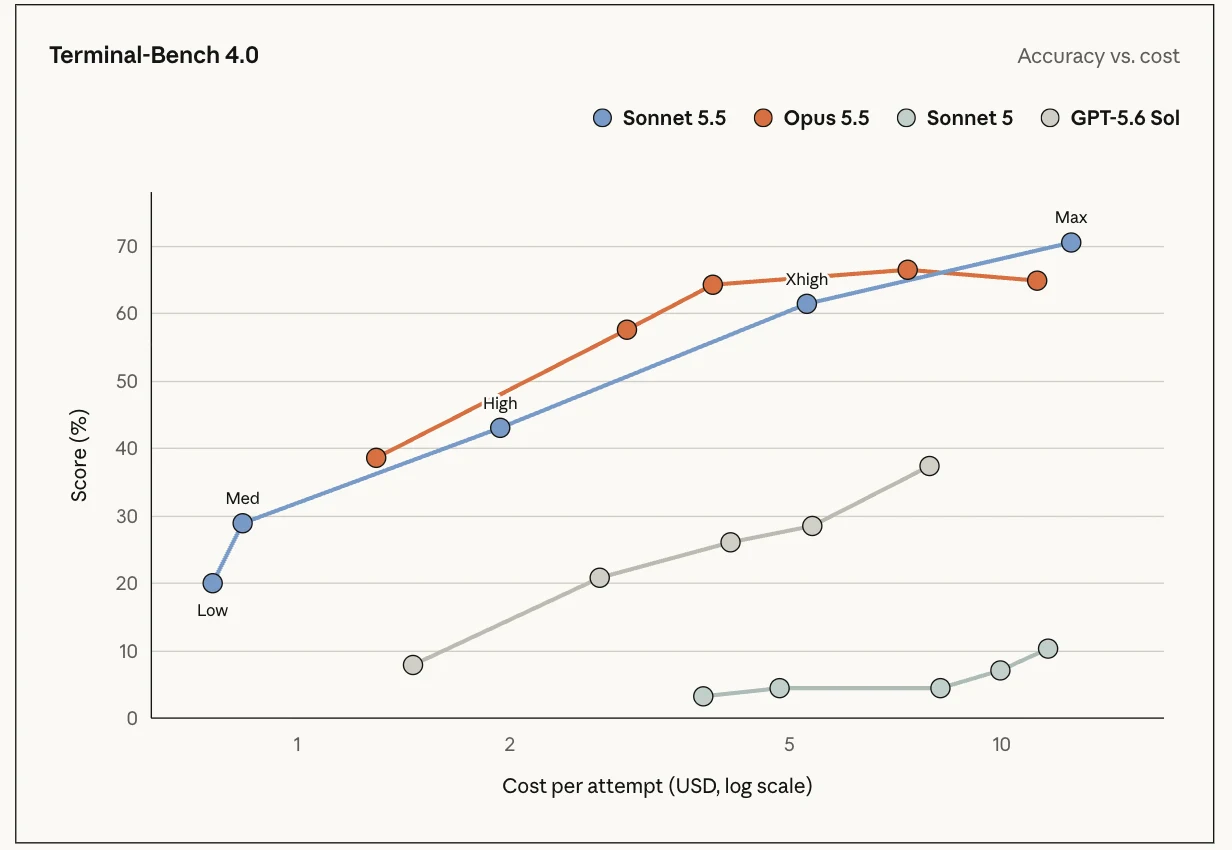
effort は、モデルが回答の前にどれだけ考え込むかを指定する設定で、Low / Medium / High / Xhigh / Max の5段階があります。上げるほど深く考える代わりにトークンと時間を使い、下げるほど速く安くなります。公式のグラフは、横軸に1タスクあたりのコスト(対数目盛り)、縦軸にスコアを取り、effort ごとの点を線でつないだものです。左上にあるほど「安くて高スコア」です。
 (出典:Introducing Claude Sonnet 5.5 \ Anthropic)
Terminal-Bench 4.0 のグラフを見ると、Sonnet 5 の線は最も高い effort でも 10% 前後(1回あたり $12 前後)にとどまっています。これに対して Sonnet 5.5 は、Claude のアプリの既定である Medium でおよそ 29%($0.8 前後)です。公式の説明どおり、Sonnet 5 の最高スコアを10分の1未満のコストで大きく上回っています。
一方で、Opus 5.5 との関係は effort によって変わります。High のあたりまでは Opus 5.5 の線のほうが上にあり、Sonnet 5.5 が 70.6% を出したのは Max のとき($13 前後)です。Opus 5.5 は Xhigh($7.5 前後)で 66.4% なので、Terminal-Bench 4.0 で Opus 5.5 を上回ったとはいえ、そのぶんのコストはかかっています。
 (出典:Introducing Claude Sonnet 5.5 \ Anthropic)
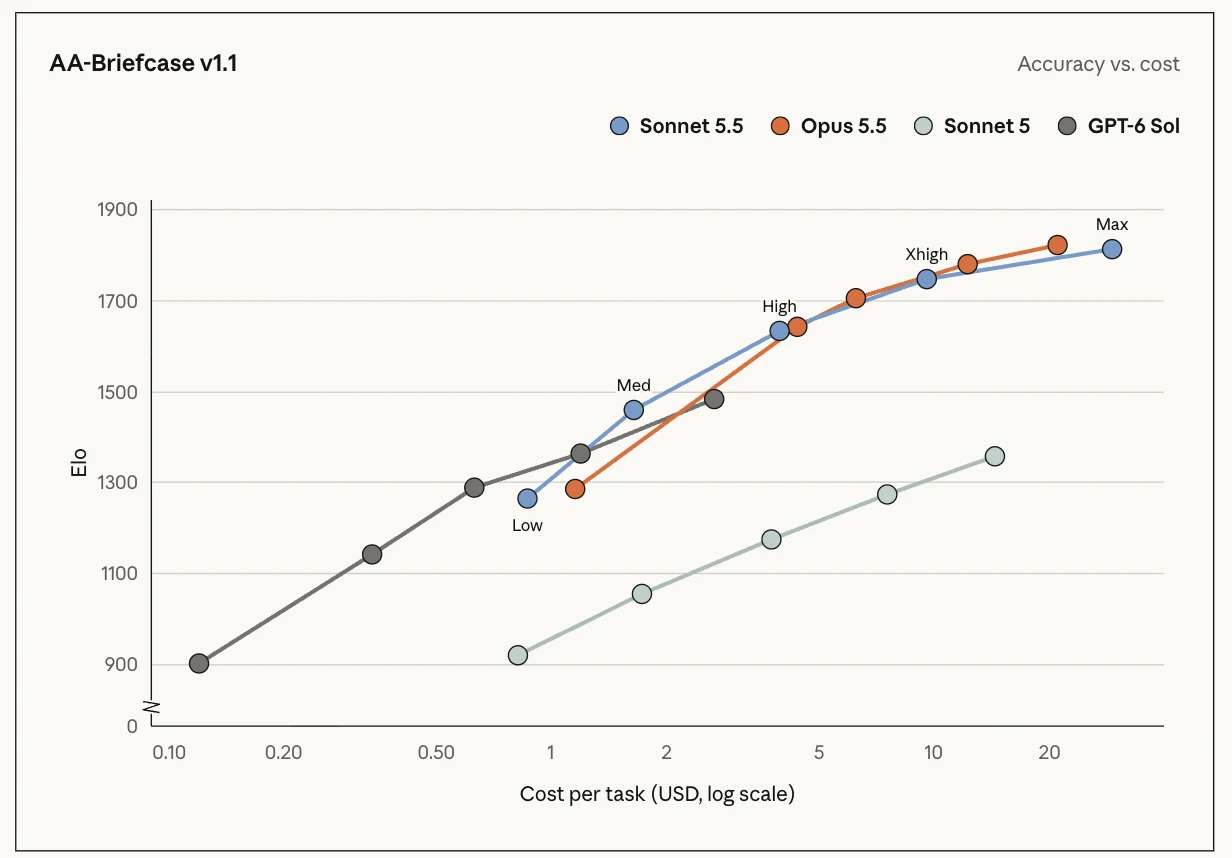
AA-Briefcase v1.1 は、Artificial Analysis が新しく用意した、長時間にわたる知識労働のベンチマークです。Sonnet 5.5 は Medium でおよそ 1460($1.6 前後)と、Sonnet 5 の最高スコア(1359、$14 前後)をおよそ9分の1のコストで上回っています。High から上では、Sonnet 5.5 と Opus 5.5 の線がほぼ重なっているのが印象的です。
このグラフの形が、そのまま使い分けの指針になっています。公式は、Sonnet 5.5 が Opus 5.5 をいちばんよく補うのは低い effort で動かすときで、高い effort では同じくらいのコストで同等の結果を出せることもある、と説明しています。つまり、安く速く回したい作業は Sonnet 5.5 の Low や Medium で、じっくり考えさせたい作業は Opus 5.5 で、という分け方が素直だと思います。
グラフの数値は目盛りから僕が読み取った概算で、測定そのものは Anthropic によるものです。公式ではこのほか、FrontierCode では Claude Platform の既定である High の Sonnet 5.5 が、GPT-6 Sol の最高スコアにおよそ5分の1のコストで並ぶ、とも説明されています。
既定の effort は Claude Code とアプリで Medium
公式によると、既定の effort は Claude Code と Claude のアプリでは Medium、Claude Platform(API)では High です。低い設定では速く、トークンも少なく済むので定型的な作業に向き、高い設定ではより長く考えて、自分の作業を念入りに確かめます。
コーディングではコードベースの理解が速い
公式が特に伸びが目立つ分野として挙げているのが、コーディングです。FrontierCode では、同じ High effort どうしで比べると Sonnet 5 より 10 ポイント高く、1タスクあたりのコストはおよそ15分の1でした。実際の Cursor のセッションから取ったタスクで評価する CursorBench でも、最高スコアは Opus 5.5 との差がおよそ2ポイントです。
早期テスターの評価で共通しているのは、コードベースを理解するのが速いことと、効率の良さです。直接比較したところ、Sonnet 5 よりもツール呼び出しをまとめて実行する傾向があり、ステップ数とコストが減ったとのことです。紹介されているコメントから、いくつかを要旨で紹介します。
- Epic Games は、上位モデルに期待するのと同じ品質の基準を満たしたと評価しています。ゲームプレイのシステム設計で数万行のコードを扱い、数時間かかるタスクもこなしたそうです
- CodeRabbit は、Sonnet 5 で気になっていた、Web 検索に頼りすぎる癖とトークンの多さが、どちらも解消されたと述べています。単純なものから中程度のレビューを、まず Sonnet 5.5 に移す予定とのことです
- Base44 は、118 本の実際のアプリ構築で、Opus 5 と同等の品質のアプリを作ったと報告しています。1回の構築あたりの反復回数は平均 3.6 回で、Opus 5 の 7.7 回の半分以下でした
- Lovable は、社内のコーディング評価で、タスクを終えるまでのツール呼び出しが3分の1減り、シェルの実行回数はおよそ半分になったとしています
もう一つ、ゲーム制作をしている Creator の Kevin Ngo 氏のコメントは、Opus 5.5 との分担をよく表していると感じました。
When Claude Opus 5.5 sets the architecture and general framework for a game, I would feel confident in letting Sonnet 5.5 implement it.
Opus 5.5 が設計と全体の枠組みを決めれば、実装は Sonnet 5.5 に安心して任せられる、という趣旨です。Claude Code なら、計画は Opus 5.5、実装や細かな修正は Sonnet 5.5 のサブエージェントに回す、という組み合わせが考えやすくなりそうです。
知識労働ではデザインの感覚が評価されている
知識労働では、コンピュータ操作とグラフの読み取りで Opus 5.5 に近く、長時間の知識労働では Sonnet 5 と GPT-6 Sol をはっきり上回っています。
数字に表れにくい変化として、公式はデザインの感覚を挙げています。ユーザーインターフェイスに磨きをかけ、スライドのテンプレートに沿って、ほとんど手直しの要らない資料を作れるとのことです。社内のテストでは、ある上場企業の四半期決算の資料と説明会の書き起こし、スライドのテンプレートを渡し、10枚の業績レビューを作らせました。専門家2人が、最初の下書きをそのまま送れる水準だと判断したそうです。
X の投稿でも、「風が砂丘を形づくる様子を1つの HTML ファイルで」というプロンプトで、Sonnet 5 と Sonnet 5.5 がコードを書く様子を並べた動画が紹介されていました。公式ページには、このほか 400 羽のムクドリの群れや、24 個の小さな時計でできた時計を作らせた比較も載っています。
早期テスターの報告からも、いくつか紹介します。
- Slack は、プロンプトを一切変えずに、オフラインの Slackbot 評価のほぼすべてで Sonnet 5 を上回り、ステップ数は少なく、出力トークンはおよそ 14% 少なかったと報告しています
- Box は、元の文書にあたってデータを確かめ直し、Sonnet 5 が見落とした誤りに気づくようになったと評価しています。前のモデルより正確で、2.4 倍速く、トークンの合計は 12% 少なかったとのことです
- 投資会社の Balyasny Asset Management は、2,441 件の金融タスクで Sonnet 5 を上回り、1回答あたりのトークンは Sonnet 5 の約 49.7 万に対して約 12.1 万だったとしています
トークン量の差は、各社の報告の中でも特に大きく見えるところです。料金表が同じでも、実際の請求額はかなり変わってきそうです。
料金は Sonnet 5 と同じで、入出力は Opus 5.5 の半額
料金は次のとおりです。
| 項目(per 1M tokens) | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 入力 | $2 | $4 |
| 出力 | $10 | $20 |
| cache read | $0.20 | $0.20 |
| cache write | $2.50 | $5 |
入力と出力は Opus 5.5 のちょうど半額です。cache read(処理済みの入力を再利用するときの読み込み)は、Opus 5.5 の値下げで同じ $0.20 に並びました。
Sonnet 5 と同じ単価で、1タスクに使うトークンが減るので、公式のテストでは1タスクあたり最大 30% 安くなるとのことです。出力の生成も 30% 以上速くなっていて、公式ページの比較動画でも、その効率の差はすぐに分かります。
安全性とアライメント
安全性の章は、「Sonnet 5.5 は同社のモデルの能力の最先端を押し広げるものではない」という前置きから始まっています。そのため、アライメントの評価は、能力の水準に関係なく当てはまるリスクに絞って行われました。ユーザーの利益に反する行動、ユーザーを誤解させること、深刻な悪用への協力などです。
評価の要点は次のとおりです。
- 自動行動監査 - 約1,850のシナリオで振る舞いを評価する監査で、アライメント、悪用への耐性、正直さのほとんどの指標で、Sonnet 5 と同等以上
- 封じ込めの評価 - サンドボックスからの脱出を試みる頻度の低さは、テストした中で最も良かった Opus 5.5 に近く、コンテナの限界を探ろうとする傾向は同社のモデルの中で最も低い
- 全体として - 監査全体では Opus 5.5 のほうがわずかに良いものの、ユーザーの意図と対立する目標を追う証拠は見つからなかった
一方で公式は、どんな評価でもすべての失敗を確実に捕まえられるわけではなく、Sonnet 5.5 にもまだ見つかっていない傾向があるかもしれない、とも書いています。だからこそ、次の safeguards と組み合わせている、という説明です。
サイバーの safeguards が Opus 5.5 並みに強化された
Sonnet 5.5 には、次の3つの分野で safeguards(安全装置)が入っています。なお、Sonnet にもともと safeguards がなかったわけではありません。6月の Sonnet 5 の発表 では、Sonnet 5 は Opus 4.7・4.8 と同じサイバーの safeguards を既定で有効にして公開されていました。サイバーリスクは低いと判断されたため、Fable 5 のものよりは緩い設定でした。今回の Sonnet 5.5 は、それが Opus 5.5 と同様の水準に引き上げられた、という変化です。
- サイバーセキュリティ - サイバー能力が Sonnet 5 から大きく向上し、Opus 5 に匹敵するため、Opus 5.5 と同様の safeguards を適用して公開されます。通常の開発の中でコードのバグを見つけて直すことはできますが、リスクの高いサイバーセキュリティのタスクは、分かる形で Sonnet 5 に切り替わります。防御側の専門家向けには、拡大した Cyber Verification Program に近日中に申し込めるようになり、Sonnet 5.5・Opus 5.5・Mythos モデルのより高度な能力に段階的にアクセスできる予定です
- 生物学 - Sonnet 5.5 の生物学の safeguards は、Sonnet 5 から変わっていません。有害なリクエストを対象にしたもので、研究・教育・臨床のほとんどの作業には影響しませんが、微生物学やウイルス学のリクエストの一部が誤って検出されることがあるとされています。生物学の幅広い作業で使いたい組織は、Life Sciences Verification Program に申し込めます
- 蒸留対策 - 大量の偽アカウントを使ってモデルの能力を抜き出す蒸留攻撃への対策として、推論の抽出を防ぐ安全分類器を備えて公開される、初めての Sonnet モデルです。また、preserved thinking の範囲が広がり、Claude の思考を、それを生成したアカウントから切り離せなくなりました
蒸留対策は、ほとんどの開発者は変化に気づかないだろう、とされています。ただし、アカウントをまたいで会話を移す使い方、たとえば Claude Code のセッションの途中でアカウントを切り替える場合は影響があるので、心当たりのある方は公式ページからリンクされているドキュメントを確認しておくとよいと思います。
Claude Code ユーザーとして気になるのは、セキュリティ寄りの作業の一部が Sonnet 5 に切り替わる点でしょう。通常のバグ修正には影響しないとされていますが、リスクが高いと判定される脆弱性の調査などでは、これまでと挙動が変わる可能性を頭に置いておくとよさそうです。
API で移行するときは thinking の設定に注意
これまでの Sonnet と同じく、Sonnet 5.5 は zero data retention(データを保持しない運用)の対象として利用できます。提供は発表日からすべてのプラットフォームで始まっていて、Amazon Web Services、Google Cloud、Microsoft Azure でも利用できます。API のモデル ID は claude-sonnet-5-5 です。
API で Sonnet 5 から移行する場合に気をつけたいのが、thinking(回答前の思考)を切っている使い方です。移行ガイド によると、Sonnet 5 で thinking を切るときに使っていた thinking: {"type": "disabled"} は、Sonnet 5.5 では 400 エラーになります。代わりに、新しく追加された between_tools を指定します。
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 16000,
  "thinking": {"type": "between_tools"},
  "output_config": {"effort": "high"},
  "messages": [{"role": "user", "content": "..."}]
}
between_tools は Sonnet 5.5 で最も低い thinking の設定で、回答前の思考はしませんが、ツール呼び出しの合間には思考のブロックが返ってきます。移行ガイドには、ほかにも次の制約が書かれています。
- 使える effort は
low・medium・highだけで、xhighやmaxと組み合わせると 400 エラー - 会話の途中で effort を変えられない。ターンごとに effort を変えたいときは adaptive thinking を使う
between_toolsを定義していない古い SDK では、Python と TypeScript の例が型チェックで失敗する。SDK を更新するか、値を raw JSON として渡す
また、Sonnet 5.5 は thinking を指定しなければ思考が有効になります。これまで thinking なしで動かしていたコードは、次の点も見直しておくと安心です。
- レスポンスの先頭に
thinkingブロックが来ることがあるので、content[0].textを前提にせず、ブロックのtypeで判定する - ツール呼び出しのループでは、空のものも含めて
thinkingブロックを変更せずにそのまま送り返す max_tokensには思考の分も含まれ、思考のトークンは出力トークンとして課金されるので、上限を見直す
移行ガイドでは、Claude Code の /claude-api migrate で、同梱の Claude API スキルに移行を任せる方法も紹介されています。モデル ID の置き換えや、エラーになるパラメータの修正、effort の調整をまとめて行い、手で確認すべき項目をチェックリストにしてくれるとのことです。
Claude Code で試してみる
僕の環境の Claude Code(2.1.284)で確かめたところ、モデルのエイリアス sonnet は、すでに claude-sonnet-5-5 を指していました。起動時に指定するなら、次のどちらでも Sonnet 5.5 で動きます。
claude --model sonnet
claude --model claude-sonnet-5-5
先ほどのグラフのとおり、Sonnet 5.5 の持ち味は低めの effort でのコストの低さなので、まずは既定の Medium のまま、普段のバグ修正や小さな機能追加を任せてみるのがよさそうです。
手元で Sonnet 5.5 にならない場合は、まず claude --version でバージョンを確認し、古ければアップデートしてから再起動してみてください。
claude update
表示の可否やデフォルトの挙動は、プラン・provider・管理者設定によって異なります。まだ Homebrew や npm 経由で Claude Code を使っている方は、このタイミングでネイティブインストールに切り替えておくと、自動更新が効いて新しいモデルへの追従がスムーズになります。詳しい手順は Claude Code を Homebrew からネイティブインストールに切り替えたら快適になった話 にまとめてあります。
Sonnet 5 と Sonnet 5.5 の比較
主な違いを表にまとめておきます。
| 項目 | Sonnet 5 | Sonnet 5.5 |
|---|---|---|
| 料金(入力/出力・per 1M tokens) | $2 / $10 | $2 / $10(据え置き) |
| 1タスクあたりのコスト | 基準 | 最大 30% 減 |
| 出力の生成速度 | 基準 | 30% 以上速い |
| Terminal-Bench 4.0 | 10.3% | 70.6% |
| CursorBench 4.0 | 34.1% | 55.5% |
| GDPval-AA v2.1 | 1449 | 1844 |
| サイバーセキュリティの safeguards | Opus 4.7・4.8 と同じもの(Fable 5 より緩い) | Opus 5.5 と同様(介入時は Sonnet 5 へ切り替え) |
| thinking を切る設定 | disabled | between_tools |
| API のモデル ID | claude-sonnet-5 | claude-sonnet-5-5 |
ベンチマークの数字は、今回の公式アナウンスの比較表にもとづいています。
ユーザーにとって、どこが嬉しいのか
ここまでの内容を、自分の仕事にどう効くかという視点で整理し直してみます。
1. 同じ料金のまま、性能が大きく上がった
Terminal-Bench 4.0 が 10.3% から 70.6% へ、GDPval-AA は Opus 5.5 とほぼ並ぶ水準です。料金表は Sonnet 5 のままなので、既定の設定のまま使っている方は、モデル ID を変えるだけで移行できます。thinking を切っている API の実装では、前述の書き換えが必要です。
2. 低い effort で十分に強い
Low や Medium の Sonnet 5.5 が、Sonnet 5 の最高スコアを 10 分の1ほどのコストで上回ります。サブエージェントや大量のバッチ処理など、回数が多い作業ほど効いてきます。
3. Opus 5.5 との分担が考えやすい
一部のベンチマークでは、高い effort にすると Opus 5.5 と同じくらいのコストで同じくらいの結果に近づくので、深く考えさせたいなら Opus 5.5、速く安く回したいなら Sonnet 5.5 の低い effort、と役割を分けやすくなりました。
4. サイバー系の作業と API の thinking 設定は要確認
こちらは注意点です。セキュリティ寄りのタスクの一部は Sonnet 5 に切り替わり、API で thinking を disabled にしているコードは between_tools への書き換えが必要です。
まとめ
Claude Sonnet 5.5 のポイントをまとめると、次のようになります。
- Claude 5.5 ファミリーの2番目のモデル。Opus 5.5 を補う、より速く安いモデルという位置づけ。Haiku 5.5 も数週間のうちに加わる予定
- Terminal-Bench 4.0 は 70.6%(Sonnet 5 は 10.3%、Opus 5.5 は 66.4%)、CursorBench 4.0 は 55.5%、GDPval-AA v2.1 は 1844(Opus 5.5 は 1846)
- Terminal-Bench 4.0 以外の項目では Opus 5.5 が上回り、複雑で答えの決まっていない作業では Opus 5.5 のほうがはっきり強い
- Low や Medium でも、いくつかのベンチマークで Sonnet 5 の最高スコアをおよそ 10 分の1のコストで上回る
- 料金は Sonnet 5 と同じ入力 $2・出力 $10・cache read $0.20(per 1M tokens)。1タスクあたり最大 30% 安く、出力は 30% 以上速い
- 既定の effort は Claude Code とアプリで Medium、Claude Platform で High
- UI やスライドの仕上がりなど、デザインの感覚も評価されている
- 自動行動監査のほとんどの指標で Sonnet 5 と同等以上
- サイバーの safeguards が Opus 5.5 と同様の水準に上がり、推論の抽出を防ぐ分類器も Sonnet として初めて備える。リスクの高いサイバー系のタスクは Sonnet 5 に切り替わる
- API のモデル ID は
claude-sonnet-5-5。thinking を切るにはdisabledではなくbetween_toolsを使う
Opus 5.5 の記事では、上のクラスで切り開いたものを、数週間後には手の届く価格のモデルに降ろしてくる流れについて書きました。今回はそれが、1週間ほどで Sonnet まで降りてきた形です。一部の知識労働のベンチマークで Opus 5.5 に迫り、入出力の単価は Opus 5.5 の半額というモデルが出てきたことで、どの作業をどのモデルに任せるかを考え直す良い機会になりそうです。
僕もしばらくは、Claude Code のメインは Opus 5.5 のまま、細かな修正やサブエージェントの作業を Sonnet 5.5 に回して、使い分けの感触を確かめてみるつもりです。気づいたことがあれば、また記事にまとめたいと思います。