Anthropic がモノレポを git から自作の「Scion」へ移行。1日3万件のマージに耐えるソース管理の作り方
目次
こんにちは。2026年10月13日(米国時間)、Anthropic のエンジニアリングブログに「Redesigning source control at Anthropic」という記事が公開されました。社内のモノレポ(すべてのコードをひとつにまとめたリポジトリ)を、git から自作のバージョン管理システム「Scion」に移したという内容です。
記事の書き出しは、こう始まります。Anthropic では、もうコードを書くことはシステムづくりや研究のボトルネックではなくなった。いまのボトルネックは、人間の規模を前提に作られた開発基盤、つまりソース管理、ビルド、CI だ、というものです。
僕も Claude Code を毎日使っていて、コードを書く速さが上がったぶん、レビューや CI の待ち時間が目立つようになったと感じることがあります。僕はこの記事を、その状況を会社の規模で突き詰めた結果どうなったか、という話として読みました。元の記事 をもとに、順に整理していきます。
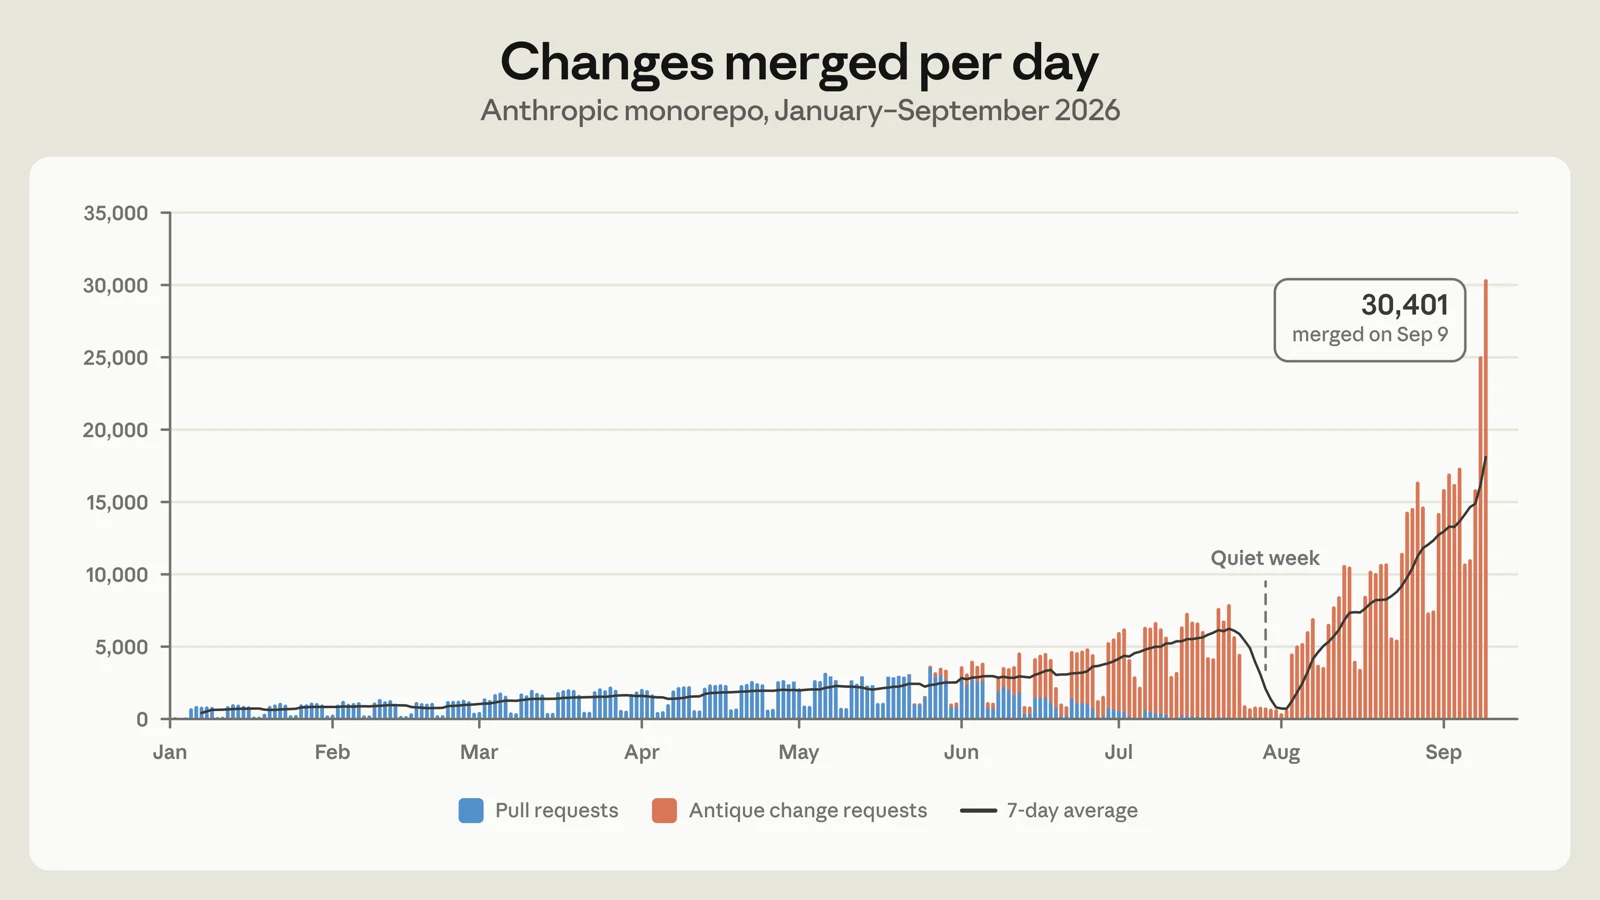
1日のマージ数は5月の約2,500件から9月には3万件超に
まずは、きっかけになった数字です。2026年5月、Anthropic のモノレポには1日平均でおよそ2,500件の変更がマージされていました。それが9月には、1日3万件を超えています。
 (出典:Redesigning source control at Anthropic \ Anthropic)
グラフを見ると、6月ごろから青い棒(GitHub の Pull request)が橙の棒に置き換わっていきます。橙は、Scion と一緒に作られた社内のコードレビューツール「Antique」の change request です。9月9日には、1日で 30,401 件がマージされています。
記事は、この伸びが当面止まらないと見ています。その理由として記事は、コードをマージしたいという需要は事実上無限で、ボトルネックをひとつ取り除くたびに、書かれるコードの量がすぐにさらに増える、と説明しています。
git の何が合わなくなったのか
git は分散型のシステムです。クローンしたリポジトリはそれぞれが完全で、オフラインでも差分を取ったり、履歴や blame(ファイルの各行を、最後に誰がどのコミットで変えたかを表示する機能)を見たり、どのリビジョンにも切り替えたりできます。記事も、ほとんどのリポジトリにとってこれは正しい設計で、git が標準になった大きな理由だと書いています。
ただ、Anthropic のモノレポはその前提から外れてきました。記事に挙がっている数字は次のとおりです。
- main ブランチの履歴だけで、およそ 100 GB
- 圧縮した作業コピーでも 25 GB 超
- CI だけで1日におよそ2,500万回のチェックアウト。開発環境やエージェントのサンドボックス、研究用のジョブは別
- 単純に取得すると、git の通信量は1日 600 PB(ペタバイト。1 PB は 1,000 TB、およそ100万 GB)を超える計算になる
もちろん、Anthropic も手をこまねいていたわけではありません。shallow clone、sparse checkout、promisor remote といった git の機能に加えて、社内の git ミラーや、ブロブストレージ(ファイルなどのデータを大量にそのまま保存しておく、クラウドの保存場所)に置いたリポジトリのスナップショット(seed)も使っていました。ピーク時には、Anthropic は社内の git ミラーを数百台も動かしていたそうです。
それでも、マージの頻度が上がるにつれて運用は苦しくなりました。スナップショットは、更新と更新の間に main の先端からどんどん遅れるようになりました。部分的なクローンで diff や blame のような履歴に頼る操作を動かし続けるのにも、チームはますます手間をかけるようになったそうです。
そこで Anthropic のチームは一歩引いて見直し、ひとつのことに気づきます。多くの会社と同じく、自分たちも git を「正となるコピーがひとつある集中型のシステム」として使っていた。しかも、クライアントのほとんどはエージェントやジョブで、そもそも常にオンラインです。チームは、git がオフラインの分散作業で優れている性質が、リポジトリの成長にとってはむしろ足かせになっていた、と結論づけています。
エージェント時代のソース管理の6つの原則
では、エージェントが常にオンラインであることを最初から前提にしてソース管理を設計したら、どうなるか。記事はそこから、Scion の原則を6つ挙げています。大規模なモノレポのソース管理には、Google の Piper や Meta の Sapling という先行例があります。Anthropic は、その教訓も取り入れたそうです。
- クライアントは常にオンライン - リポジトリの完全なコピーを持たず、必要なときにサーバーからデータを取ってくる
- クライアントとサーバーは対等ではない - 履歴や blame の計算、コミットの作成、マージやリベースはサーバーが行う。クライアントは上限のあるキャッシュを持ち、作業コピーを展開し、ファイルの変更を見張る役に徹する
- ソース管理をサービスとして提供する - Scion は、クライアントが使う問い合わせをすべて API でも公開する。そのため多くのジョブは、手元にリポジトリを持たなくてよい。Anthropic の自動 bisect や自動 revert の仕組みも、この API があるから大規模に回せるそうです
- すべてを水平にスケールさせる - リポジトリのデータは分散していて、サーバー上にもリポジトリの完全なコピーはない。git の packfile にあたるものもないので、リポジトリのメンテナンスも要らない
- コミットは軽く、差分だけで、ロックなしに - Scion ではコミットもリベースもマージもサーバー上で行うので、push という操作がない。その代わり、Scion はコミットの処理の重さを、リポジトリ全体ではなく変更の大きさに比例させる。全サーバーで合意が必要な ref(ブランチやタグ)を、Scion は main とリリースブランチ以外では使わない方針です
- 作業コピーはなくてもよく、あっても一部だけ - CI のジョブは、必要な差分をサーバーに聞けばよい。書き込みも、API だけで済むことが多い。ファイルが必要なときも、クライアントは指定したディレクトリだけを取る sparse checkout か、読んだときに初めてファイルを作る仮想的なチェックアウトを使う
6つを並べてみると、Scion は「手元に全部ある」という git の前提を、多くの点で逆にした設計だと分かります。
Scion の中で変更を記録する単位は「changeset」
Scion で変更を記録する単位は「changeset」と呼ばれ、先行書き込みログ(write-ahead log)の1エントリです。git のコミットに近いものですが、ツリー全体へのポインタを持つ代わりに、最初の親から変わったファイルの一覧と、圧縮したファイル本体への content-addressed(中身から決まるアドレス)なポインタを持ちます。
この形のおかげで、Scion のサーバーは changeset を非常に高い頻度で受け付けられます。理由は、git の push と比べると分かりやすいと思います。
git では、push のたびにサーバーが packfile(複数のオブジェクトを圧縮してひとつにまとめたファイル)を受け取り、そのうえで ref を書き換えます。ref は、ブランチやタグの名前とコミットを結びつける目印のことです。「main ブランチはいま、このコミットを指している」という情報が ref にあたります。何人もが同じブランチに同時に push すると、ref を書き換えられるのは1人だけで、ほかの人は最新の状態を取り込んでから push し直すことになります。
Scion の changeset は、作るときにも取りに行くときにも、この ref に触れません。サーバーは packfile を受け取る必要がなく、ほかのサーバーと足並みをそろえるためのロック(ほかの処理を一時的に待たせる仕組み)も要りません。そのため、サーバーは届いた changeset を次々に記録していけます。
Scion にも ref の仕組みはありますが、ref を動かすのは changeset の作成とは切り離された、小さな処理です。具体的には、Spanner(Google Cloud の分散データベース)の1行を「まだ前の値のままなら、新しい値に書き換える」という操作(compare-and-swap)だけで済みます。
一方で、changeset は変わった部分しか持たないので、そのままでは「この行を最後に変えたのは誰か」のような問いに素早く答えられません。そこで Scion は、blame やファイルの履歴、コミットグラフのスキップリストといった補助的なデータを changeset から組み立てています。記事はこれを「derived data(派生データ)」と呼んでいます。Scion は、すべての派生データをひとつの汎用的な仕組みで計算します。どの派生データも、ある changeset の値を、その親の値から再帰的に計算する形で定義されているそうです。
記事は、この作りの利点を3つ挙げています。新しい種類の派生データを足しやすいこと、種類ごとにすぐ計算するか後回しにするかを選べること、クライアントに影響を与えずに中身を最適化できることです。
チェックアウトは3層のキャッシュで返す
ファイルの中身を取ってきて作業コピーを作るのは、データ量の多い重い処理です。Scion は、この部分を独自に設計しています。
 (出典:Redesigning source control at Anthropic \ Anthropic)
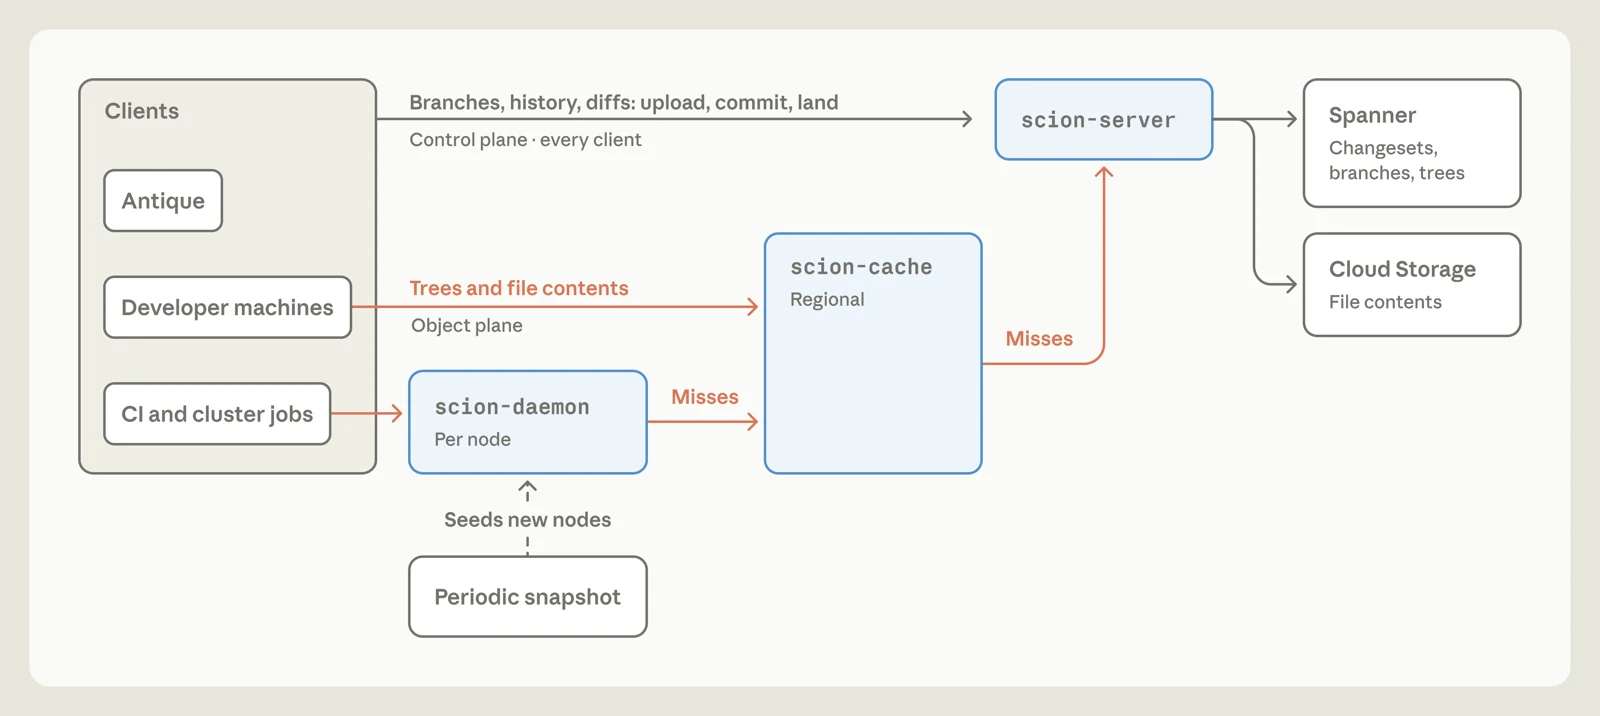
git の取得では、クライアントが「自分が何を持っているか」をサーバーに伝え、サーバーが足りないものを計算して packfile にまとめて返します。Scion のクライアント(scn)は逆で、自分が欲しいツリー(ディレクトリの中身の一覧)とブロブ(ファイルの中身そのもの)だけを要求します。ルートのツリーから始めて、手元にないツリーを再帰的に取り、次にブロブを取る、という流れです。
クライアントが要求するのは中身が変わらないオブジェクトばかりなので、どのキャッシュでもその要求に答えられます。そこで Scion は、次のような3層のキャッシュを置いています。
- scion-daemon - ノードごとに1つ置かれる。scion-daemon は、そのノードで動く全ジョブのオブジェクトをまとめて持ち、定期的に更新されるスナップショットから起動する
- scion-cache - 地域ごとに置かれる。scion-cache はオブジェクトをメモリからそのまま流すので、足りないものの計算や差分圧縮をしなくてよい
- scion-server - キャッシュにないオブジェクトだけを、Spanner や Cloud Storage から読む
3つとも同じ RPC(Remote Procedure Call。ネットワークの向こうのサーバーにある処理を、手元の関数のように呼び出す仕組み)に答えるので、クライアントは、自分がどの層に問い合わせているのかを知らなくてよいそうです。ただ、Anthropic は、地域のキャッシュの障害が上流のサーバーまで巻き込まないように、層の順番を厳密に守らせています。
この設計の効果は、はっきり数字に出ています。各層のキャッシュヒット率は99%を超えました。Scion の基盤は、以前の git ミラーの基盤と比べて、CPU とメモリで200分の1の規模になりました。CI や研究用のジョブのチェックアウトは、数分から数秒へと、およそ100倍速くなりました。CI だけでも、CPU の使用量が25%減ったそうです。なお、これらの数字はすべて Anthropic が自社の環境で測ったもので、測定条件の細かな内容までは公開されていません。
 (出典:Redesigning source control at Anthropic \ Anthropic)
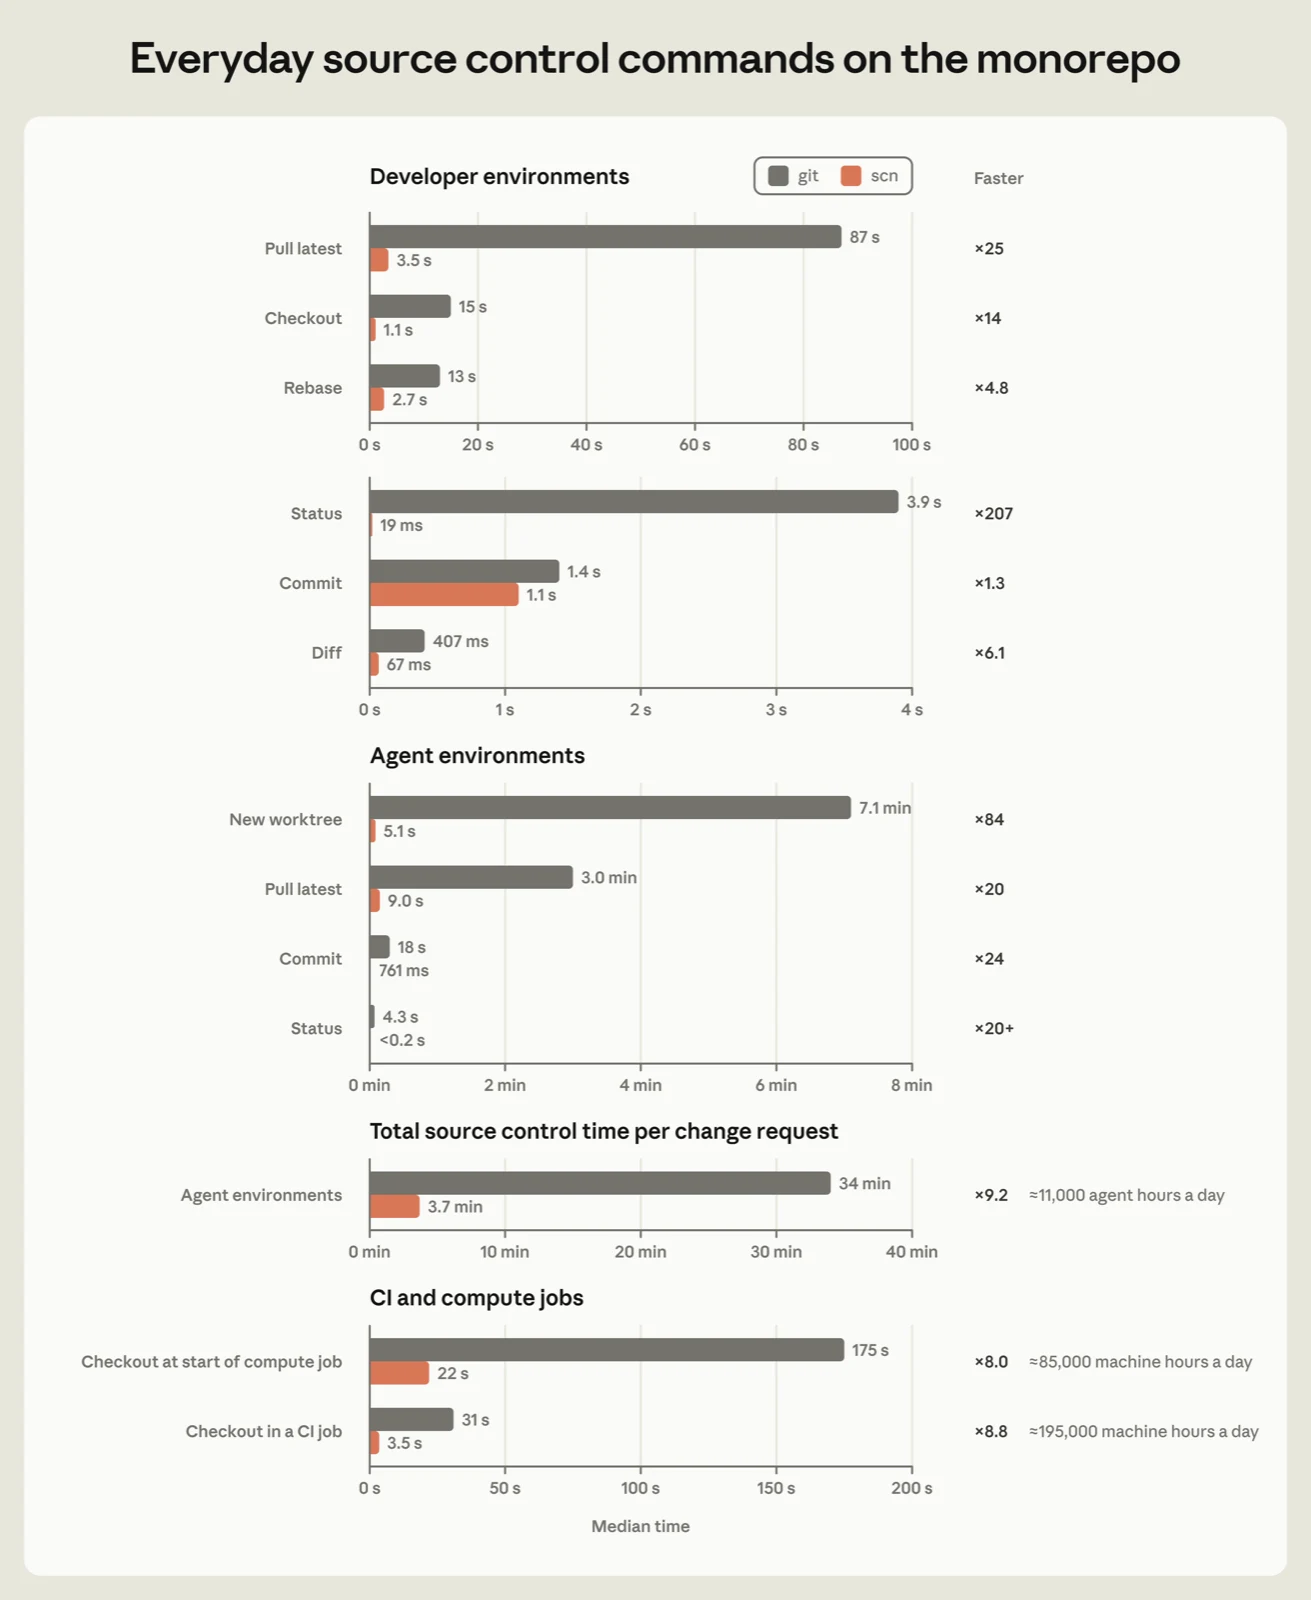
記事には、日常のコマンドの速さを git と比べた図もあります。開発環境では、status が 3.9 秒から 19 ミリ秒に、最新の取得が 87 秒から 3.5 秒になっています。エージェントの環境では、新しい worktree の作成が 7.1 分から 5.1 秒になりました。変更1件あたりのソース管理の時間は、34 分から 3.7 分に縮みました。図には、この差がエージェントの作業時間にして1日およそ1万1,000時間分にあたる、と添えられています。どのコマンドも数倍から数百倍の差で、驚くほどの性能向上ですよね。
7人のチームが5か月で作れた理由
Scion とコードレビューツールの Antique、さらに関連する6つほどのシステムを作り、移行まで終えたのは、わずか7人のチームでした。期間は5か月です。その間に、1日のマージ数は10倍に増えています。記事は、以前ならこうしたソース管理の開発と移行に、もっと多くのエンジニアで何年もかかっただろう、と書いています。
チームが開発を始めたのは、Claude Mythos Preview と Claude Tag が社内で使えるようになったころでした。記事が印象的な例として挙げているのが、git から Scion へデータを取り込むパイプラインの話です。チームは最初の版を試作としてほぼ手で書き、出来も悪くないと思っていたそうです。ところが、チームが Claude Mythos Preview の初期のスナップショットに追加の指示なしで書き直しを頼むと、Claude はメモリ使用量が20分の1、速度が4倍の版を書き上げました。しかもその版は、取り込みの順序やデータ構造について暗黙に守るべき条件を、すべて守っていたそうです。
一方で記事は、エンジニアの役割がなくなったわけではない、とも強調しています。
- このシステムに関わったエンジニアは全員、コードを書く力では Claude のほうが自分より上だと評価している
- それでも、システム同士のつながりや設計上のトレードオフは、エンジニアが理解して判断した
- エンジニアの役割は、Claude に「だめ」と言うことであることが多かった。たとえば Claude は移行中に、main へのマージ時刻を調べるのに、レビューツールに聞かずにコミットログを先頭から読む実装を何度も書いたそうです
- 敵対的レビューはとても有効だが、視野が狭くなることもある。記事には、別の社内サービスを過剰に疑ったレビューに応えて、Claude が検証処理を盛り込みすぎた例が挙がっています
- チームはいまも変更をすべて人がレビューしているが、1行ずつ読むのではなく、変更の意図を見るようになった
僕も Claude Code で書いたものに Codex で敵対的レビューをかけることがあるので、この指摘には思い当たるところがありました。レビューが仮定の心配に反応すると、Claude は作りを膨らませてしまいがちです。
品質や運用についての学び
記事は、ほかにもいくつかの学びを挙げています。
- テストと最適化の厚み - Claude が大量のコードを速く書けるので、Scion はチームがこれまで関わった中でも特にテストの厚いコードベースになった。チームは、基盤やソース管理のやりとりを外部から切り離して再現するシミュレーション、ファジング、細かなレート制限まで用意できたそうです
- ディレクトリ単位の権限 - Scion では、リポジトリ単位に加えて、ディレクトリごとに権限を付けられる。Anthropic はこの機能で、モノレポの利点を保ったまま、特に機密性の高いコードを守れる
- 「superfan」による監視 - superfan は英語で「熱狂的なファン」という意味で、チームが監視役の Claude に付けたあだ名です。チームは Claude Tag(Slack で動く Claude)を使い、Slack のチャンネルごとに、1つのコンポーネントの健全性だけに張り付く Claude を置いているそうです。scion-daemon の superfan、scion-cache の superfan、という具合です。記事は superfan を、ログやグラフを見て異常を探す以外にやることがない、経験豊富なエンジニアのようだと表現しています。superfan は、従来のアラートでは見落としがちな、細かく新しい種類の異常も見つけられるそうです。記事は、superfan と比べると従来のアラートは一面的に見える、とまで書いています
- 前提を考え直す - テストを回している間に何百、何千もの変更がマージされるなら、CI とは何なのか。チームは、マージキューにリポジトリ全体のロックをかける業界標準のやり方を再現できなかったので、マージ後とデプロイ前の自動テストに力を入れている。同時に入った変更がぶつかることはあるが、たいていは人が問題に気づくより速く、Claude がその衝突を直せるそうです
Scion をそのまま公開する代わりに考え方を git に還元する
最後に、記事は Scion の位置づけをはっきりさせています。
記事によると、Scion は一般向けに git の代わりになるものではありません。記事は、ここで紹介した考え方が意味を持つのは、何万人ものエンジニアか、大量のエージェントがコードを書き続けるような、本当に巨大なモノレポだけだとしています。また記事は、Anthropic が社内で使えるトークンの量は普通の会社とは桁違いで、その点でも特殊だ、とも書いています。
そのうえで記事は、Scion をそのまま他社に提供するのは難しい、としています。Scion は git から大きく離れているので、使う会社は開発の流れをすべて移す必要があり、コードレビューやコード検索、CI まで専用のものを用意しなければならないからです。
ただし記事は、この種の問題が今後6〜12か月でもっとありふれたものになると見ています。そして、git を使う会社がそれぞれ単独で同じ問題に向き合うのは効率が悪い、とも書いています。そこで Anthropic は、Scion のうまくいった部分を各社が git のモデルから離れずに取り入れられるように、考え方を共有する、という立場を取っています。記事が挙げている方向性は次のとおりです。
- git のサーバーは、git のクライアントと同じ作りでなくてよい
- Git のホスティングサービスが、Scion のようなサーバー側の RPC を、できれば標準化された形で提供し、git のクライアントがそれを使えるようにする
- 取得時のやりとり(negotiation)のプロトコルも、今の形である必要はない
- sparse や shallow の機能が、互いにうまく組み合わさるようにする
記事は最後に、20年近く何百万人もの開発者のために git をスケールさせてきたコミュニティへの敬意を示しています。そのうえで、GitHub や GitLab、オープンソースのコミュニティと協力していきたい、と締めくくっています。
僕が気になったところ
僕が一番面白いと思ったのは、Anthropic が git の設計を否定しているのではない点です。話は「自分たちの使い方が、すでに git の想定から外れていた」という気づきから始まっています。Anthropic は git を実際には集中型として使っていて、クライアントは常にオンラインでした。それなら、その前提でソース管理を作り直せばよい、という流れです。言われてみれば当たり前ですが、僕は、ここに気づけるかどうかが分かれ目なのだと思います。
もうひとつ僕が気になったのは、エージェント環境での数字です。新しい worktree の作成が 7.1 分から 5.1 秒になった、という変化は、僕のような個人の規模でもイメージしやすいものでした。僕は複数の Claude Code のセッションを worktree で分けて並行に走らせていますが、リポジトリが小さいので、worktree を作る時間を気にしたことはありません。それでも、エージェントの数が増えるほど準備の時間が全体の待ち時間に効いてくる、という構図はよく分かります。
エンジニアの役割が「Claude に『だめ』と言うこと」だった、という話も、僕の印象に残りました。人がコードを書く速さで Claude に勝てなくなっても、システム全体の制約を知っていて、そこから外れた実装を止められるのは人だ、ということです。僕自身も、Claude Code に任せる範囲が広がるほど、何を書かせるかより、何をさせないかを考える時間が増えていると感じています。
まとめ
今回の記事のポイントをまとめると、次のようになります。
- Anthropic のモノレポへのマージは、2026年5月の1日約2,500件から、9月には1日3万件超に増えた
- Anthropic は git のミラーやスナップショットで持ちこたえてきたが、履歴約 100 GB、CI のチェックアウトが1日約2,500万回という規模で限界が来た
- Anthropic は自作のバージョン管理システム Scion を作り、5か月でモノレポを git から移した。コードレビューツールの Antique も同時に作った
- Scion の原則は、クライアントは常にオンライン、計算はサーバー側、ソース管理を API として提供、水平スケール、軽くロックなしのコミット、作業コピーは必要な分だけ、の6つ
- Scion はチェックアウトを daemon・cache・server の3層のキャッシュで返す。基盤の規模は git ミラーの200分の1になり、チェックアウトはおよそ100倍速くなった
- Scion を作ったのは7人のチーム。記事によると、エンジニアの価値は下がっていないが、仕事の中身は変わった。このプロジェクトでは、Claude に「だめ」と言うことがエンジニアの役割になる場面が多かった
- Anthropic は、Scion をそのまま他社に提供するのは難しいと見ている。その代わりに考え方を共有し、git に還元するために、GitHub や GitLab、オープンソースのコミュニティと協力していきたいとしている
Claude Code を使っていて、コードを書く速さに周りの仕組みが追いつかないと感じたことのある方にとって、この記事はその先で何が起きるかを知るよい材料になると思います。気になった方は、ぜひ元の記事も読んでみてください。