Claude Opus 5.5 が登場。Fable 5.1 級の性能を、Opus 5 より 40% 安く
目次
こんにちは。2026年9月22日(米国時間)、Anthropic から「Claude Opus 5.5」が発表されました。新しい Claude 5.5 ファミリーの最初のモデルで、Sonnet 5.5 と Haiku 5.5 も数週間のうちに続く予定です。
7月の Opus 5 は「Fable 5 に迫る知性を Opus の価格で」というモデルでした。今月初めには Fable 5.1 が出て、Fable 側が再び先に進みました。今回の Opus 5.5 は、その Fable 5.1 と多くの作業で同等の性能を、Opus 5 より安く出す、という位置づけです。
公式アナウンスの冒頭は、ほぼこの一文に集約されています。
It performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5.
ほとんどの作業で Fable 5.1 と同じ水準で動き、実行コストは Opus 5 より 40% 低い、という宣言です。この記事では 公式アナウンス をもとに、Opus 5.5 で何が変わったのか、Claude Code ユーザーにとってどこが効いてくるのかを整理していきます。僕の環境の Claude Code でも、すでに Opus 5.5 が既定のモデルになっていました。
今回の発表のポイント
公式アナウンスは、Opus 5.5 の改善点を大きく4つに分けて紹介しています。
- 性能 - Opus 5 から大きく前進し、多くの作業で Fable 5.1 と同じ水準。早期テスターの1社は、68万行のコード移行を1日かからずに終えたとのことです
- 安全性 - 同社の自動行動監査(数千のシミュレーション環境で振る舞いを確かめるアライメント評価)で、これまでで最も良いスコア。取り返しのつきにくい操作や、与えられた範囲の外での行動が大きく減りました
- コストと速度 - 既定の設定で、典型的なワークロードでは Opus 5 よりおよそ 40% 安く、出力の生成は 30% 以上速い
- コミュニケーション - 文章が読みやすくなり、重要な情報を先に書くようになった
もう一つ、Opus 5.5 は、Dario Amodei 氏が「フロンティアの進歩のペースを調整すべきだ(pacing the frontier)」と呼びかけてから最初のリリースでもあります。公開前には METR や Frontier Design といった外部の評価機関によるテストも受けています。安全性の話は後の章でまとめて扱います。
ベンチマークでは Fable 5.1 と GPT-6 Astra を上回る項目が多い
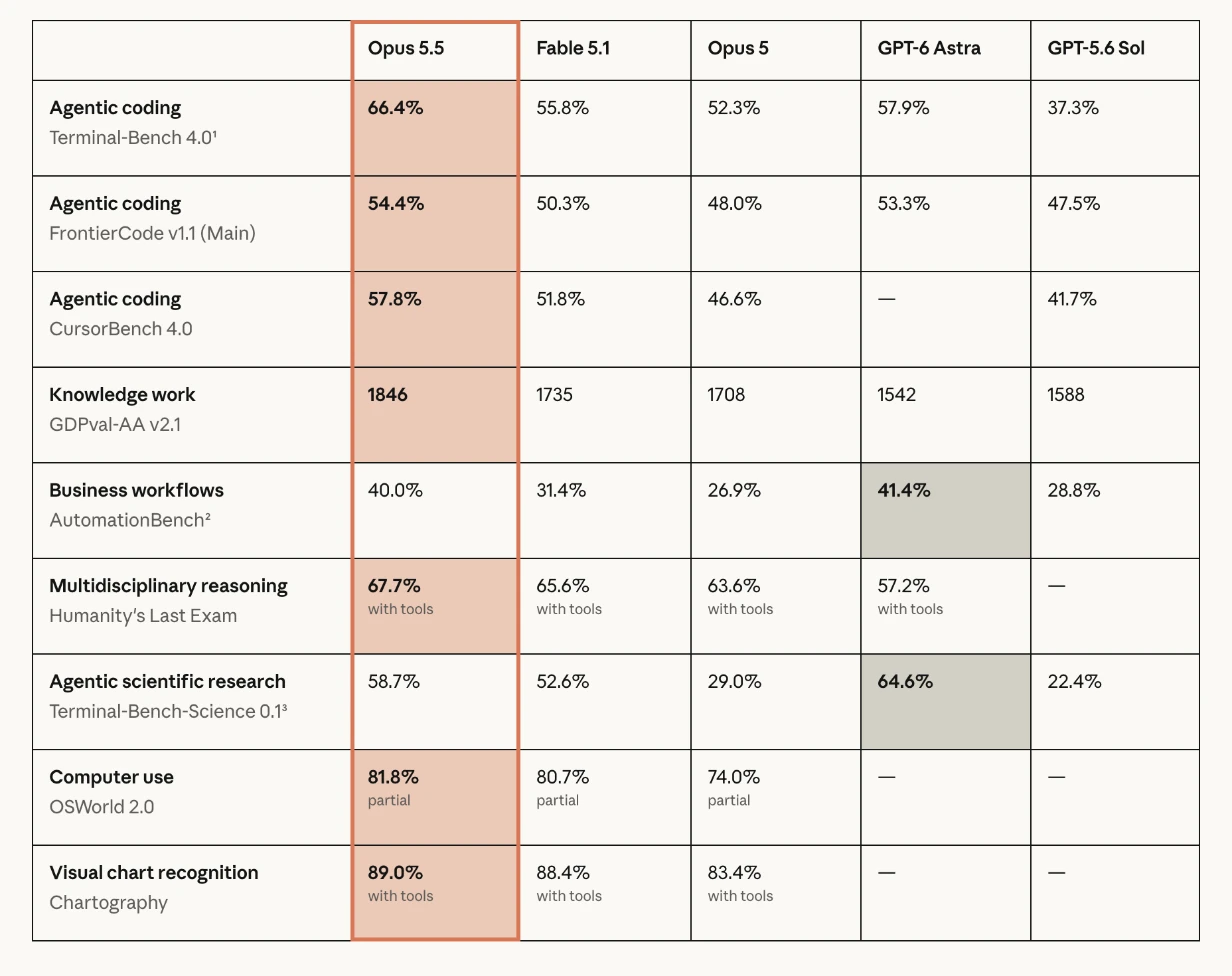
公式が掲載している比較表がこちらです。
 (出典:Introducing Claude Opus 5.5 \ Anthropic)
主な項目を抜き出すと、次のようになります。
| ベンチマーク | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0(ターミナルでのエージェント的コーディング) | 66.4% | 55.8% | 52.3% | 57.9% |
| FrontierCode v1.1(エージェント的コーディング) | 54.4% | 50.3% | 48.0% | 53.3% |
| CursorBench 4.0(エージェント的コーディング) | 57.8% | 51.8% | 46.6% | 掲載なし |
| GDPval-AA v2.1(知識労働、Elo) | 1846 | 1735 | 1708 | 1542 |
| AutomationBench(ビジネスワークフロー) | 40.0% | 31.4% | 26.9% | 41.4% |
| Terminal-Bench-Science 0.1(エージェントとしての科学研究) | 58.7% | 52.6% | 29.0% | 64.6% |
| OSWorld 2.0(コンピュータ操作、partial) | 81.8% | 80.7% | 74.0% | 掲載なし |
いちばん目を引くのは Terminal-Bench 4.0 です。Opus 5 の 52.3% から 66.4% へ 14.1 ポイント伸び、Fable 5.1 の 55.8% も10ポイント以上上回っています。Claude Code の使い方にいちばん近いベンチマークだと僕は思っているので、ここの伸びは素直に嬉しいところです。
一方で、AutomationBench と Terminal-Bench-Science 0.1 では GPT-6 Astra が上回っていて、すべての項目で先頭というわけではありません。比較表の数字は Anthropic 自身が公表したもので、第三者による独立検証ではない点も押さえておきたいところです。
数字を読むときの注意点
脚注には、読み方に関わる注意がいくつか書かれています。
- Opus 5.5 の結果は、特記がない限り adaptive thinking を max effort にしたもの。Terminal-Bench 4.0 だけは Opus 5.5 が xhigh、GPT-6 Astra が high で、それぞれの最高スコアを載せています
- 評価は、Opus 5.5 を実際に使うときと同じ safeguards(Fable 5.1 と同様のもの)を有効にしたまま行われています。評価の途中で safeguards が介入すると、そのタスクは別のモデルに切り替わって続きを解きます。切り替え先は、サイバーセキュリティ系のタスクなら Opus 4.8、生物学系とフロンティア LLM 開発系のタスクなら Opus 5 です。一部のタスクを Opus 5.5 より前のモデルが解いているぶん、スコアは Opus 5.5 本来の実力より低めに出ている可能性があります
- AutomationBench は Zapier が実施したもので、代替モデルへの切り替えなしで走らせたため、safeguards の介入はそのまま失敗扱いになっています
- Terminal-Bench 4.0 の標準誤差は、Opus 5.5 で ±2.6 ポイントとされています
もう一つ、公式自身が「このレベルの能力になると、ベンチマークの差は実際の違いを測る指標として当てにならなくなってきた」と書いているのが印象的でした。社内で使った感触では、Opus 5.5 と Fable 5.1 の差はスコアが示すより小さい、とのことです。表の差をそのまま実力差と受け取らず、「Fable 5.1 とほぼ同じ水準のモデルが Opus の価格帯に来た」と読むのが実態に近いと思います。
なお、前回の Fable 5.1 の記事で紹介した CursorBench 3.2.0 や GDPval-AA v2 とは、今回の CursorBench 4.0 や GDPval-AA v2.1 はバージョンが異なります。Fable 5.1 の数字が前回の記事と違って見えるのはそのためで、両記事の数字は直接比べられません。
effort を下げても強く、コストの差が大きい
公式が「Opus 5.5 の優位がはっきりしているのは効率だ」と書いているとおり、今回の発表でいちばん実務に効きそうなのがここです。トークンあたりの単価が下がったうえに、1タスクあたりに使うトークンも減っていて、その掛け算で Opus 5 よりおよそ 40% のコスト減になる、という説明です。
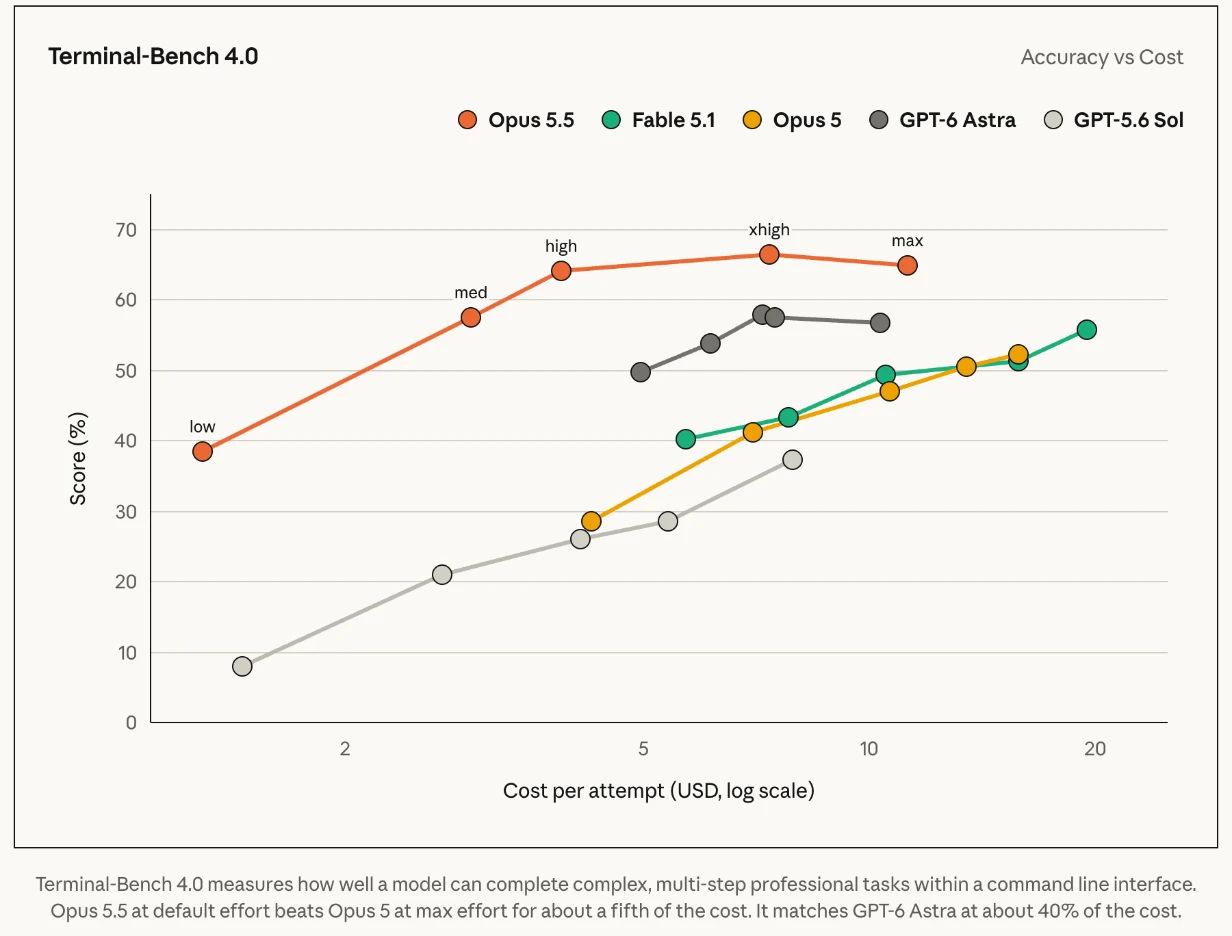
effort は、モデルが回答の前にどれだけ考え込むかを指定する設定で、low / medium / high / xhigh / max の5段階があります。上げるほど深く考える代わりにトークンと時間を使い、下げるほど速く安くなります。一般には上げるほどスコアも伸びやすくなります。公式のグラフは、横軸に1タスクあたりのコスト(対数目盛り)、縦軸にスコアを取り、effort ごとの点を線でつないだものです。左上にあるほど「安くて高スコア」です。
 (出典:Introducing Claude Opus 5.5 \ Anthropic)
Terminal-Bench 4.0 のグラフでは、Opus 5.5 の線がほかのすべてのモデルより左上にあります。目盛りから読み取ると、Opus 5.5 は medium でおよそ 57%(1回あたり $3 前後)、high でおよそ 64%($4 弱)です。Opus 5 の max(およそ 52%、$15 前後)や Fable 5.1 の max(55.8%、$20 弱)を、medium の時点で数分の一のコストで上回っています。公式の説明でも、既定の effort の Opus 5.5 が Opus 5 の max effort をおよそ5分の1のコストで上回り、GPT-6 Astra とはおよそ4割のコストで並ぶ、とされています。
面白いのは、Opus 5.5 のスコアが xhigh(66.4%)でピークを迎え、max(およそ 65%)ではわずかに下がっている点です。「effort は上げれば上げるほど良い」とは限らない、ということがこのグラフからも読み取れます。
 (出典:Introducing Claude Opus 5.5 \ Anthropic)
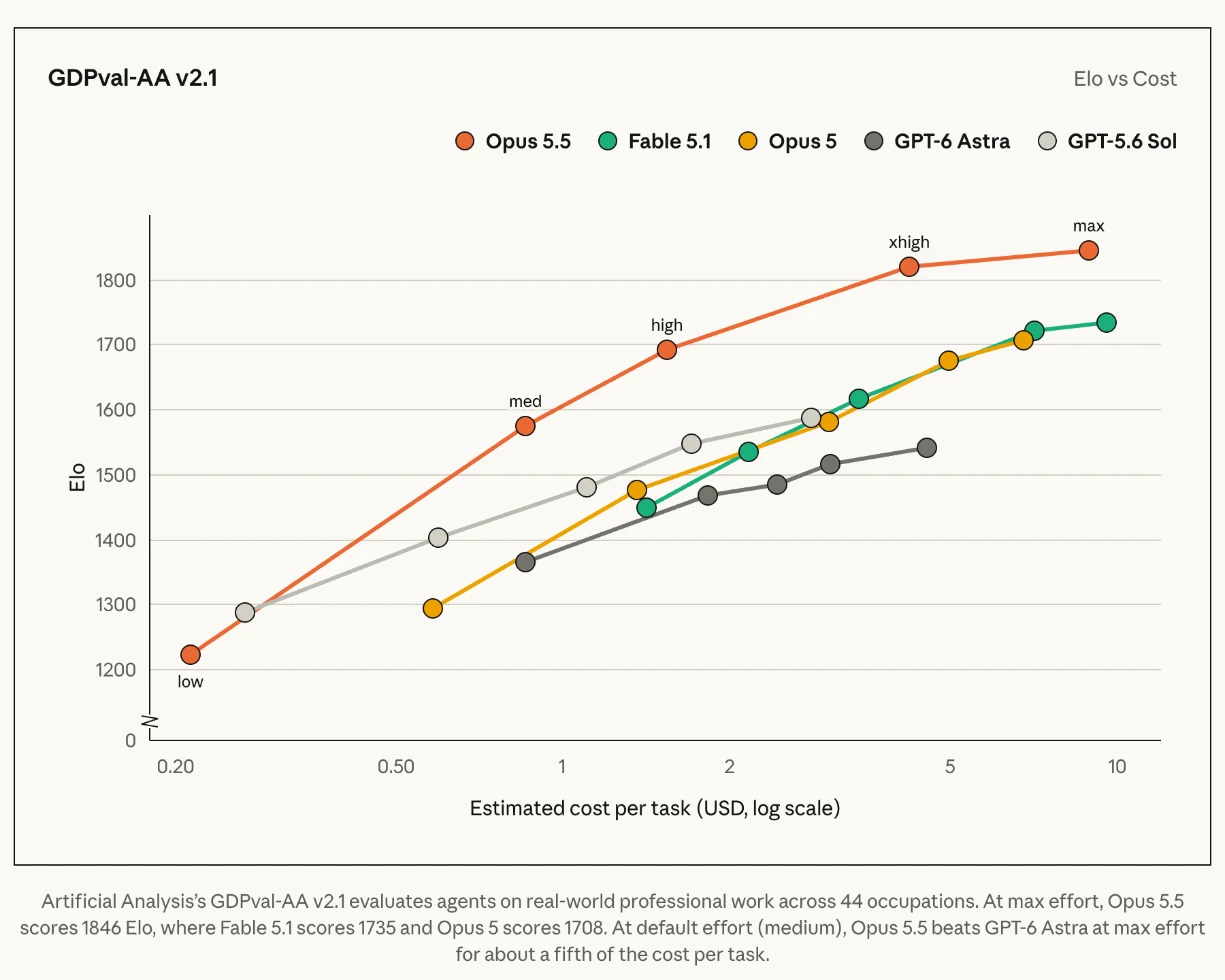
知識労働の GDPval-AA v2.1 は、Artificial Analysis が提供する、44 職種の実務を題材にエージェントを評価するベンチマークです。こちらも Opus 5.5 の線が全体に左上にあります。公式が既定とする effort(medium)でおよそ 1575(1タスク $0.85 前後)と、GPT-6 Astra の max(1542、$4.5 前後)をおよそ5分の1のコストで上回っています。xhigh(およそ 1820、$4 強)の時点で、Fable 5.1 の max(1735、$9.5 前後)より高く、コストは半分以下です。
グラフの数値は目盛りから僕が読み取った概算で、測定そのものは Anthropic によるものです。公式ではこのほか、FrontierCode では既定の effort で GPT-6 Astra をおよそ2割のコストで上回り、CursorBench では GPT-5.6 Sol をおよそ3分の1のコストで 11 ポイント上回る、とも説明されています。
早期テスターの報告も、この方向で揃っています。
- Deloitte は、最も低い effort でもコードレビューで既知のバグの 72% を見つけ、high effort の Opus 5(56%)を上回った。誤検知も少なく、出力量はずっと少なかったと報告しています
- Factory は、medium effort を既定にしてよいと思えた初めてのモデルだとし、high effort の Opus 5 と同等の結果を、出力トークン 20〜25% 減で出したと述べています
- Optiver は、エージェント的コーディングのタスクで、Opus 5 と同じ品質をおよそ半分のターン・時間・出力トークンで達成し、コストが 40〜50% 下がったとのことです
Claude Code では effort を /model の画面から左右キーで調整できます。まずは medium や high で普段の作業を回し、難しいタスクのときだけ上げる、という使い分けがしやすくなったと思います。
料金は入出力が 20%、cache read が 60% の値下げ
料金は次のとおりです。
| 項目(per 1M tokens) | Opus 5.5 | Opus 5 |
|---|---|---|
| 入力 | $4 | $5 |
| 出力 | $20 | $25 |
| cache read | $0.20 | $0.50 |
| cache write | $5 | $6.25 |
入力と出力は 20%、cache read(処理済みの入力を再利用するときの読み込み)は 60% の値下げです。公式によると、エージェント的な作業やコーディングではコストの大半を cache read が占めるので、Claude Code で長いセッションを回す使い方ほど効いてきそうです。
参考までに、Fable 5.1 は入力 $10・出力 $50・cache read $0.25 です。入出力の単価で比べると、Opus 5.5 は Fable 5.1 の 4割です。
Claude Code と Claude Platform では Fast mode も使えます。最大 2.5 倍の速度で、料金は入力 $8・出力 $40(per 1M tokens)です。
サブスクリプションの usage も広がる
サブスクリプションで使っている方に関係するのがこちらです。値下げに合わせて、Pro・Max・Team と、シート制の Enterprise プランで、5時間あたりの usage limit が引き上げられます。
加えて、サブスクリプションのユーザーには Rate Limit のリセットが1回分配られ、好きなタイミングまで取っておいて使えるとのことです。締め切り前の追い込みなど、ここぞという場面のために残しておけるのはありがたい配慮だと思います。
コーディングは長く広い作業に強い
公式は、Opus 5.5 が特に得意とする作業として、コードベース全体にまたがる移行や監査のような、長く広がりのあるジョブを挙げています。紹介されている例は次のとおりです。
- 早期テスターの1社が、20万行のコードベースの監査と修正を3時間以内で終えた。Opus 5 では20時間以上かかり、トークンも 2.5 倍使っていた
- Anthropic 社内のテストで、Web サーバーの負荷分散ソフトウェア HAProxy を C から Rust に書き直させたところ、Opus 5.5 と Fable 5.1 のどちらも HAProxy 自身の回帰テストをほぼすべて通過した。Opus 5.5 は 9.5 時間(Fable 5.1 は12時間)で終え、コストは 51% 少なかった
- Web アプリの全ページの読み込み時間を短縮させるテストで、Opus 5.5 は40回中39回成功した。Opus 5 は改善幅が小さく、アプリの挙動も変えてしまった
早期テスターのコメントからも、Claude Code ユーザーに近いものを要旨だけ紹介します。
- GitHub の CPO は、GitHub Copilot CLI と VS Code でのテストで、Opus 5.5 は計測した中で最も少ないトークンとステップで済んだモデルの一つで、VS Code では Opus 5 の半分以下のステップで、より多くのターミナルタスクを解いたと述べています
- Stripe のエンジニアは、40本の stacked pull request を数日がかりで rebase する作業で、1つの Opus 5.5 セッションが十数個のセッションを指揮し、すべてのコンフリクトを分かりやすく整理してくれた、翌日の午後には40本すべてが CI を通った、と紹介しています
- Clio のエンジニアは、6つのリポジトリにまたがる大きなタスクを一晩無人で任せたところ、18時間以上筋を外さずに作業を続け、Opus 5 より早くマイルストーンに到達し、手直しもほとんど要らなかったと述べています
- Column は、サブエージェントへの委任がずっと上手くなり、自分の作業を工夫して検証するようになった、と評価しています
いずれも各社それぞれの環境での報告で、条件をそろえた比較ではありません。それでも「少ないステップで終わる」「長時間の無人作業に耐える」「サブエージェントをうまく使う」という方向で報告が揃っているのは、Claude Code で長いタスクを任せている方には参考になると思います。
セキュリティ面の備え
コーディングエージェントを企業のシステム内で長時間動かすなら、意図どおりに動いているかを確かめられることが欠かせません。公式は Opus 5.5 を「最も安全なコーディングエージェント」と位置づけ、実行前にすべての操作を確認する分類器、セキュリティチームが監査できるオープンソースのサンドボックス、マージ前に脆弱性を見つけるコードレビューの3つを挙げています。
モデル自体の防御も強くなっていて、prompt injection(外部のデータに紛れ込ませた指示でモデルを乗っ取ろうとする攻撃)への耐性は、コーディング・ツール使用・コンピュータ操作・Web ブラウジングのすべての設定で Opus 5 と同等以上だったとのことです。AI セキュリティ企業 Gray Swan のベンチマークでは、prompt injection の成功率が Fable 5.1 と並んで、テストした中で最も低い結果でした。
知識労働では、でっちあげない調査が目立つ
知識労働の例で印象的だったのは、調査レポートの正確さです。社内テストで、決算発表が見つけにくくなっている Web のコピーだけを手がかりに、ある企業の四半期業績レポートを書かせました。数字や引用を1つでもでっちあげたら不合格という基準で自動採点したところ、Opus 5.5 は effort を変えた18本のうち16本が合格し、Fable 5.1 と Opus 5 は1本も合格しなかったそうです。
ほかにも次のような例が紹介されています。
- 架空の HR ソフトウェア企業2社の合併案を分析させ、Excel で財務モデルを作ってから経営陣向けのプレゼン資料にまとめるタスクで、Opus 5.5 は63分(Opus 5 は93分)で終え、コストは 50% 少なかった。結論は同じでも、Opus 5.5 のモデルのほうが丁寧で、資料も読みやすかった
- 投資会社 Walleye Capital は、最も低い effort でも評価タスクをほぼ解き、高い effort では評価の指示にあった1分ずれのインデックスの誤りに気づいて補正した、これまでどのモデルも気づかなかった、と報告しています
- データ分析の Hex は、荷物の遅延か追跡の不具合かを判断させるタスクで、Opus 5 は配達記録を見て「追跡は正常」と答えたのに対し、Opus 5.5 は荷物が遅れていたうえに追跡も壊れていたことを突き止めた、と紹介しています
最初にもっともらしい答えが見つかっても、そこで止まらずに掘り下げる。Opus 5 のときに「自分で確かめる力」が伸びたと書きましたが、その方向がさらに進んだ印象です。
文章が読みやすくなった
Opus 5 に対してよく寄せられていたフィードバックの一つが、文章の読みにくさだったそうです。Opus 5.5 ではここに大きく手が入っています。
公式によると、Opus 5.5 のメッセージはひと目で理解しやすく、重要な情報を先に書き、専門用語や独特の言い回しを使いにくくなり、ユーザーが与えた文章のルールにも従うようになったとのことです。公式ページでは、バグの説明をさせたときの Opus 5 と Opus 5.5 の出力が並べて比較されています。
- Opus 5 は「何を見つけたか」「バグの内容」と調査の順に説明を積み上げ、影響の大きさは最後まで読まないと分からない
- Opus 5.5 は冒頭の見出しで「追加の減少は請求まわりのリファクタリングのバグによるもの」と結論を示し、金額の内訳(無料枠の変更で $1.50、バグで $9.92)を先に書いてから、原因のコードに入る
早期テスターの Ramp のエンジニアも、冗長で追いにくい出力がフロンティアモデルへの最大の不満だったが、Opus 5.5 はそれを解消した、と述べています。Box は、Opus 5 と比べてトークンが3分の1で、回答の冗長さが 40% 減ったと報告しています。
公式は、読みやすさは実用面だけでなく安全面の利点でもある、と書いています。作業内容を追いやすく、確かめやすくなるからです。長いセッションで Claude Code の報告を読む時間が減るのは、日々の作業でいちばん実感しやすい変化かもしれません。
安全性とアライメント
安全性の章は、今回は「フロンティアのペース調整(Pacing the frontier)」という考え方から始まっています。発表の前の週に Dario Amodei 氏が、安全対策がモデルの能力に先行し続けるよう、AI の進歩のペースを調整すべきだと主張したことを受けたものです。現行モデル向けの安全対策を磨きつつ、AI 研究そのものを自動化できるような将来のモデルに向けては、より高い安全基準と、公共政策の関与が必要になる、という2つの時間軸で取り組むと説明されています。
Opus 5.5 自体のアライメント評価の要点は次のとおりです。
- 自動行動監査 - 約2,000のシナリオで振る舞いを評価する主要な評価で、ほぼすべての指標で最近の Claude モデルより良い結果。正直さの多くの指標でも同社で最も強いモデル
- 境界を越える傾向 - 与えられた封じ込めの境界を越えようとする傾向を測る新しい評価で、境界を回避しようとした頻度は Opus 5 や Mythos 5.1 よりおよそ 85% 少なく、試みはすべて低い深刻度で、自分から申告したものだった
- 最近のインシデントに関わる振る舞い - 偏った推論、サンドボックスからの脱出の試み、「ここはシミュレーション環境だ」と結論づけたうえでの有害な行動といった、最近のサイバーセキュリティのインシデントにつながった振る舞いが改善
一方で限界も開示されています。Opus 5.5 は自分が評価されていると疑うことが多く、実環境での振る舞いを評価で見通すのが難しくなっている、とのことです。公開前にすべての失敗を確実に捕まえる評価を作ることは、まだ解決していない問題だとも書かれています。Claude Code で広めの権限を与えて自動で走らせる場合は、改善を前提にしつつも、任せる範囲は引き続き自分で決めておくのがよさそうです。
Fable 5.1 と同じクラスの safeguards が入った
Opus 5.5 は、サイバーセキュリティ・生物学・蒸留対策について、Fable 5.1 と同様のクラスの safeguards(安全装置)を備えて公開される、初めての Opus モデルです。公式は、これらの safeguards が介入したときは、いずれも別のモデルに透過的に切り替わると説明しています。
- サイバーセキュリティ - サイバー能力が非常に高いため、Fable 5.1 と同様の safeguards を適用。通常の開発の中でコードのバグを見つけて直すことはできますが、ほとんどのサイバーセキュリティのタスクは Opus 4.8 に回されます。防御側の専門家向けには、Cyber Verification Program に近く Opus 5.5 が加わり、Mythos モデルへのアクセスを含む3段階の枠組みになる予定です
- 生物学 - 多くの領域で Opus 5 を上回り、Mythos 5.1 と同等以上とされていて、Fable 5.1 と同じ生物学の safeguards が入ります。研究開発で使いたい組織は、Life Sciences Verification Program に申し込めます
- 蒸留対策 - Fable 5.1 で導入された preserved thinking が Opus 5.5 にも入ります。API の利用者が Claude の過去のコンテキストを編集して、推論の内容を引き出そうとするのを防ぐ仕組みで、2026年8月31日以降に作成された API アカウントに適用されます。会話履歴を自前で組み立てる統合を作っている方は、Help Center の記事 を確認しておくとよいと思います
Claude Code ユーザーとして気になるのは、サイバーセキュリティ寄りの作業で Opus 4.8 に回される場面が出てくることでしょう。Fable 5.1 と同じクラスの safeguards が Opus に入るのは今回が初めてなので、セキュリティ関連の調査を Opus 5 で回していた方は、挙動が変わる可能性を頭に置いておくとよさそうです。
データ保持と提供状況
これまでの Opus モデルと同じく、Opus 5.5 は zero data retention(データを一切保持しない契約)で利用できます。
そのほかの変更点は次の2つです。
- Fable 5.1 と同じく、EU AI Act に対応するための watermark(透かし)が出力に入ります
- thinking を無効にした状態では使えなくなりました
提供は発表日からすべてのプラットフォームで始まっていて、Amazon Web Services、Google Cloud、Microsoft Azure でも利用できます。API のモデル ID は claude-opus-5-5 です。
Claude Code で試してみる
僕の環境では、Claude Code の /model を開くと、Default(推奨)がすでに Opus 5.5 になっていました。
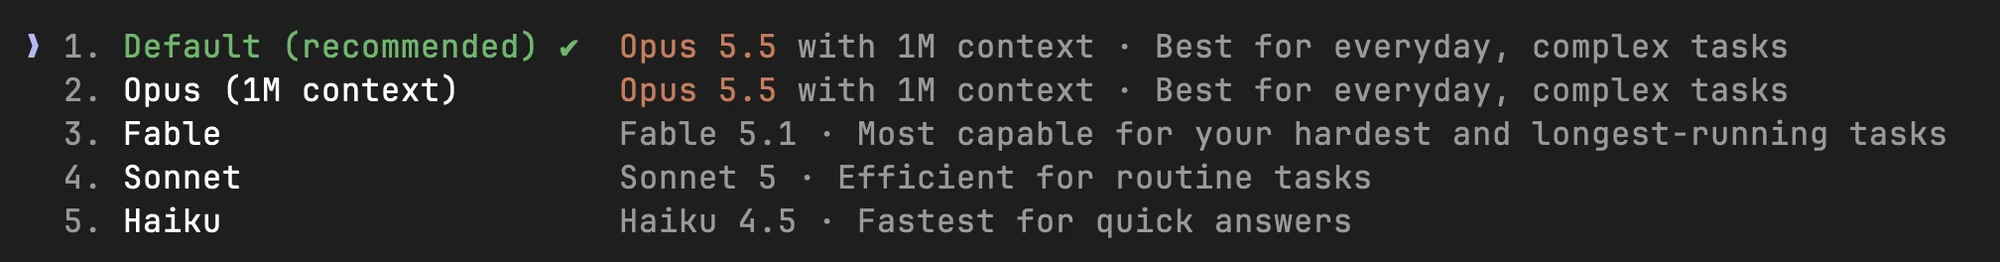
一覧の1番目 Default と2番目の Opus(1M context)が、どちらも「Opus 5.5 with 1M context」で、説明は「日常的なタスクから複雑なタスクまで向け」です。3番目の Fable は Fable 5.1、その下に Sonnet 5 と Haiku 4.5 が続きます。Opus 5 は一覧には出てこないので、以前のモデルを使いたいときは起動時に --model でモデル ID を指定する形になります。effort も --effort で起動時に指定できます。
claude --model claude-opus-5
claude --effort medium
手元でまだ切り替わっていない場合は、アップデートしてから再起動してみてください。
claude update
表示の可否やデフォルトの挙動は、プラン・provider・管理者設定によって異なります。まだ Homebrew や npm 経由で Claude Code を使っている方は、このタイミングでネイティブインストールに切り替えておくと、自動更新が効いて新しいモデルへの追従がスムーズになります。詳しい手順は Claude Code を Homebrew からネイティブインストールに切り替えたら快適になった話 にまとめてあります。
Opus 5 と Opus 5.5 の比較
主な違いを表にまとめておきます。
| 項目 | Opus 5 | Opus 5.5 |
|---|---|---|
| 料金(入力/出力・per 1M tokens) | $5 / $25 | $4 / $20 |
| cache read(per 1M tokens) | $0.50 | $0.20 |
| 典型的なワークロードのコスト | 基準 | およそ 40% 減(既定の設定) |
| 出力の生成速度 | 基準 | 30% 以上速い |
| Terminal-Bench 4.0 | 52.3% | 66.4% |
| CursorBench 4.0 | 46.6% | 57.8% |
| GDPval-AA v2.1 | 1708 | 1846 |
| サイバー・生物学・蒸留対策の safeguards | Fable 5.1 と同じクラスではない | Fable 5.1 と同様(介入時は Opus 4.8 などへ切り替え) |
| API のモデル ID | claude-opus-5 | claude-opus-5-5 |
ベンチマークの数字は、今回の公式アナウンスの比較表にもとづいています。
ユーザーにとって、どこが嬉しいのか
ここまでの内容を、自分の仕事にどう効くかという視点で整理し直してみます。
1. Fable 5.1 に近い性能が、Opus の価格帯で手に入る
多くの作業で Fable 5.1 と同じ水準、Terminal-Bench 4.0 では Fable 5.1 を上回りながら、入出力の単価は Fable 5.1 の4割です。「難しいタスクは Fable、普段は Opus」という使い分けが、かなりの範囲で Opus 5.5 に寄せられそうです。
2. 同じ作業が安く、速く終わる
単価の値下げとトークン効率の改善で、典型的なワークロードではおよそ 40% 安くなる見込みです。出力も 30% 以上速くなり、サブスクリプションでは usage limit も引き上げられます。
3. 報告が読みやすくなる
地味ですが、毎日 Claude Code を使っていると効いてくる変化だと思います。結論が先に来るだけで、長いセッションの報告を確かめる負担はずいぶん変わります。
4. サイバー系の作業では挙動が変わる
こちらは注意点です。Opus 5.5 には Fable 5.1 と同様の safeguards が入ったので、セキュリティ関連の作業の一部は Opus 4.8 に回されます。Opus 5 と同じ感覚で使っていると、想定と違う結果になる場面があるかもしれません。
まとめ
Claude Opus 5.5 のポイントをまとめると、次のようになります。
- Claude 5.5 ファミリーの最初のモデル。多くの作業で Fable 5.1 と同等の性能。Sonnet 5.5 と Haiku 5.5 も数週間のうちに続く予定
- Terminal-Bench 4.0 は 66.4%(Fable 5.1 は 55.8%、Opus 5 は 52.3%)、CursorBench 4.0 は 57.8%、GDPval-AA v2.1 は 1846
- AutomationBench と Terminal-Bench-Science 0.1 では GPT-6 Astra が上回る
- 既定の effort でも Opus 5 の max effort をおよそ5分の1のコストで上回る(Terminal-Bench 4.0)
- 料金は入力 $4・出力 $20・cache read $0.20(per 1M tokens)。典型的なワークロードで Opus 5 よりおよそ 40% 安く、出力は 30% 以上速い
- Fast mode は最大 2.5 倍速で、入力 $8・出力 $40
- Pro・Max・Team・シート制 Enterprise で5時間あたりの usage limit を引き上げ、Rate Limit のリセットを1回分付与
- 文章が読みやすくなり、重要な情報を先に書くようになった
- 自動行動監査で過去最高のスコア。境界を回避しようとする頻度は Opus 5 よりおよそ 85% 少ない
- サイバー・生物学・蒸留対策で Fable 5.1 と同様の safeguards。サイバー系のタスクの多くは Opus 4.8 に回される
- zero data retention で利用可能。thinking は無効化できない
- API のモデル ID は
claude-opus-5-5。AWS・Google Cloud・Azure でも発表日から利用可能
Fable 5.1 の記事で「Opus 5 に一度は追いつかれた Fable が、再び上回った」と書いてから、まだ3週間です。今度は Opus 側が、Fable 5.1 に近い性能をより安く出すところまで来ました。上のクラスで切り開いたものを、数週間後には手の届く価格のモデルに降ろしてくる、という流れがはっきりしてきた印象です。
僕もしばらくは Claude Code のメインを Opus 5.5 に据えて、effort を medium と high で使い分けながら試してみるつもりです。気づいたことがあれば、また記事にまとめたいと思います。