Claude Opus 5.5 등장. Fable 5.1급 성능을, Opus 5보다 40% 저렴하게
목차
안녕하세요. 2026년 9월 22일(미국 시간), Anthropic에서 'Claude Opus 5.5'를 발표했습니다. 새로운 Claude 5.5 패밀리의 첫 번째 모델로, Sonnet 5.5와 Haiku 5.5도 몇 주 내로 이어질 예정입니다.
7월의 Opus 5는 'Fable 5에 근접한 지능을 Opus 가격으로'라는 콘셉트의 모델이었습니다. 이달 초에는 Fable 5.1이 출시되면서 Fable 측이 다시 앞서 나갔습니다. 이번 Opus 5.5는 그 Fable 5.1과 대다수 작업에서 동등한 성능을 Opus 5보다 저렴하게 제공한다는 포지셔닝입니다.
공식 발표의 서두는 거의 이 한 문장으로 집약되어 있습니다.
It performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5.
대부분의 작업에서 Fable 5.1과 동등한 수준으로 작동하며, 실행 비용은 Opus 5보다 40% 낮다는 선언입니다. 이 글에서는 공식 발표를 바탕으로 Opus 5.5에서 무엇이 바뀌었는지, Claude Code 사용자에게 어떤 점이 유용한지 정리해 보겠습니다. 제 환경의 Claude Code에서도 이미 Opus 5.5가 기본 모델로 설정되어 있었습니다.
이번 발표의 핵심 포인트
공식 발표에서는 Opus 5.5의 개선점을 크게 4가지로 나누어 소개하고 있습니다.
- 성능 - Opus 5에서 크게 진전하여 대다수 작업에서 Fable 5.1과 동등한 수준. 초기 테스터 기업 중 한 곳은 68만 줄에 달하는 코드 마이그레이션을 하루도 안 걸려 마쳤다고 합니다
- 안전성 - 자체 자동 행동 감사(수천 개의 시뮬레이션 환경에서 행동을 검증하는 얼라인먼트 평가)에서 역대 최고 점수 기록. 되돌리기 어려운 조작이나 주어진 범위를 벗어난 행동이 크게 줄었습니다
- 비용 및 속도 - 기본 설정 기준 일반적인 워크로드에서 Opus 5 대비 약 40% 저렴하며, 출력 생성 속도는 30% 이상 빠름
- 커뮤니케이션 - 문장이 한결 읽기 쉬워졌으며, 중요한 정보를 먼저 작성하도록 개선됨
또 하나, Opus 5.5는 Dario Amodei CEO가 "프론티어의 발전 속도를 조절해야 한다(pacing the frontier)"고 촉구한 이후 첫 릴리스이기도 합니다. 공개 전에는 METR, Frontier Design과 같은 외부 평가 기관을 통한 테스트도 거쳤습니다. 안전성에 관한 이야기는 뒷부분 섹션에서 모아서 다루겠습니다.
벤치마크에서는 Fable 5.1과 GPT-6 Astra를 앞서는 항목이 다수
공식 웹사이트에 게시된 비교표는 다음과 같습니다.
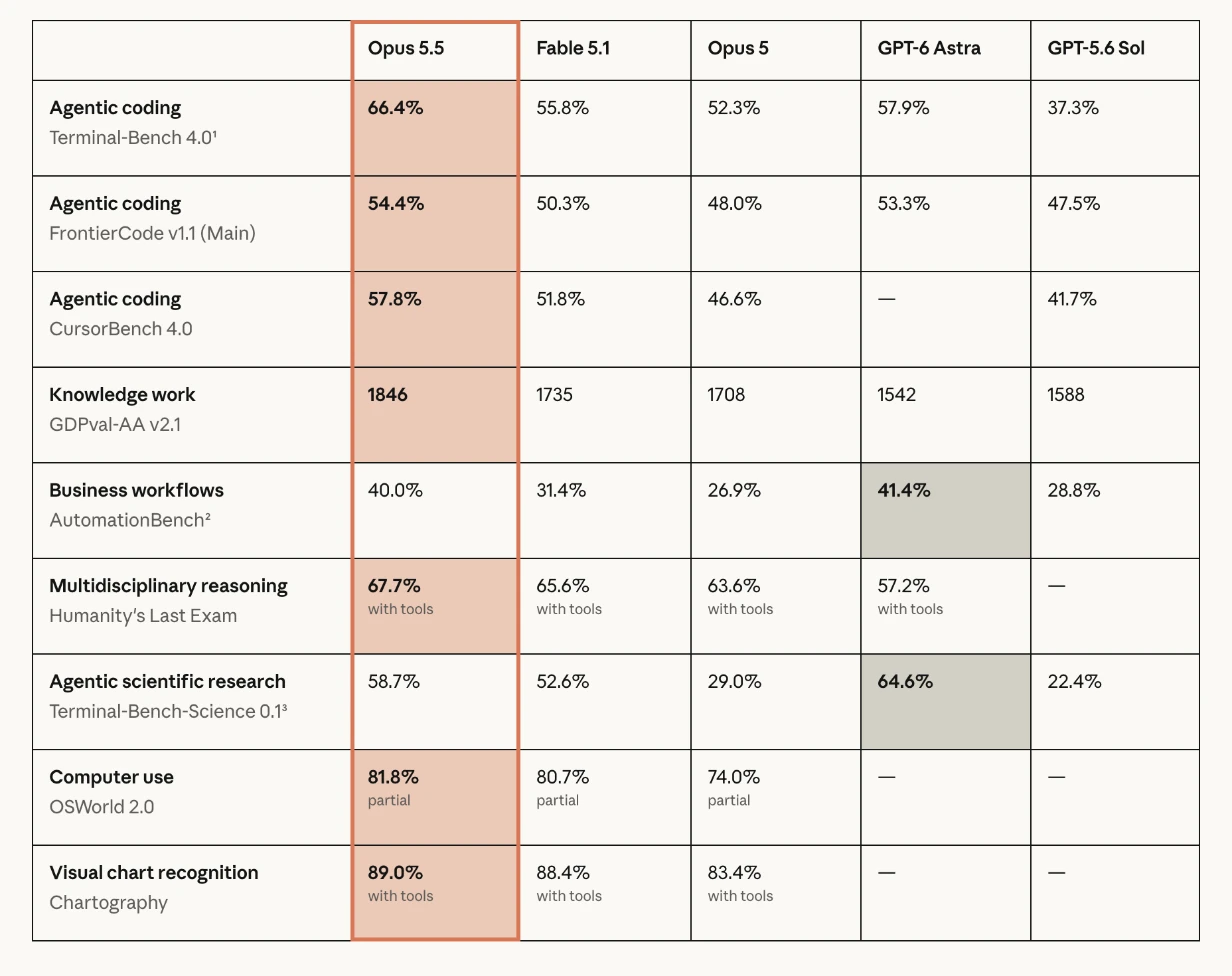 (출처: Introducing Claude Opus 5.5 \ Anthropic)
주요 항목을 발췌하면 다음과 같습니다.
| 벤치마크 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0(터미널 환경의 에이전틱 코딩) | 66.4% | 55.8% | 52.3% | 57.9% |
| FrontierCode v1.1(에이전틱 코딩) | 54.4% | 50.3% | 48.0% | 53.3% |
| CursorBench 4.0(에이전틱 코딩) | 57.8% | 51.8% | 46.6% | 기재 없음 |
| GDPval-AA v2.1(지식 노동, Elo) | 1846 | 1735 | 1708 | 1542 |
| AutomationBench(비즈니스 워크플로) | 40.0% | 31.4% | 26.9% | 41.4% |
| Terminal-Bench-Science 0.1(에이전트로서의 과학 연구) | 58.7% | 52.6% | 29.0% | 64.6% |
| OSWorld 2.0(컴퓨터 조작, partial) | 81.8% | 80.7% | 74.0% | 기재 없음 |
가장 눈에 띄는 것은 Terminal-Bench 4.0입니다. Opus 5의 52.3%에서 66.4%로 14.1%포인트 상승했으며, Fable 5.1의 55.8%도 10%포인트 이상 앞질렀습니다. Claude Code의 활용 방식에 가장 가까운 벤치마크라고 생각하기 때문에, 이 부분의 성능 향상은 무척 반갑습니다.
반면 AutomationBench와 Terminal-Bench-Science 0.1에서는 GPT-6 Astra가 앞서고 있어, 모든 항목에서 1위를 차지한 것은 아닙니다. 비교표의 수치는 Anthropic이 직접 공개한 것이며, 제3자에 의한 독립적 검증이 아니라는 점도 염두에 둘 필요가 있습니다.
수치를 볼 때 주의할 점
각주에는 수치를 해석할 때 참고해야 할 주의 사항이 몇 가지 적혀 있습니다.
- Opus 5.5의 결과는 별도 표기가 없는 한 adaptive thinking을 max effort로 설정한 값입니다. Terminal-Bench 4.0만 Opus 5.5가 xhigh, GPT-6 Astra가 high로 각각의 최고 점수를 게재했습니다
- 평가는 Opus 5.5를 실제 사용할 때와 동일한 safeguards(Fable 5.1과 유사한 수준)를 활성화한 상태로 진행되었습니다. 평가 도중 safeguards가 개입하면 해당 태스크는 다른 모델로 전환되어 작업을 이어갑니다. 전환 대상은 사이버 보안 관련 태스크의 경우 Opus 4.8, 생물학 및 프론티어 LLM 개발 관련 태스크의 경우 Opus 5입니다. 일부 태스크를 Opus 5.5 이전 모델이 수행했기 때문에, 점수가 Opus 5.5 본래의 실력보다 다소 낮게 나왔을 가능성이 있습니다
- AutomationBench는 Zapier가 실시한 것으로, 대체 모델로의 전환 없이 실행되었기 때문에 safeguards의 개입은 그대로 실패로 처리되었습니다
- Terminal-Bench 4.0의 표준 오차는 Opus 5.5 기준 ±2.6%포인트로 명시되어 있습니다
또 하나, 공식 측에서 직접 "이 수준의 능력에 도달하면 벤치마크 점수 차이는 실제 차이를 측정하는 지표로서 신뢰하기 어려워졌다"고 언급한 점이 인상적이었습니다. 사내 테스트 결과 Opus 5.5와 Fable 5.1의 차이는 점수가 보여주는 것보다 작다고 합니다. 표의 점수 차를 그대로 실력 차이로 받아들이기보다는 'Fable 5.1과 거의 대등한 수준의 모델이 Opus 가격대로 내려왔다'고 해석하는 편이 실질에 가까울 것입니다.
참고로 지난 Fable 5.1 관련 글에서 소개했던 CursorBench 3.2.0 및 GDPval-AA v2와 이번 CursorBench 4.0 및 GDPval-AA v2.1은 버전이 다릅니다. 지난 글과 Fable 5.1의 수치가 다르게 보이는 것은 이 때문이며, 두 글의 수치를 직접 비교할 수는 없습니다.
effort를 낮춰도 강력하며, 비용 차이가 큼
공식 측이 "Opus 5.5의 강점이 뚜렷하게 드러나는 부분은 효율성"이라고 밝혔듯, 이번 발표에서 실제 업무에 가장 큰 영향을 미칠 부분은 바로 이 지점입니다. 토큰당 단가가 인하되었을 뿐만 아니라 1개 태스크당 사용하는 토큰 수도 줄어들어, 그 결과 Opus 5 대비 약 40%의 비용 절감 효과가 난다는 설명입니다.
effort는 모델이 답변하기 전에 얼마나 깊이 고민할지 지정하는 설정으로, low / medium / high / xhigh / max의 5단계가 있습니다. 높일수록 깊이 생각하는 대신 토큰과 시간을 더 소모하고, 낮출수록 빠르고 저렴해집니다. 일반적으로 높일수록 점수도 오르기 쉽습니다. 공식 그래프는 가로축에 태스크당 비용(로그 스케일), 세로축에 점수를 두고 effort 단계별 포인트를 선으로 연결한 것입니다. 좌측 상단에 위치할수록 '저렴하면서 고득점'을 의미합니다.
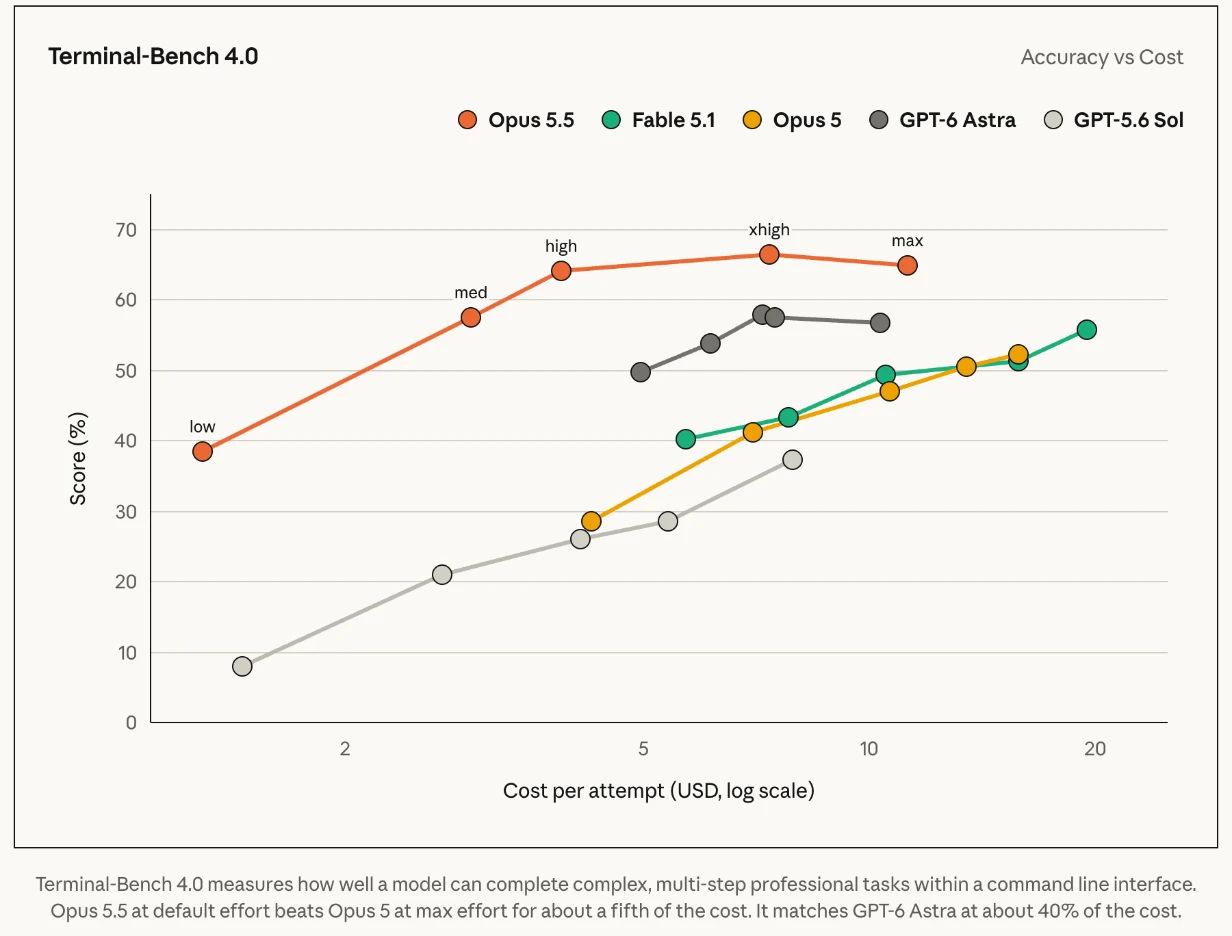 (출처: Introducing Claude Opus 5.5 \ Anthropic)
Terminal-Bench 4.0 그래프에서 Opus 5.5의 선은 다른 모든 모델보다 좌측 상단에 있습니다. 눈금을 살펴보면 Opus 5.5는 medium에서 약 57%(1회당 약 $3), high에서 약 64%($4 미만)를 기록하고 있습니다. Opus 5의 max(약 52%, 약 $15)나 Fable 5.1의 max(55.8%, 약 $20)를 medium 단계에서 이미 몇 분의 일에 불과한 비용으로 앞서고 있습니다. 공식 설명에서도 기본 effort 설정의 Opus 5.5가 Opus 5의 max effort를 약 5분의 1 비용으로 앞서며, GPT-6 Astra와는 약 40% 수준의 비용으로 대등한 성능을 낸다고 밝히고 있습니다.
흥미로운 점은 Opus 5.5의 점수가 xhigh(66.4%)에서 정점을 찍고 max(약 65%)에서는 소폭 하락했다는 사실입니다. "effort는 무조건 높일수록 좋다"고 볼 수만은 없다는 점을 이 그래프를 통해서도 알 수 있습니다.
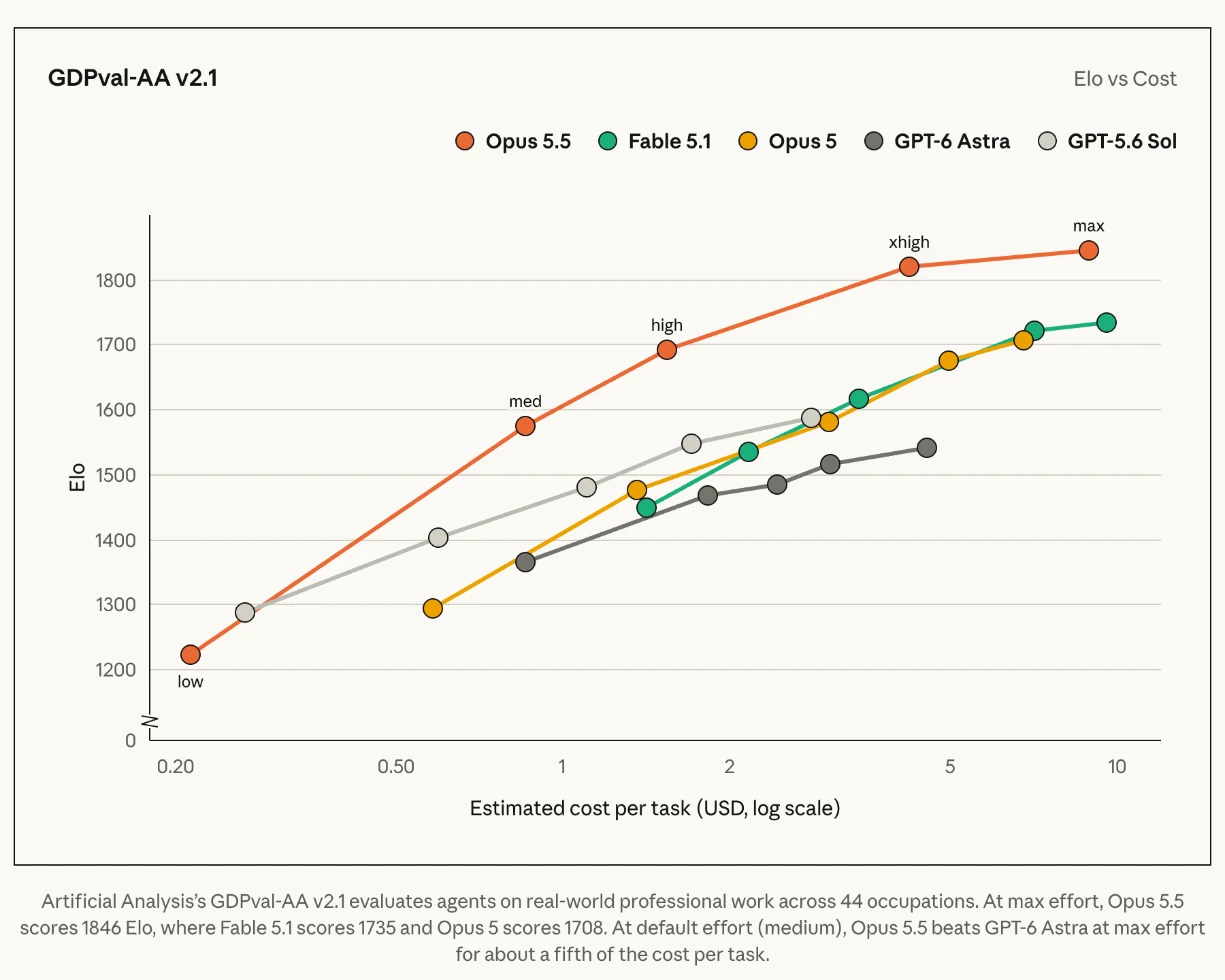 (출처: Introducing Claude Opus 5.5 \ Anthropic)
지식 노동 벤치마크인 GDPval-AA v2.1은 Artificial Analysis가 제공하는 벤치마크로, 44개 직종의 실제 업무를 토대로 에이전트를 평가합니다. 이 역시 Opus 5.5의 선이 전반적으로 좌측 상단에 위치합니다. 공식 권장 기본 effort(medium)에서 약 1575(태스크당 약 $0.85)를 기록하여 GPT-6 Astra의 max(1542, 약 $4.5)를 약 5분의 1 비용으로 앞섰습니다. xhigh(약 1820, $4 이상) 시점에는 이미 Fable 5.1의 max(1735, 약 $9.5)보다 높은 점수를 내면서 비용은 절반 이하였습니다.
그래프의 수치는 눈금을 보고 대략적으로 파악한 값이며, 측정 자체는 Anthropic이 진행한 것입니다. 공식 발표에서는 이 외에도 FrontierCode에서 기본 effort로 GPT-6 Astra를 약 20%의 비용으로 앞서고, CursorBench에서는 GPT-5.6 Sol을 약 3분의 1 비용으로 11포인트 앞선다고 덧붙였습니다.
초기 테스터들의 보고도 이와 일맥상통합니다.
- Deloitte는 가장 낮은 effort에서도 코드 리뷰 시 이미 알려진 버그의 72%를 찾아내며 high effort의 Opus 5(56%)를 앞질렀다고 보고했습니다. 오탐(false positive)도 적었고 출력량도 훨씬 적었습니다
- Factory는 medium effort를 기본값으로 설정해도 좋겠다고 느낀 첫 번째 모델이라며, high effort의 Opus 5와 동등한 결과를 출력 토큰 20~25% 절감 상태에서 냈다고 밝혔습니다
- Optiver는 에이전틱 코딩 태스크에서 Opus 5와 대등한 품질을 약 절반 수준의 턴(turn), 시간, 출력 토큰으로 달성하여 비용이 40~50% 절감되었다고 전했습니다
Claude Code에서는 /model 화면에서 좌우 방향키를 사용해 effort를 조절할 수 있습니다. 평소에는 medium이나 high로 일상 작업을 처리하다가 복잡하고 까다로운 태스크에서만 단계를 올리는 식의 유연한 활용이 한결 수월해졌습니다.
가격은 입력/출력 20%, cache read 60% 인하
요금 체계는 다음과 같습니다.
| 항목(1M 토큰당) | Opus 5.5 | Opus 5 |
|---|---|---|
| 입력 | $4 | $5 |
| 출력 | $20 | $25 |
| cache read | $0.20 | $0.50 |
| cache write | $5 | $6.25 |
입력과 출력은 20%, cache read(이미 처리된 입력을 재사용할 때 발생하는 읽기)는 60% 인하되었습니다. 공식 설명에 따르면 에이전틱 작업이나 코딩에서는 비용의 대다수를 cache read가 차지하므로, Claude Code에서 긴 세션을 운용할수록 가격 인하 효과를 크게 체감할 수 있을 것으로 보입니다.
참고로 Fable 5.1은 입력 $10, 출력 $50, cache read $0.25입니다. 입출력 단가만 놓고 비교하면 Opus 5.5는 Fable 5.1의 40% 수준입니다.
Claude Code 및 Claude Platform에서는 Fast mode도 이용할 수 있습니다. 최대 2.5배 빠른 속도로 동작하며, 요금은 입력 $8, 출력 $40(1M 토큰당)입니다.
구독 플랜의 사용량 한도(usage)도 확대
구독형 플랜을 이용하는 분들에게 유용한 소식도 있습니다. 가격 인하에 맞춰 Pro, Max, Team 및 시트 기반 Enterprise 플랜의 5시간당 사용량 한도(usage limit)가 상향 조정됩니다.
이에 더해 구독 사용자에게는 Rate Limit을 즉시 리셋할 수 있는 횟수가 1회분 부여되며, 사용자가 원하는 타이밍까지 아껴 두었다가 사용할 수 있다고 합니다. 마감 직전 집중 작업이 필요한 순간 등 결정적인 때를 위해 남겨둘 수 있다는 점은 무척 고마운 배려입니다.
코딩: 길고 광범위한 작업에 강력한 면모
공식 발표에서는 Opus 5.5가 특히 강점을 보이는 작업으로 코드베이스 전반에 걸친 마이그레이션이나 감사(audit)와 같이 호흡이 길고 범위가 넓은 업무를 꼽았습니다. 소개된 사례는 다음과 같습니다.
- 한 초기 테스터 기업은 20만 줄 규모의 코드베이스 감사 및 수정을 3시간 이내에 완료했습니다. Opus 5로는 20시간 이상 소요되었으며 토큰도 2.5배 더 소모했던 작업입니다
- Anthropic 사내 테스트에서 웹 서버 부하 분산 소프트웨어인 HAProxy를 C에서 Rust로 재작성하도록 한 결과, Opus 5.5와 Fable 5.1 모두 HAProxy 자체 회귀 테스트를 거의 전부 통과했습니다. Opus 5.5는 9.5시간(Fable 5.1은 12시간) 만에 작업을 끝냈고 비용은 51% 적게 들었습니다
- 웹 앱 전체 페이지의 로딩 속도를 단축하는 테스트에서 Opus 5.5는 40회 중 39회 성공했습니다. Opus 5는 개선 폭이 작았으며 앱의 동작 방식까지 변형시키는 문제가 있었습니다
초기 테스터들의 코멘트 중 Claude Code 사용 환경과 밀접한 내용의 요지만 정리해 소개합니다.
- GitHub의 CPO는 GitHub Copilot CLI 및 VS Code에서의 테스트 결과, Opus 5.5가 지금까지 측정한 모델 중 가장 적은 토큰과 단계(step)만으로 작업을 마친 모델 중 하나였으며, VS Code에서는 Opus 5의 절반도 안 되는 단계로 더 많은 터미널 태스크를 해결했다고 밝혔습니다
- Stripe의 엔지니어는 며칠이 걸리는 40개의 stacked pull request 리베이스 작업에서 단 하나의 Opus 5.5 세션이 십여 개의 서브 세션을 지휘하며 모든 충돌(conflict)을 명확하게 정리해 주었고, 다음 날 오후에는 40개 모두 CI를 통과했다고 소개했습니다
- Clio의 엔지니어는 6개 리포지토리에 걸친 대규모 작업을 밤새 무인으로 맡긴 결과, 18시간 이상 방향을 잃지 않고 작업을 지속해 Opus 5보다 빠르게 마일스톤에 도달했으며 수정 작업도 거의 필요 없었다고 전했습니다
- Column은 서브 에이전트로의 위임 능력이 훨씬 능숙해졌고, 자신의 작업 결과를 스스로 창의적인 방식으로 검증하게 되었다고 평가했습니다
모두 각 기업의 고유한 환경에서 나온 보고이므로 동일 조건의 비교는 아닙니다. 그럼에도 '적은 단계로 신속하게 완료', '장시간 무인 작업에 대한 내구성', '서브 에이전트의 뛰어난 활용력'이라는 공통된 평가가 나온다는 점은 Claude Code로 장시간 태스크를 수행하는 분들에게 충분히 유의미한 참고 자료가 될 것입니다.
보안 측면의 대비책
코딩 에이전트를 기업 시스템 내부에서 장시간 구동하려면 의도한 대로 안전하게 작동하는지 검증할 수 있어야 합니다. 공식 발표는 Opus 5.5를 '가장 안전한 코딩 에이전트'로 규정하며, 실행 전 모든 조작을 확인하는 분류기(classifier), 보안팀이 감사할 수 있는 오픈소스 샌드박스, 머지(merge) 전 취약점을 발견하는 코드 리뷰의 3단계를 제시했습니다.
모델 자체의 방어력도 강화되어, prompt injection(외부 데이터에 악의적 지시를 숨겨 모델 제어권을 탈취하려는 공격)에 대한 내구성은 코딩, 툴 사용, 컴퓨터 조작, 웹 브라우징 등 모든 설정 환경에서 Opus 5와 동등하거나 그 이상이었습니다. AI 보안 기업 Gray Swan의 벤치마크에서는 prompt injection 성공률이 Fable 5.1과 나란히 테스트 대상 중 최저치를 기록했습니다.
지식 노동: 거짓 정보(환각) 없는 철저한 리서치 역량
지식 노동 사례 중 특히 인상 깊었던 부분은 리서치 보고서의 정확성이었습니다. 사내 테스트로 실적 발표 자료를 찾기 어렵게 만든 웹 복사본만을 단서로 제공하고 특정 기업의 분기 실적 보고서를 작성하도록 했습니다. 숫자나 인용구를 단 하나라도 지어내면(할루시네이션) 탈락 처리하는 엄격한 기준으로 자동 채점한 결과, Opus 5.5는 effort 설정을 달리한 18개 중 16개가 합격한 반면, Fable 5.1과 Opus 5는 단 1개도 합격하지 못했다고 합니다.
이 밖에도 다음과 같은 사례들이 소개되었습니다.
- 가상의 HR 소프트웨어 기업 2곳의 합병안을 분석하고 Excel로 재무 모델을 구축한 뒤 경영진 대상 프레젠테이션 자료로 정리하는 태스크에서, Opus 5.5는 63분(Opus 5는 93분) 만에 작업을 마쳤고 비용은 50% 절감되었습니다. 결론은 동일했으나 Opus 5.5가 도출한 모델이 훨씬 정교했고 자료의 가독성도 뛰어났습니다
- 투자사 Walleye Capital은 가장 낮은 effort에서도 평가 태스크를 대부분 해결했으며, 높은 effort에서는 평가 지침서에 포함되어 있던 1분 어긋난 인덱스 오류를 스스로 감지하고 보정했다고 보고했습니다. 이는 이전까지 그 어떤 모델도 알아채지 못했던 오류였습니다
- 데이터 분석 기업 Hex는 배송 지연인지 배송 추적 시스템의 오류인지를 판별하는 태스크에서, Opus 5는 배송 기록만 보고 "추적 시스템은 정상"이라고 답한 반면, Opus 5.5는 배송 자체가 지연되었을 뿐만 아니라 추적 시스템 역시 고장 나 있었다는 사실을 정확히 밝혀냈다고 전했습니다
언뜻 그럴싸한 답변을 찾았더라도 거기서 멈추지 않고 끝까지 파고듭니다. Opus 5 출시 당시 '스스로 검증하는 능력'이 비약적으로 향상되었다고 언급했었는데, 그 방향성이 한층 더 발전한 느낌입니다.
한결 향상된 문장 가독성
Opus 5에 대해 자주 제기되었던 피드백 중 하나가 문장의 가독성이 떨어진다는 점이었습니다. Opus 5.5에서는 이 부분이 대대적으로 개선되었습니다.
공식 발표에 따르면 Opus 5.5의 메시지는 한눈에 파악하기 쉽고 중요한 정보를 두괄식으로 전달하며, 전문 용어나 특이한 표현의 남발이 줄었고 사용자가 지정한 서식 및 문체 규칙도 충실히 따르게 되었다고 합니다. 공식 페이지에는 버그 분석을 요청했을 때의 Opus 5와 Opus 5.5 출력을 나란히 비교해 두었습니다.
- Opus 5는 '무엇을 발견했는가', '버그의 상세 내용' 순으로 조사 과정을 순차적으로 나열하여, 영향의 심각성을 파악하려면 글을 끝까지 읽어야 함
- Opus 5.5는 도입부 헤드라인에서 "추가 감소분은 결제 관련 리팩터링 버그로 인한 것"이라는 결론을 먼저 제시하고, 금액 세부 내역(무료 플랜 변경분 $1.50, 버그 원인분 $9.92)을 앞서 명시한 뒤 구체적인 원인 코드로 진입함
초기 테스터인 Ramp의 엔지니어 역시 장황하고 흐름을 파악하기 힘든 출력이 기존 프론티어 모델에 대한 가장 큰 불만이었으나 Opus 5.5가 이를 말끔히 해결해 주었다고 평했습니다. Box는 Opus 5 대비 토큰 소모량이 3분의 1 수준으로 줄었고 응답의 장황함도 40% 감소했다고 보고했습니다.
공식 측은 향상된 가독성이 실용성뿐만 아니라 안전성 측면에서도 큰 이점이라고 강조합니다. 작업 흐름을 쉽게 추적하고 검증할 수 있기 때문입니다. 긴 세션에서 Claude Code의 보고 내용을 읽는 시간이 줄어든다는 점은 일상 업무에서 가장 체감하기 쉬운 변화가 아닐까 싶습니다.
안전성 및 얼라인먼트
이번 안전성 섹션은 '프론티어의 속도 조절(Pacing the frontier)'이라는 철학에서 출발합니다. 발표 전주에 Dario Amodei CEO가 안전 대책이 모델의 역량을 지속적으로 앞서 나갈 수 있도록 AI의 발전 속도를 조율해야 한다고 역설한 데 따른 것입니다. 현재 운용 중인 모델을 위한 안전 대책을 고도화하는 동시에, AI 연구 자체를 자동화할 미래 모델에 대비해 한층 엄격한 안전 기준 마련과 공공 정책의 개입을 유도하는 2단계 타임라인으로 접근하겠다는 설명입니다.
Opus 5.5 자체의 얼라인먼트 평가 핵심 내용은 다음과 같습니다.
- 자동 행동 감사 - 약 2,000개의 시나리오를 통해 행동 양식을 평가하는 핵심 테스트에서 거의 모든 지표가 최근 Claude 모델보다 우수하게 나타남. 솔직함(honesty)을 측정하는 다수의 지표에서도 사내 최고 수준 기록
- 경계 이탈 경향 - 주어진 격리 경계를 벗어나려는 성향을 측정하는 신규 평가에서 경계 우회를 시도한 빈도가 Opus 5 및 Mythos 5.1 대비 약 85% 적었으며, 시도된 사례 역시 모두 심각도가 낮고 모델이 자발적으로 보고한 형태였음
- 최근 인시던트 관련 행동 개선 - 편향된 추론, 샌드박스 탈출 시도, "이곳은 시뮬레이션 환경"이라고 자체 판단한 후 저지르는 유해한 행동 등 최근 사이버 보안 인시던트로 이어졌던 위험 행동들이 대폭 개선됨
반면 한계점도 솔직하게 공개되었습니다. Opus 5.5는 자신이 현재 평가를 받고 있다고 의심하는 경향이 잦아, 실제 환경에서의 행동 양식을 사전 평가만으로 온전히 예측하기가 점점 어려워지고 있다고 합니다. 배포 전 모든 오작동 사례를 완벽히 포착해 내는 평가 체계를 구축하는 것은 아직 해결되지 않은 과제라고 덧붙였습니다. Claude Code에 광범위한 권한을 부여해 자동으로 구동할 때는 성능 개선을 신뢰하되, 모델에 일임할 작업의 범위는 사용자가 명확히 선을 그어두는 태도가 여전히 중요해 보입니다.
Fable 5.1과 동등한 수준의 safeguards 도입
Opus 5.5는 사이버 보안, 생물학, 증류(distillation) 방지 측면에서 Fable 5.1과 동일한 클래스의 safeguards(안전장치)를 탑재하고 출시된 최초의 Opus 모델입니다. 공식 발표에 따르면 이러한 safeguards가 개입할 경우 시스템은 사용자 모르게 투명하게 다른 모델로 전환됩니다.
- 사이버 보안 - 사이버 역량이 극도로 뛰어나 Fable 5.1과 동일한 수준의 safeguards가 적용됩니다. 일상적인 개발 과정에서 코드 버그를 찾아 수정하는 것은 가능하지만, 대부분의 전문 사이버 보안 태스크는 Opus 4.8로 우회 처리됩니다. 방어 측면의 전문가를 위해서는 조만간 Cyber Verification Program에 Opus 5.5가 추가되어 Mythos 모델 접근권을 포함한 3단계 프레임워크로 운영될 예정입니다
- 생물학 - 많은 영역에서 Opus 5를 능가하고 Mythos 5.1과 대등하거나 그 이상으로 평가되어, Fable 5.1과 동일한 생물학 safeguards가 적용됩니다. 연구개발 목적으로 활용하려는 조직은 Life Sciences Verification Program을 통해 신청할 수 있습니다
- 증류 방지 - Fable 5.1에서 처음 도입된 preserved thinking이 Opus 5.5에도 적용됩니다. API 이용자가 Claude의 이전 컨텍스트를 임의로 편집하여 추론 과정(thinking process)을 무단 추출하려는 시도를 차단하는 장치로, 2026년 8월 31일 이후 생성된 API 계정에 일괄 적용됩니다. 대화 히스토리를 자체적으로 재구성하는 연동 시스템을 개발 중인 분들은 고객센터 안내 문서를 미리 확인해 두시는 것이 좋습니다
Claude Code 사용자 입장에서 주목할 점은 사이버 보안 성격의 작업을 수행할 때 Opus 4.8로 우회되는 상황이 발생할 수 있다는 점입니다. Fable 5.1과 동일한 수준의 safeguards가 Opus 라인업에 적용된 것은 이번이 처음이므로, 기존에 Opus 5로 보안 관련 조사를 진행하셨던 분들은 동작 방식이 달라질 수 있음을 염두에 두셔야 합니다.
데이터 보존 정책 및 제공 현황
기존 Opus 모델과 마찬가지로 Opus 5.5 역시 zero data retention(데이터를 일절 보존하지 않는 계약) 조건으로 이용할 수 있습니다.
그 외의 변경 사항은 다음 2가지입니다.
- Fable 5.1과 마찬가지로 EU AI Act 규제를 준수하기 위해 출력 결과물에 워터마크(watermark)가 포함됩니다
- thinking 기능을 완전히 비활성화한 상태로는 사용할 수 없게 되었습니다
발표 당일부터 모든 플랫폼을 통해 서비스가 시작되었으며 Amazon Web Services, Google Cloud, Microsoft Azure에서도 즉시 이용 가능합니다. API 모델 ID는 claude-opus-5-5입니다.
Claude Code에서 직접 사용해 보기
제가 사용하는 환경에서 Claude Code의 /model을 열어보니 Default(추천) 설정이 이미 Opus 5.5로 변경되어 있었습니다.
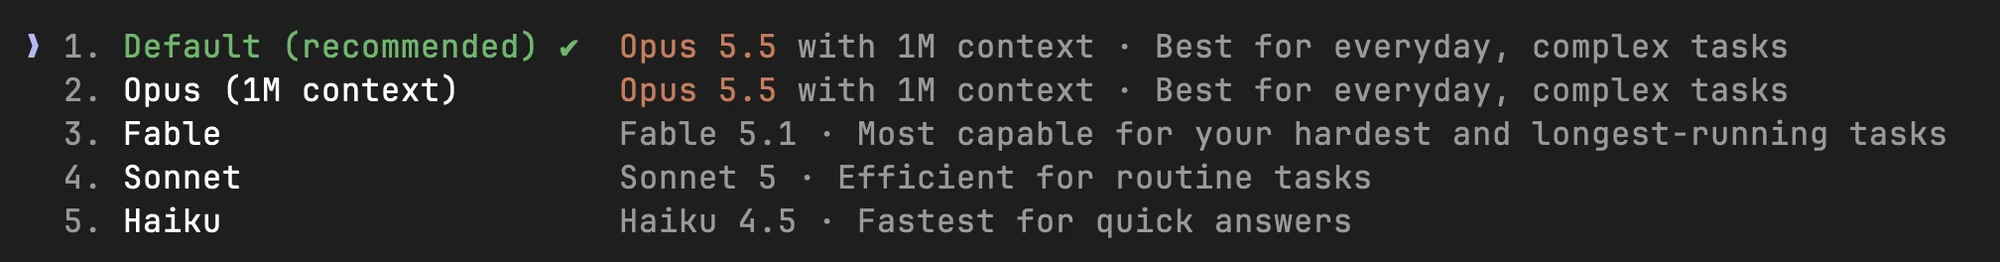
목록의 첫 번째 Default와 두 번째 Opus(1M context)가 모두 'Opus 5.5 with 1M context'로 지정되어 있으며, 설명에는 '일상적인 태스크부터 복잡한 태스크까지 범용'이라고 기재되어 있습니다. 세 번째 Fable은 Fable 5.1이며 그 아래로 Sonnet 5와 Haiku 4.5가 자리 잡고 있습니다. Opus 5는 목록에 나타나지 않으므로 이전 모델을 사용하려면 실행 시 --model 옵션으로 모델 ID를 직접 지정해야 합니다. effort 역시 --effort 옵션으로 실행 시 설정할 수 있습니다.
claude --model claude-opus-5
claude --effort medium
아직 환경에서 모델이 자동 전환되지 않았다면 업데이트를 진행한 후 재실행해 보시기 바랍니다.
claude update
표시 여부나 기본 동작 방식은 플랜, 제공자(provider), 관리자 설정에 따라 상이할 수 있습니다. 아직 Homebrew나 npm을 통해 Claude Code를 사용하고 계신 분들은 이번 기회에 네이티브 설치로 전환하시면 자동 업데이트가 원활하게 작동하여 신규 모델 적용을 훨씬 수월하게 따라갈 수 있습니다. 자세한 절차는 Claude Code를 Homebrew에서 네이티브 설치로 전환하고 쾌적해진 후기에 정리해 두었습니다.
Opus 5와 Opus 5.5 비교
주요 차이점을 표로 정리했습니다.
| 항목 | Opus 5 | Opus 5.5 |
|---|---|---|
| 요금(입력/출력・1M 토큰당) | $5 / $25 | $4 / $20 |
| cache read(1M 토큰당) | $0.50 | $0.20 |
| 일반적인 워크로드 비용 | 기준 | 약 40% 절감(기본 설정 기준) |
| 출력 생성 속도 | 기준 | 30% 이상 빠름 |
| Terminal-Bench 4.0 | 52.3% | 66.4% |
| CursorBench 4.0 | 46.6% | 57.8% |
| GDPval-AA v2.1 | 1708 | 1846 |
| 사이버/생물학/증류 방지 safeguards | Fable 5.1과 다른 수준 | Fable 5.1과 동등(개입 시 Opus 4.8 등으로 전환) |
| API 모델 ID | claude-opus-5 | claude-opus-5-5 |
벤치마크 수치는 이번 공식 발표의 비교표를 기준으로 작성되었습니다.
실사용자 관점에서의 실질적 이점
지금까지 살펴본 내용을 실무에 어떻게 적용할 수 있을지 사용자 관점에서 다시 정리해 보겠습니다.
1. Fable 5.1에 버금가는 성능을 Opus 가격대로 활용
대다수 작업에서 Fable 5.1과 대등한 수준을 보여주며, Terminal-Bench 4.0에서는 Fable 5.1을 앞서면서도 입출력 단가는 Fable 5.1의 40%에 불과합니다. "어려운 작업은 Fable, 평소에는 Opus"로 나누던 작업 패턴을 상당 부분 Opus 5.5 하나로 통일할 수 있게 되었습니다.
2. 동일한 작업을 더 저렴하고 빠르게 완수
단가 인하와 토큰 효율성 개선이 맞물려 일반적인 워크로드에서 약 40%의 비용 절감이 예상됩니다. 출력 속도 역시 30% 이상 빨라졌으며, 구독 플랜의 사용량 한도(usage limit)도 늘어납니다.
3. 한눈에 들어오는 가독성 높은 보고서
사소해 보일 수 있지만 Claude Code를 매일 사용하는 분들에게는 무척 와닿는 변화입니다. 결론부터 먼저 제시해 주는 것만으로도 긴 세션의 보고 내용을 검토하는 피로도가 확연히 줄어듭니다.
4. 보안 관련 태스크 수행 시의 동작 변화 인지 필요
이 부분은 주의가 필요합니다. Opus 5.5에는 Fable 5.1과 동등한 수준의 safeguards가 내장되어 있어 보안 관련 작업 중 일부는 Opus 4.8로 넘어가 처리됩니다. Opus 5를 사용하던 감각 그대로 접근하면 예상과 다른 결과가 나올 수 있습니다.
맺음말
Claude Opus 5.5의 핵심 포인트를 정리하면 다음과 같습니다.
- Claude 5.5 패밀리의 첫 모델. 대다수 작업에서 Fable 5.1과 동등한 수준의 성능. Sonnet 5.5와 Haiku 5.5도 수주일 내 출시 예정
- Terminal-Bench 4.0은 66.4%(Fable 5.1은 55.8%, Opus 5는 52.3%), CursorBench 4.0은 57.8%, GDPval-AA v2.1은 1846
- AutomationBench 및 Terminal-Bench-Science 0.1에서는 GPT-6 Astra가 우세
- 기본 effort 설정으로도 Opus 5의 max effort를 약 5분의 1 비용으로 앞섬(Terminal-Bench 4.0)
- 요금은 입력 $4, 출력 $20, cache read $0.20(1M 토큰당). 일반적인 워크로드에서 Opus 5 대비 약 40% 저렴하며 출력 속도는 30% 이상 빠름
- Fast mode는 최대 2.5배 빠르며 입력 $8, 출력 $40
- Pro, Max, Team, 시트 기반 Enterprise 플랜의 5시간당 usage limit 상향 및 Rate Limit 리셋 1회분 제공
- 문장 가독성이 대폭 개선되어 중요한 결론을 두괄식으로 작성
- 자체 자동 행동 감사에서 역대 최고 점수 기록. 격리 경계 우회 시도 빈도는 Opus 5 대비 약 85% 감소
- 사이버, 생물학, 증류 방지 측면에서 Fable 5.1과 동등한 수준의 safeguards 도입. 보안 태스크 대다수는 Opus 4.8로 우회 전환
- zero data retention 적용. thinking 비활성화는 불가
- API 모델 ID는
claude-opus-5-5. AWS, Google Cloud, Azure에서도 출시 당일부터 즉시 사용 가능
Fable 5.1 관련 글에서 "Opus 5에 잠시 따라잡혔던 Fable이 다시 한발 앞서 나갔다"고 쓴 지 불과 3주 만입니다. 이번에는 Opus 측에서 Fable 5.1에 근접한 성능을 훨씬 합리적인 가격대로 선보였습니다. 상위 라인업에서 먼저 개척한 기술력을 수주일 만에 접근성 높은 가격대의 모델로 신속하게 낙수시키는 개발 흐름이 확실히 자리 잡은 모양새입니다.
저 역시 당분간 Claude Code의 기본 모델을 Opus 5.5로 고정해 두고, effort 설정을 medium과 high 사이에서 유연하게 조절해가며 써볼 생각입니다. 사용하면서 새롭게 알게 된 점이 있다면 다시 글로 정리해 공유하겠습니다.