Claude Sonnet 5.5 등장. Sonnet 5와 동일한 요금 그대로, 30% 이상 더 빠르고 Opus 5.5에 육박
목차
안녕하세요. 2026년 9월 28일(미국 시간), Anthropic에서 'Claude Sonnet 5.5'를 발표했습니다. 지난주 Opus 5.5에 이은 Claude 5.5 패밀리의 두 번째 모델입니다.
공식 발표의 서두에서는 Sonnet 5의 명확한 업그레이드 버전이며, 30% 이상 빠르고 대부분의 작업에서 최대 30% 저렴해진다고 소개하고 있습니다. 요금표 자체는 Sonnet 5와 달라지지 않았습니다. 동일한 단가를 유지하면서 같은 작업을 더 적은 토큰으로 끝내기 때문에 결과적으로 저렴해진다는 설명입니다.
포지셔닝도 명확합니다. 신중한 판단이 필요한 복잡한 작업은 Opus 5.5, 범위가 명확한 일상적인 태스크, 버그 수정, 자료·슬라이드·스프레드시트 작성은 Sonnet 5.5라는 역할 분담입니다. 공식 발표에서는 Sonnet 5.5를 Opus 5.5를 보완하는 '더 빠르고, 더 저렴한' 모델로 자리매김하고 있습니다.
이 글에서는 공식 발표와 Claude 공식 계정의 X 게시물을 바탕으로 Sonnet 5.5에서 무엇이 바뀌었는지, Opus 5.5와 어떻게 구분해서 사용하는 것이 좋을지 정리해 보겠습니다.
이번 발표의 핵심 포인트
공식 발표에서는 Sonnet 5 대비 개선점을 5가지로 나누어 소개하고 있습니다.
- 성능 - Terminal-Bench 4.0은 Sonnet 5의 10.3%에서 70.6%로 상승했습니다. GDPval-AA에서는 Opus 5.5와 거의 대등해졌습니다. 스크린샷에만 의존해 『포켓몬스터 레드』를 클리어한 최초의 Sonnet 모델이기도 합니다.
- 협업 - Opus 5.5와 마찬가지로 이전 세대보다 문장이 이해하기 쉬워졌습니다. 빠른 속도를 살려 지나치게 복잡하지 않은 태스크를 빠르게 반복하는 사용 방식에 적합합니다.
- 비용 - 요금은 Sonnet 5와 동일합니다. 동일한 작업에 사용하는 토큰이 크게 줄어 태스크당 최대 30% 저렴해집니다.
- 속도 - 출력 생성은 Sonnet 5보다 30% 이상 빠르며, Sonnet 모델 중 역대 최고 속도를 자랑합니다.
- 얼라인먼트 및 안전성 - 자동 행동 감사에서 대부분의 지표가 Sonnet 5와 동등 이상입니다. Sonnet 최초로 상위 모델과 유사한 사이버 보안 safeguards를 갖추고 출시됩니다.
참고로 패밀리의 마지막 하나인 대량 처리 및 비용 중심 용도의 Claude Haiku 5.5도 몇 주 내에 추가될 예정입니다.
벤치마크에서는 Sonnet 5 대비 크게 성장, Opus 5.5에 육박
공식 사이트에 게재된 비교표는 다음과 같습니다.
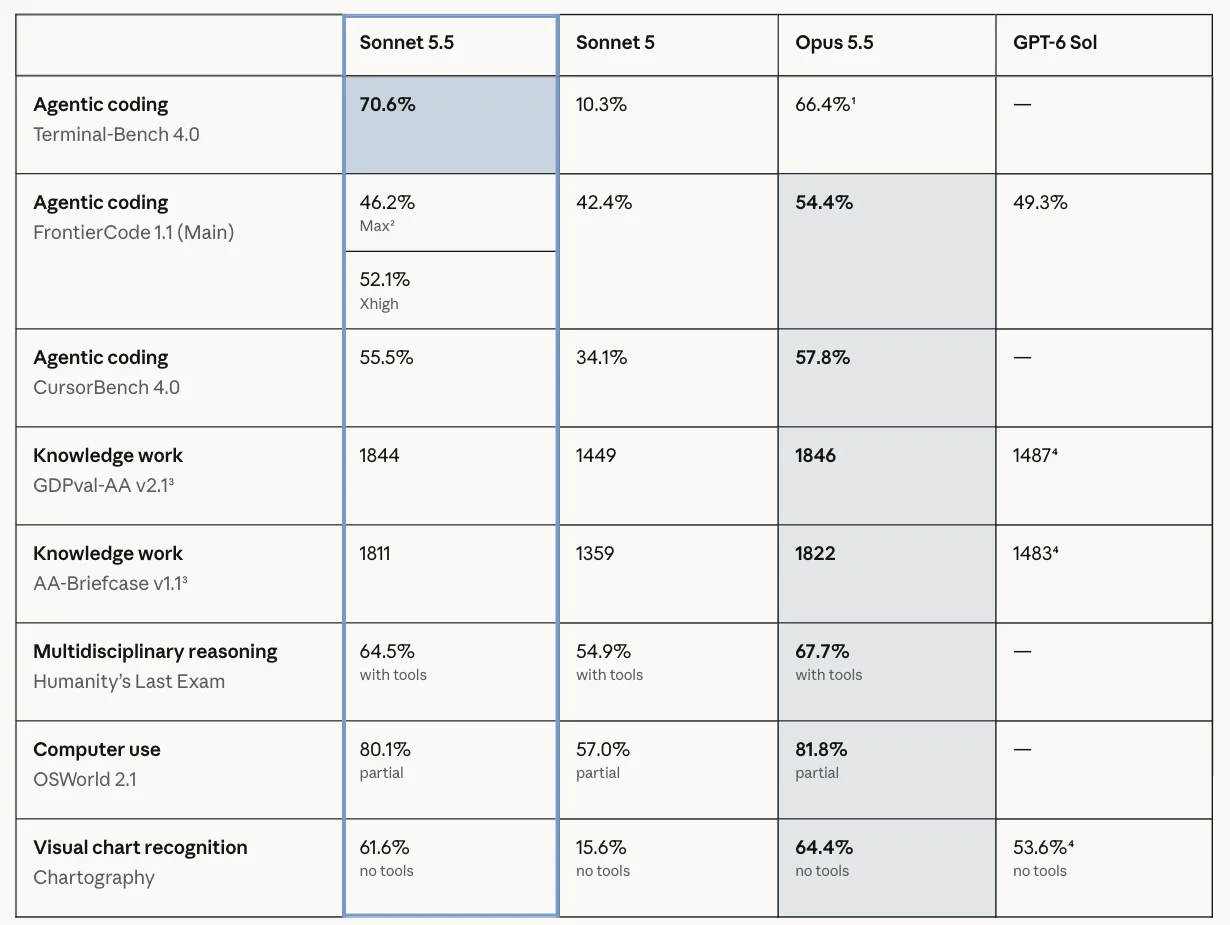 (출처: Introducing Claude Sonnet 5.5 \ Anthropic)
주요 항목을 발췌하면 다음과 같습니다.
| 벤치마크 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (터미널 환경에서의 에이전트 코딩) | 70.6% | 10.3% | 66.4% | 미게재 |
| FrontierCode 1.1 Main (에이전트 코딩) | 46.2%(Max) / 52.1%(Xhigh) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 (에이전트 코딩) | 55.5% | 34.1% | 57.8% | 미게재 |
| GDPval-AA v2.1 (지식 노동, Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (장시간 지식 노동, Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (분야 횡단 추론, 도구 포함) | 64.5% | 54.9% | 67.7% | 미게재 |
| OSWorld 2.1 (컴퓨터 제어, partial) | 80.1% | 57.0% | 81.8% | 미게재 |
| Chartography (그래프 판독, 도구 없음) | 61.6% | 15.6% | 64.4% | 53.6% |
모든 항목이 Sonnet 5에서 크게 상승했지만, 특히 눈에 띄는 것은 Terminal-Bench 4.0입니다. Sonnet 5의 10.3%에서 70.6%로 자릿수가 바뀔 정도의 상승폭을 보였으며, 표상으로는 Opus 5.5의 66.4%도 넘어섰습니다. 그래프 판독 능력을 측정하는 Chartography 역시 15.6%에서 61.6%로 올라 이미지 이해 능력의 향상도 두드러집니다.
지식 노동 지표인 GDPval-AA v2.1은 1844로, Opus 5.5의 1846과 불과 2점 차이입니다. GDPval-AA는 44개 직종과 9개 주요 산업의 실무를 기반으로 한 벤치마크로, Sonnet 5 대비 약 400점 상승했습니다.
반면, Terminal-Bench 4.0 이외의 항목에서는 모두 Opus 5.5가 앞서고 있습니다. 공식 발표에서도 벤치마크는 모델 능력의 일면만을 포착할 뿐이며, 지속적인 판단이 필요한 복잡하고 정답이 정해져 있지 않은 작업에서는 Opus 5.5가 확실히 강력하다고 명시하고 있습니다. 표의 수치는 Anthropic이 공개한 것으로 제3자의 독립적인 검증 결과는 아니라는 점도 염두에 둘 필요가 있습니다.
수치를 볼 때 주의할 점
각주에는 수치 해석과 관련된 몇 가지 주의사항이 적혀 있습니다.
- Terminal-Bench 4.0의 Opus 5.5 결과는 최고 점수가 나온 Xhigh effort 기준입니다.
- FrontierCode는 사람의 손을 거치지 않고 그대로 머지할 수 있는 변경 사항인지를 평가하며, 태스크 범위를 벗어난 변경은 품질이 높아도 감점됩니다. Sonnet 5.5는 Max effort가 Xhigh보다 점수가 낮았는데, 이는 Max에서 Claude Code의 code-review 스킬(리뷰를 다수의 서브 에이전트로 나누어 수행)을 실행하는 빈도가 늘어나 타임아웃이나 범위 밖의 추가 수정으로 이어졌기 때문이라고 설명합니다.
- GDPval-AA와 AA-Briefcase는 Artificial Analysis가 출시 전 Sonnet 5.5로 진행한 것으로, structured outputs를 사용하는 요청의 응답 품질이 저하되는 버그가 있었습니다(수정 완료). 영향이 있었더라도 미미하며, 점수가 다소 낮게 책정되는 방향이었을 것으로 보고 있습니다.
FrontierCode 관련 내용은 Claude Code에서 effort를 높일 때 참고가 됩니다. effort를 높일수록 모델이 더 꼼꼼하게 작업하지만, 요청한 범위 밖까지 손을 댈 수도 있다는 뜻입니다. Opus 5.5 기사에서도 Terminal-Bench 4.0 점수가 xhigh에서 정점을 찍고 max에서 소폭 하락한 사례를 소개했는데, 이번 각주를 통해서도 'effort를 무조건 높인다고 좋은 것은 아니다'라는 점을 확인할 수 있습니다.
effort를 낮춰도 Sonnet 5 최고 점수를 능가
이번 발표에서 실무적으로 가장 큰 체감이 될 만한 부분이 바로 여기입니다. 공식 발표에 따르면 일부 벤치마크에서는 Low나 Medium 설정의 Sonnet 5.5가 Sonnet 5의 최고 점수를 태스크당 약 10분의 1 비용으로 넘어섰습니다.
effort는 모델이 답변하기 전에 얼마나 깊이 고민할지를 지정하는 설정으로, Low / Medium / High / Xhigh / Max의 5단계가 있습니다. 높일수록 깊게 생각하는 대신 토큰과 시간이 더 소모되고, 낮출수록 빠르고 저렴해집니다. 공식 그래프는 가로축에 태스크당 비용(로그 스케일), 세로축에 점수를 두고 effort별 지점을 선으로 연결한 것입니다. 좌상단에 위치할수록 '저렴하면서 높은 점수'를 의미합니다.
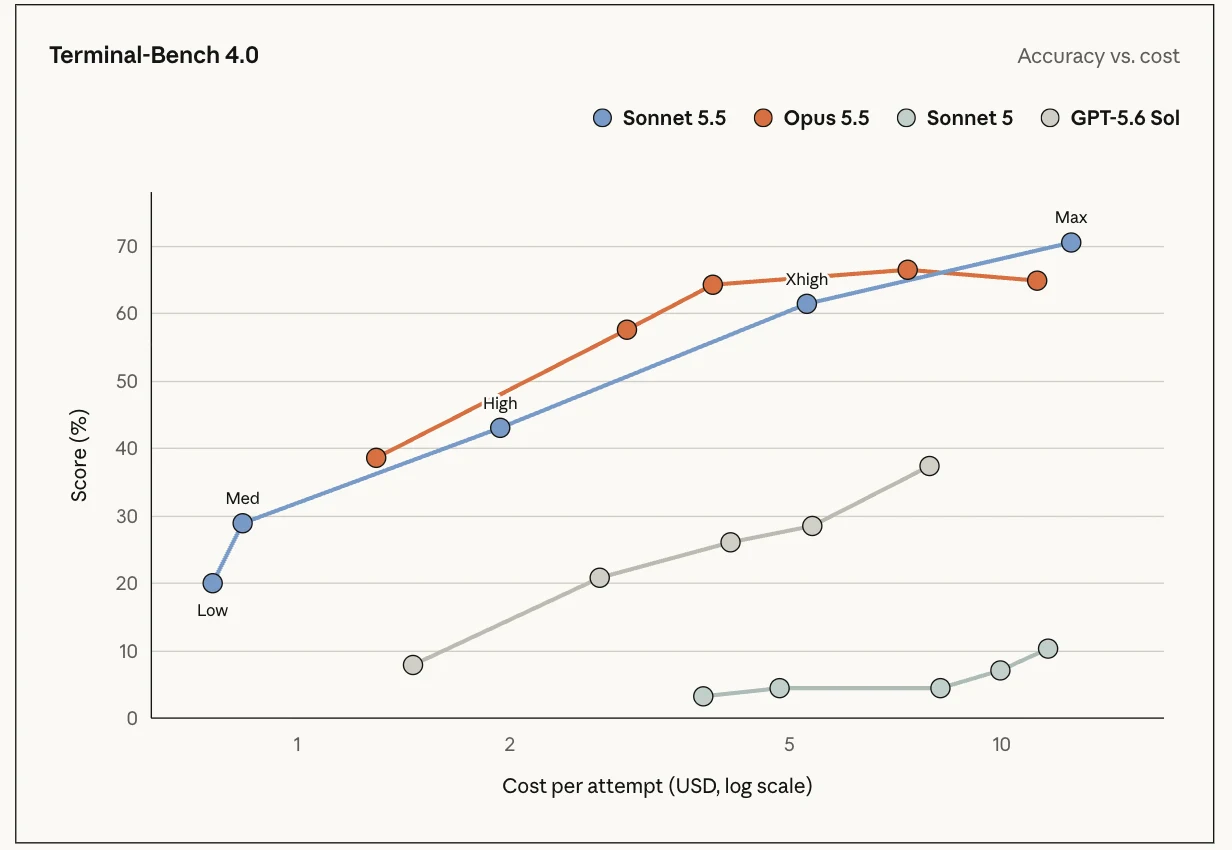 (출처: Introducing Claude Sonnet 5.5 \ Anthropic)
Terminal-Bench 4.0 그래프를 보면 Sonnet 5의 선은 가장 높은 effort에서도 10% 안팎(1회당 약 $12)에 머물러 있습니다. 이에 반해 Sonnet 5.5는 Claude 앱의 기본값인 Medium에서 약 29%(약 $0.8)를 기록했습니다. 공식 설명대로 Sonnet 5의 최고 점수를 10분의 1도 안 되는 비용으로 크게 웃돌고 있습니다.
한편 Opus 5.5와의 관계는 effort에 따라 달라집니다. High 부근까지는 Opus 5.5의 선이 더 위에 있으며, Sonnet 5.5가 70.6%를 기록한 것은 Max일 때(약 $13)입니다. Opus 5.5는 Xhigh(약 $7.5)에서 66.4%였으므로, Terminal-Bench 4.0에서 Opus 5.5를 넘어섰다고는 하나 그만큼의 비용은 추가로 소모된 셈입니다.
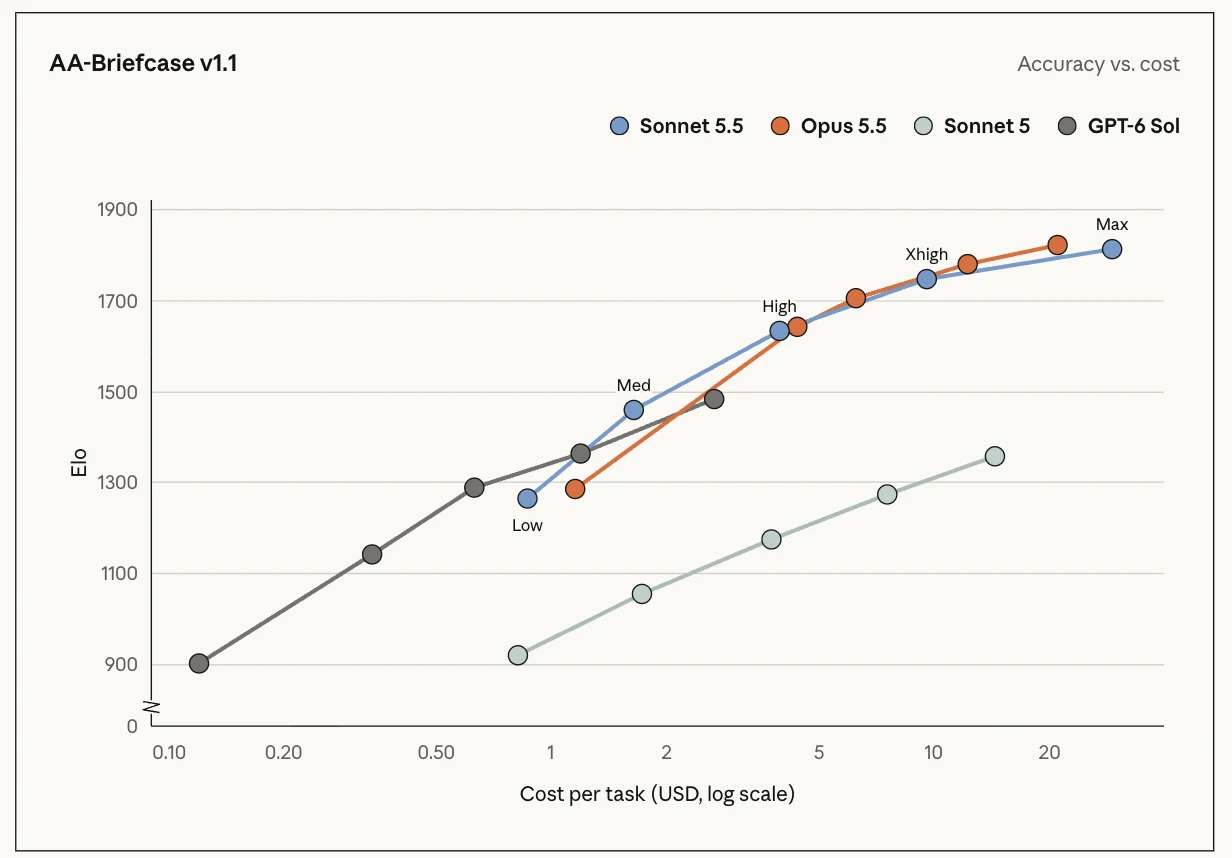 (출처: Introducing Claude Sonnet 5.5 \ Anthropic)
AA-Briefcase v1.1은 Artificial Analysis가 새롭게 마련한 장시간 지식 노동 벤치마크입니다. Sonnet 5.5는 Medium에서 약 1460(약 $1.6)을 기록하며 Sonnet 5의 최고 점수(1359, 약 $14)를 약 9분의 1 비용으로 앞질렀습니다. High 이상 구간에서는 Sonnet 5.5와 Opus 5.5의 선이 거의 겹쳐 있는 점이 인상적입니다.
이 그래프의 형태가 모델 선택의 직관적인 가이드라인이 됩니다. 공식적으로도 Sonnet 5.5가 Opus 5.5를 가장 잘 보완하는 구간은 낮은 effort로 동작시킬 때이며, 높은 effort에서는 비슷한 비용으로 동등한 결과를 낼 수도 있다고 설명합니다. 즉, 저렴하고 빠르게 반복해야 하는 작업은 Sonnet 5.5의 Low나 Medium으로, 진중하게 고민해야 하는 작업은 Opus 5.5로 나누는 방식이 자연스러워 보입니다.
그래프의 수치는 눈금을 보고 대략적으로 파악한 값이며, 측정 자체는 Anthropic에 의해 이루어졌습니다. 공식 발표에서는 이 밖에도 FrontierCode에서 Claude Platform 기본값인 High 설정의 Sonnet 5.5가 GPT-6 Sol의 최고 점수와 약 5분의 1 비용으로 대등한 수준을 기록했다고 덧붙였습니다.
기본 effort는 Claude Code와 앱에서 Medium
공식 안내에 따르면 기본 effort는 Claude Code와 Claude 앱에서는 Medium, Claude Platform(API)에서는 High입니다. 낮은 설정은 빠르고 토큰 소모가 적어 정형화된 작업에 적합하며, 높은 설정은 더 오래 생각하고 작업 내용을 꼼꼼히 점검합니다.
코딩에서는 코드베이스 이해 속도가 탁월
공식 발표에서 특히 성장이 두드러진 분야로 꼽은 것은 코딩입니다. FrontierCode에서는 동일한 High effort 기준으로 비교했을 때 Sonnet 5보다 10포인트 높았으며, 태스크당 비용은 약 15분의 1 수준이었습니다. 실제 Cursor 세션에서 추출한 태스크로 평가하는 CursorBench에서도 최고 점수 기준 Opus 5.5와의 격차가 약 2포인트에 불과했습니다.
초기 테스터들의 평가에서 공통적으로 언급되는 부분은 코드베이스 파악 속도와 뛰어난 효율성입니다. 직접 비교해 본 결과, Sonnet 5보다 도구 호출(Tool Call)을 한데 모아 실행하는 경향이 있어 단계 수와 비용이 줄었다고 합니다. 소개된 피드백 중 몇 가지를 요약해 소개합니다.
- Epic Games는 상위 모델에 기대하는 수준의 품질 기준을 충족했다고 평가했습니다. 게임플레이 시스템 설계에서 수만 줄의 코드를 다루며 몇 시간씩 걸리는 태스크도 무리 없이 처리했다고 합니다.
- CodeRabbit은 Sonnet 5에서 아쉬웠던 웹 검색에 과도하게 의존하는 버릇과 많은 토큰 소모량이 모두 해소되었다고 밝혔습니다. 단순한 작업부터 중간 난이도의 리뷰를 우선 Sonnet 5.5로 이전할 예정이라고 합니다.
- Base44는 118개의 실제 앱 구축 과정에서 Opus 5와 동등한 품질의 앱을 제작했다고 보고했습니다. 앱 1개 구축당 반복 횟수는 평균 3.6회로 Opus 5의 7.7회 대비 절반 이하였습니다.
- Lovable은 사내 코딩 평가에서 태스크를 완료하기까지의 도구 호출이 3분의 1 감소했고 셸 실행 횟수는 약 절반으로 줄었다고 전했습니다.
또 한 가지, 게임을 제작하는 크리에이터 Kevin Ngo 씨의 코멘트는 Opus 5.5와의 역할 분담을 잘 보여줍니다.
When Claude Opus 5.5 sets the architecture and general framework for a game, I would feel confident in letting Sonnet 5.5 implement it.
Opus 5.5가 아키텍처와 전반적인 프레임워크를 잡아주면 구현은 안심하고 Sonnet 5.5에 맡길 수 있다는 의미입니다. Claude Code를 활용한다면 기획과 설계는 Opus 5.5에, 구체적인 구현이나 자잘한 수정은 Sonnet 5.5 서브 에이전트에 넘기는 조합을 떠올리기 쉬울 것 같습니다.
지식 노동에서는 디자인 감각이 높은 평가를 받음
지식 노동 부문에서는 컴퓨터 제어 및 그래프 판독에서 Opus 5.5에 근접했고, 장시간 지식 노동에서는 Sonnet 5와 GPT-6 Sol을 확실하게 앞질렀습니다.
수치로 나타나기 어려운 변화로 공식 발표에서는 디자인 감각을 꼽았습니다. 사용자 인터페이스를 세련되게 다듬고, 슬라이드 템플릿에 맞춰 손볼 곳이 거의 없는 자료를 제작할 수 있다고 합니다. 사내 테스트에서는 모 상장사의 분기 실적 자료와 컨퍼런스 콜 녹취록, 슬라이드 템플릿을 제공하고 10장의 실적 리뷰를 작성하게 했습니다. 전문 분석가 2명이 첫 드래프트를 수정 없이 그대로 보낼 수 있는 수준이라고 판단했다고 합니다.
X 게시물에서도 "바람이 모래언덕을 형성하는 모습을 하나의 HTML 파일로 구현하라"는 프롬프트에 Sonnet 5와 Sonnet 5.5가 코드를 작성하는 모습을 비교한 영상이 소개되었습니다. 공식 페이지에는 이외에도 400마리의 찌르레기 떼 비행이나 24개의 작은 시계로 구성된 시계를 구현한 비교 사례도 수록되어 있습니다.
초기 테스터들의 보고서 중에서도 몇 가지를 공유합니다.
- Slack은 프롬프트를 전혀 수정하지 않고도 오프라인 Slackbot 평가의 거의 모든 항목에서 Sonnet 5를 앞섰으며, 단계 수는 줄고 출력 토큰은 약 14% 감소했다고 보고했습니다.
- Box는 원본 문서를 대조해 데이터를 재확인함으로써 Sonnet 5가 놓친 오류를 잡아내기 시작했다고 평가했습니다. 이전 모델보다 정확하고 2.4배 빠르며 전체 토큰은 12% 적었다고 합니다.
- 투자사인 Balyasny Asset Management는 2,441건의 금융 태스크에서 Sonnet 5를 능가했으며, 답변 1건당 토큰 소모량이 Sonnet 5의 약 49.7만 개 대비 약 12.1만 개에 불과했다고 밝혔습니다.
토큰 사용량의 차이는 각 사의 보고서 중에서도 특히 눈에 띄는 부분입니다. 요금표가 같더라도 실제 청구 금액에서는 상당한 차이가 날 것으로 보입니다.
요금은 Sonnet 5와 동일, 입출력 비용은 Opus 5.5의 절반
요금 정책은 다음과 같습니다.
| 항목 (1M 토큰당) | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 입력 | $2 | $4 |
| 출력 | $10 | $20 |
| cache read | $0.20 | $0.20 |
| cache write | $2.50 | $5 |
입력과 출력 비용은 Opus 5.5의 정확히 절반입니다. cache read(처리된 입력을 재사용할 때의 읽기 비용)는 Opus 5.5의 인하로 동일하게 $0.20로 맞춰졌습니다.
Sonnet 5와 동일한 단가이면서 태스크당 소모되는 토큰이 줄어들기 때문에, 공식 테스트 기준 태스크당 최대 30% 저렴해진다고 합니다. 출력 생성 속도 역시 30% 이상 빨라졌으며 공식 페이지의 비교 영상에서도 그 효율의 차이를 쉽게 체감할 수 있습니다.
안전성 및 얼라인먼트
안전성 챕터는 "Sonnet 5.5는 자사 모델의 최첨단(frontier) 역량을 확장하는 모델은 아니다"라는 전제로 시작됩니다. 따라서 얼라인먼트 평가는 역량 수준과 무관하게 적용되는 위험 요소에 초점을 맞춰 진행되었습니다. 사용자의 이익에 반하는 행동, 사용자 기만, 심각한 오남용 협조 등이 이에 해당합니다.
평가 핵심 요약은 다음과 같습니다.
- 자동 행동 감사 - 약 1,850개 시나리오에서 행동 양식을 평가하는 감사 결과, 얼라인먼트, 악용 저항성, 솔직함 등의 대부분 지표에서 Sonnet 5와 동등 이상.
- 격리(Containment) 평가 - 샌드박스 탈출을 시도하는 빈도의 저조함은 테스트 대상 중 가장 우수했던 Opus 5.5에 근접했으며, 컨테이너의 한계를 시험하려는 경향은 자사 모델 중 가장 낮음.
- 종합 결과 - 감사 전체적으로는 Opus 5.5가 근소하게 우수했으나, 사용자의 의도와 대립하는 목표를 추구한다는 증거는 발견되지 않음.
다만 공식 발표에서는 어떠한 평가로도 모든 결함을 완벽히 걸러낼 수는 없으며, Sonnet 5.5에도 아직 발견되지 않은 경향이 존재할 수 있다고 덧붙였습니다. 그렇기 때문에 다음과 같은 safeguards를 결합해 적용하고 있다는 설명입니다.
사이버 보안 safeguards가 Opus 5.5 수준으로 강화됨
Sonnet 5.5에는 다음 3가지 분야의 safeguards(안전장치)가 적용되었습니다. 물론 Sonnet에 기존에 safeguards가 없었던 것은 아닙니다. 지난 6월 Sonnet 5 발표 당시 Sonnet 5는 Opus 4.7·4.8과 동일한 사이버 safeguards를 기본 활성화한 상태로 출시되었습니다. 사이버 위험도가 낮다고 판단되어 Fable 5보다는 완화된 설정이었습니다. 이번 Sonnet 5.5는 이 기준이 Opus 5.5 수준으로 상향되었다는 변화가 있습니다.
- 사이버 보안 - 사이버 역량이 Sonnet 5 대비 대폭 향상되어 Opus 5에 필적함에 따라 Opus 5.5와 동일한 safeguards를 적용해 배포됩니다. 일반적인 개발 과정에서 코드 버그를 찾아 수정하는 것은 가능하지만, 위험도가 높은 사이버 보안 태스크는 명시적인 방식으로 Sonnet 5로 전환됩니다. 방어 측면의 전문가를 위해 확장된 Cyber Verification Program 신청이 곧 열릴 예정이며, 승인 시 Sonnet 5.5·Opus 5.5·Mythos 모델의 고도화된 기능에 단계적으로 접근할 수 있게 됩니다.
- 생물학 - Sonnet 5.5의 생물학 관련 safeguards는 Sonnet 5와 동일합니다. 유해한 요청을 차단하기 위한 장치로 연구·교육·임상 작업의 대부분에는 영향을 주지 않으나, 미생물학이나 바이러스학 관련 요청 중 일부가 오탐될 수 있다고 명시되어 있습니다. 생물학 관련 광범위한 작업이 필요한 기관은 Life Sciences Verification Program에 신청할 수 있습니다.
- 증류(Distillation) 방지 - 대량의 위조 계정을 이용해 모델의 능력을 추출하려는 증류 공격을 방어하기 위해 추론 추출을 차단하는 안전 분류기를 탑재해 배포되는 최초의 Sonnet 모델입니다. 또한 preserved thinking 적용 범위가 확대되어 Claude의 사고 과정을 이를 생성한 계정으로부터 분리할 수 없게 되었습니다.
증류 방지 조치는 일반 개발자라면 변화를 체감하기 어려울 것이라고 합니다. 다만 여러 계정을 넘나들며 대화를 이전하는 방식, 예를 들어 Claude Code 세션 도중에 계정을 전환하는 경우에는 영향이 있을 수 있으므로 해당 사항이 있다면 공식 문서 링크를 확인해 두는 것이 좋습니다.
Claude Code 사용자 입장에서 신경 쓰이는 부분은 보안 관련 작업 중 일부가 Sonnet 5로 강제 전환된다는 점일 것입니다. 통상적인 버그 수정에는 영향이 없다고 하지만, 고위험으로 판정되는 취약점 조사 등의 작업을 수행할 때는 기존과 동작이 달라질 가능성을 염두에 두어야 합니다.
API 마이그레이션 시 thinking 설정 주의사항
기존 Sonnet과 마찬가지로 Sonnet 5.5는 zero data retention(데이터 미보관 정책) 대상 모델로 제공됩니다. 발표 당일부터 모든 플랫폼에서 제공이 시작되어 Amazon Web Services, Google Cloud, Microsoft Azure에서도 이용할 수 있습니다. API 모델 ID는 claude-sonnet-5-5입니다.
API 환경에서 Sonnet 5로부터 마이그레이션할 때 주의할 점은 thinking(답변 전 생각하기) 기능을 꺼두고 사용하던 환경입니다. 마이그레이션 가이드에 따르면 Sonnet 5에서 thinking을 끌 때 사용했던 thinking: {"type": "disabled"} 설정은 Sonnet 5.5에서 400 에러를 반환합니다. 대신 새로 추가된 between_tools를 지정해야 합니다.
{
  "model": "claude-sonnet-5-5",
  "max_tokens": 16000,
  "thinking": {"type": "between_tools"},
  "output_config": {"effort": "high"},
  "messages": [{"role": "user", "content": "..."}]
}
between_tools는 Sonnet 5.5에서 제공하는 가장 낮은 단계의 thinking 설정으로, 최종 답변 전에는 생각 과정을 거치지 않지만 도구 호출 사이사이에 사고 블록이 반환됩니다. 가이드에서는 이외에도 다음과 같은 제약 사항을 안내하고 있습니다.
- 사용할 수 있는 effort 옵션은
low·medium·high뿐이며,xhigh나max와 조합하면 400 에러 발생 - 대화 중간에 effort를 변경할 수 없음. 턴마다 effort를 달리 적용하려면 adaptive thinking을 활용해야 함
between_tools가 정의되지 않은 구버전 SDK에서는 Python 및 TypeScript 환경에서 타입 체크 에러가 발생함. SDK를 업데이트하거나 값을 raw JSON 형태로 전달해야 함
또한 Sonnet 5.5는 thinking을 별도로 지정하지 않으면 사고 기능이 기본 활성화됩니다. 기존에 thinking 없이 동작하던 코드는 다음 사항도 점검해 두는 것이 안전합니다.
- 응답의 맨 앞에
thinking블록이 올 수 있으므로content[0].text접근을 전제하지 말고 블록의type으로 구분하여 처리 - 도구 호출 루프 내에서는 빈 블록을 포함해
thinking블록을 수정 없이 그대로 반환 max_tokens값에 사고 과정에 소모되는 토큰도 포함되며, 사고 토큰은 출력 토큰으로 과금되므로 제한치를 재검토
가이드에서는 Claude Code의 /claude-api migrate 명령을 통해 기본 제공되는 Claude API 스킬로 마이그레이션을 자동화하는 방법도 소개하고 있습니다. 모델 ID 변경, 에러를 유발하는 파라미터 수정, effort 조정을 일괄 처리하고 수동 확인이 필요한 항목을 체크리스트로 정리해 준다고 합니다.
Claude Code에서 테스트해 보기
제가 사용하는 환경의 Claude Code(2.1.284)에서 확인해 본 결과, 모델 별칭인 sonnet은 이미 claude-sonnet-5-5를 가리키고 있었습니다. 실행 시 지정한다면 다음 둘 중 어느 쪽을 사용해도 Sonnet 5.5로 동작합니다.
claude --model sonnet
claude --model claude-sonnet-5-5
앞선 그래프에서 확인했듯 Sonnet 5.5의 진가는 낮은 effort에서의 탁월한 가성비이므로, 우선은 기본값인 Medium 상태 그대로 일상적인 버그 수정이나 간단한 기능 추가를 맡겨보는 것을 추천합니다.
현재 환경에서 Sonnet 5.5로 전환되지 않는다면 먼저 claude --version으로 버전을 확인하고, 구버전이라면 업데이트 후 재실행해 보시기 바랍니다.
claude update
표시 여부나 기본 동작은 플랜, provider, 관리자 설정에 따라 다를 수 있습니다. 여전히 Homebrew나 npm을 통해 Claude Code를 사용하고 계신 분들은 이번 기회에 네이티브 설치 방식으로 전환해 두면 자동 업데이트가 적용되어 새로운 모델 출시 시 원활하게 따라갈 수 있습니다. 자세한 절차는 Claude Code를 Homebrew에서 네이티브 설치로 전환했더니 쾌적해진 후기에 정리해 두었습니다.
Sonnet 5와 Sonnet 5.5 비교
주요 차이점을 표로 정리했습니다.
| 항목 | Sonnet 5 | Sonnet 5.5 |
|---|---|---|
| 요금 (입력/출력・1M 토큰당) | $2 / $10 | $2 / $10 (동결) |
| 태스크당 비용 | 기준 | 최대 30% 절감 |
| 출력 생성 속도 | 기준 | 30% 이상 빠름 |
| Terminal-Bench 4.0 | 10.3% | 70.6% |
| CursorBench 4.0 | 34.1% | 55.5% |
| GDPval-AA v2.1 | 1449 | 1844 |
| 사이버 보안 safeguards | Opus 4.7·4.8과 동일 (Fable 5보다 완화) | Opus 5.5와 동일 (개입 시 Sonnet 5로 전환) |
| thinking 비활성화 설정 | disabled | between_tools |
| API 모델 ID | claude-sonnet-5 | claude-sonnet-5-5 |
벤치마크 수치는 이번 공식 발표의 비교표를 기준으로 작성되었습니다.
실무 사용자에게 어떤 점이 유익한가?
지금까지의 내용을 실제 업무에 어떻게 활용할 수 있을지 관점에서 다시 정리해 보겠습니다.
1. 동일한 비용으로 성능이 비약적으로 상승
Terminal-Bench 4.0이 10.3%에서 70.6%로 올랐고, GDPval-AA는 Opus 5.5와 대등한 수준입니다. 가격표는 Sonnet 5 그대로 유지되므로 기본 설정으로 사용해 오셨다면 모델 ID만 변경해도 바로 성능 향상을 체감할 수 있습니다. 단, thinking을 비활성화해 둔 API 구현체는 코드 수정이 필요합니다.
2. 낮은 effort에서도 충분히 강력한 성능
Low나 Medium 설정의 Sonnet 5.5가 Sonnet 5의 최고 점수를 약 10분의 1 비용으로 앞섭니다. 서브 에이전트 작업이나 대규모 배치 처리 등 호출 빈도가 높은 작업일수록 비용 절감 효과가 커집니다.
3. Opus 5.5와의 역할 분담이 더욱 명확해짐
일부 벤치마크에서는 effort를 높일 경우 Opus 5.5와 비슷한 비용으로 비슷한 수준의 결과물에 근접하므로, 심도 있는 사고가 필요한 작업은 Opus 5.5에, 빠르고 경제적으로 처리해야 하는 작업은 Sonnet 5.5의 낮은 effort에 할당하는 식으로 명확한 역할 분리가 가능해졌습니다.
4. 사이버 보안 태스크 및 API thinking 설정 확인 필요
주의할 점도 있습니다. 보안 관련 작업 일부는 Sonnet 5로 자동 전환되며, API에서 thinking을 disabled로 설정해 둔 코드는 between_tools로 수정해야 오류를 방지할 수 있습니다.
요약
Claude Sonnet 5.5의 핵심 내용을 요약하면 다음과 같습니다.
- Claude 5.5 패밀리의 두 번째 모델. Opus 5.5를 보완하는 더 빠르고 경제적인 모델로 자리매김. Haiku 5.5도 수주일 내 출시 예정.
- Terminal-Bench 4.0은 70.6%(Sonnet 5는 10.3%, Opus 5.5는 66.4%), CursorBench 4.0은 55.5%, GDPval-AA v2.1은 1844(Opus 5.5는 1846).
- Terminal-Bench 4.0 외의 항목에서는 Opus 5.5가 우세하며, 복잡하고 답이 정해지지 않은 작업에서는 Opus 5.5가 확실히 강력함.
- Low 및 Medium 설정에서도 일부 벤치마크 기준 Sonnet 5의 최고 점수를 약 10분의 1 비용으로 능가.
- 요금은 Sonnet 5와 동일한 1M 토큰당 입력 $2, 출력 $10, cache read $0.20. 태스크당 최대 30% 저렴하고 출력 속도는 30% 이상 향상.
- 기본 effort는 Claude Code 및 앱에서 Medium, Claude Platform에서 High.
- UI 구성 및 슬라이드 산출물 완성도 등 디자인 감각 측면에서도 호평.
- 자동 행동 감사 대부분의 지표에서 Sonnet 5와 동등 이상 달성.
- 사이버 safeguards가 Opus 5.5 수준으로 강화되었으며, 추론 추출 방지 분류기를 Sonnet 최초로 탑재. 고위험 사이버 태스크는 Sonnet 5로 전환 처리됨.
- API 모델 ID는
claude-sonnet-5-5. thinking 비활성화 시disabled대신between_tools사용 필요.
Opus 5.5 관련 글에서 상위 클래스에서 먼저 개척한 성과가 몇 주 뒤 합리적인 가격대의 모델로 내려오는 흐름에 대해 언급한 바 있습니다. 이번에는 그 주기가 단 1주일 만에 Sonnet으로 내려온 셈입니다. 일부 지식 노동 벤치마크에서 Opus 5.5에 육박하면서도 입출력 단가는 Opus 5.5의 절반 수준인 모델이 등장함에 따라, 어떤 작업을 어떤 모델에 위임할지 워크플로우를 재정비하기에 최적의 타이밍이라고 봅니다.
저 역시 당분간 Claude Code의 메인 엔진은 Opus 5.5로 유지하되 자잘한 코드 수정이나 서브 에이전트 작업은 Sonnet 5.5로 넘기며 최적의 밸런스를 테스트해 볼 생각입니다. 추가로 공유할 만한 팁이 생긴다면 다시 글을 통해 정리해 전달해 드리겠습니다.