Fable、Opus、Sonnet、Haiku のどれで作るか。Anthropic の答えは「迷ったら Opus 5.5 を medium で」
目次
2026年11月9日、Anthropic の開発者向けブログ claude.dev に「Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku」という記事が載りました。書いたのは Addy Osmani さんです。Claude Fable 5.2 の発表と同じ日の公開で、モデルが4つそろった今、どの仕事にどのモデルを当てればよいかを一本にまとめています。
記事によると、現在一般提供されている Claude のモデルは Haiku 5.5、Sonnet 5.5、Opus 5.5、Fable 5.2 の4つです。これとは別に、サイバーセキュリティと生命科学の研究向けに Claude Mythos 5.2 があり、こちらは Anthropic の認証プログラムを通じて提供されています。
Claude Code を毎日使っていると「この作業に Fable は大げさだろうか」「Sonnet で足りるだろうか」と迷う場面が増えました。今日はこの記事の要点を、数字とあわせて順に紹介します。
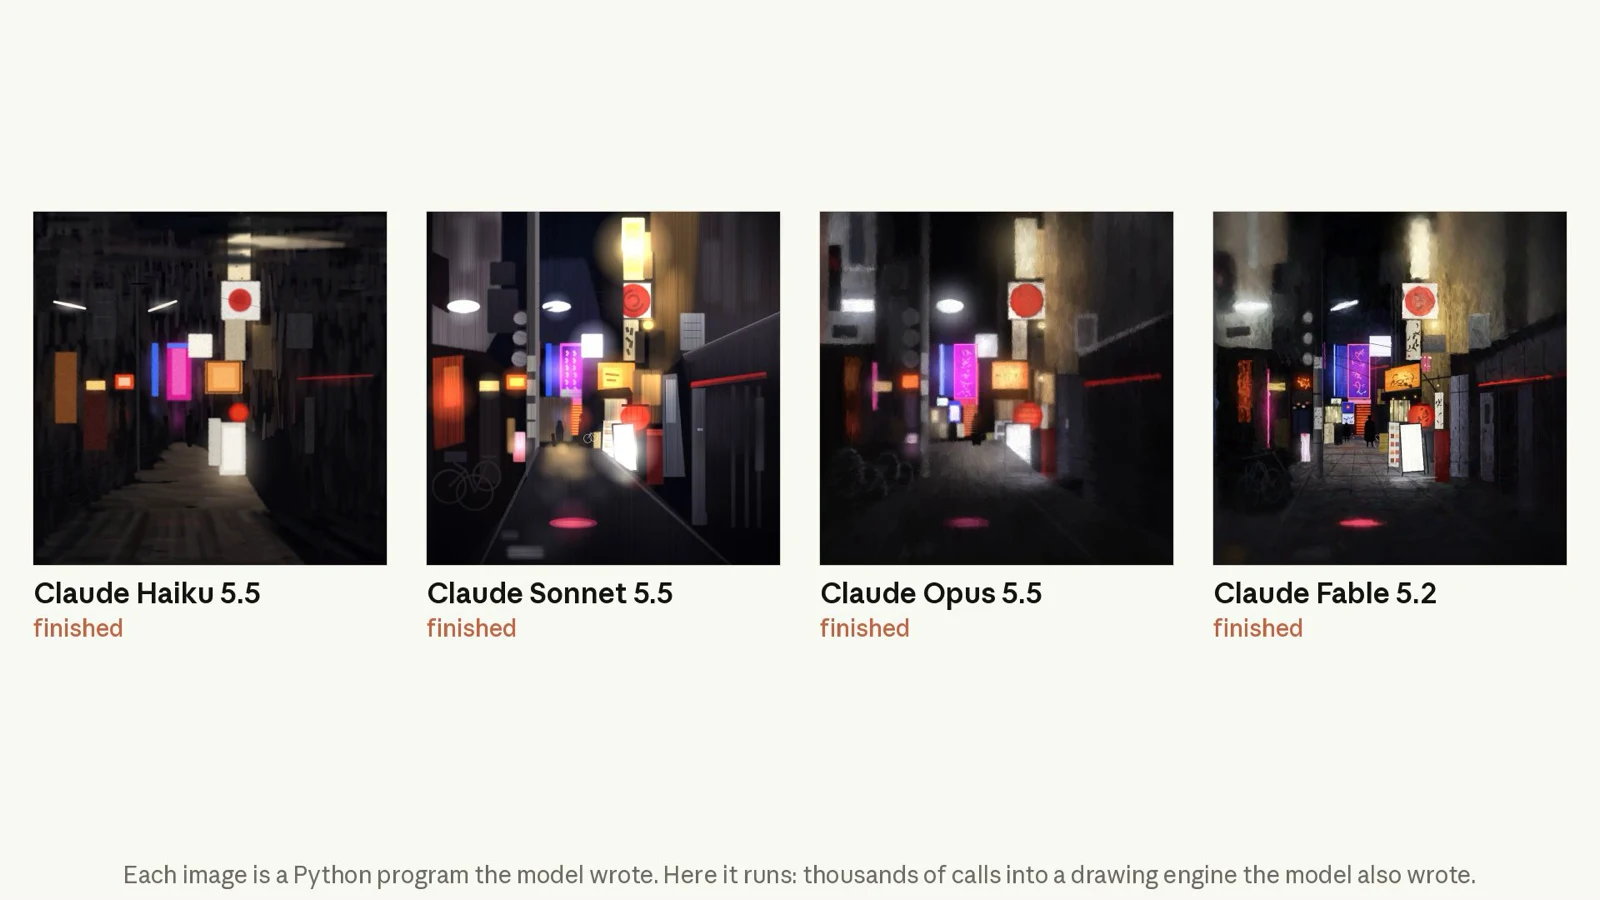 (出典:Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku)
上の図は記事の冒頭にあるデモです。1枚の路地の写真を、4つのモデルがそれぞれ Python のプログラムとして描き直しています。描画エンジンもモデル自身が書いたもので、デモは Lance Martin さんが作りました。
迷ったら Opus 5.5 を medium で始める
記事が最初に示す答えは明快です。たいていの仕事は "start most work on Opus 5.5 at its default effort level, medium" とあり、Opus 5.5 を既定の effort である medium で始めることを勧めています。
記事は理由を2つ挙げています。Opus 5.5 は Claude Code の既定のモデルであること。そして入力と出力のトークン単価が Fable 5.2 の半分であることです。記事はコーディングとナレッジワークの多くで、まず Opus 5.5 から始めることを推奨しています。
そこから仕事に合わせて上下に動かします。
- Sonnet 5.5 に下げるのは、バグ修正や仕様が決まった機能の実装のように、範囲がはっきりした日常の作業です。ただし記事は、仕様が明確だからといって Sonnet で足りるとは限らないと注意しています。移行やパフォーマンス改善は仕様が明確でも難しく、Opus 5.5、大きなものなら Fable 5.2 が向くことがあります
- Haiku 5.5 まで下げるのは、分類、ルーティング、抽出のような単純で量の多い仕事です。大きいモデルの脇で雑務をこなすサブエージェントにも向いています
- Fable 5.2 に上げるのは、コーディング、金融、科学の最も難しい技術的なプロジェクトです。Opus 5.5 を high にしても届かないとき、長時間の無人実行をさせるときも、記事は Fable 5.2 を勧めています
Opus 5.5 と Sonnet 5.5 の発表時の内容は、以前の記事「Claude Opus 5.5 が登場。Fable 5.1 級の性能を、Opus 5 より 40% 安く」と「Claude Sonnet 5.5 が登場。Sonnet 5 と同じ料金のまま、30% 以上速く Opus 5.5 に迫る」で紹介しています。
モデルを替える前に effort を動かしてみる
記事は、モデルを替える前に effort(考える量を調整する設定)を試すよう勧めています。effort はコストと能力の両方を、モデルの切り替えより細かく調整できるダイヤルだからです。
ただし high より上は事情が変わります。記事によると、high を超えて effort を1段上げると、1つ大きいモデルと同じくらいのコストがかかることがあります。そこで記事は、high を超えそうなら1つ上のモデルを低めの effort で試し、自分の仕事で両方を比べるよう勧めています。逆に1段下げるだけで、必要な結果をより安く得られることもあります。
effort を上げると効くのは、モデルが長く考える、ツールを多く呼ぶ、自分の作業を何度も確かめる、といった場面です。その分、待ち時間は長くなります。また記事は、モデルがもともと持っていない知識や技能は、effort を上げても補えないと書いています。つまり、ないものはない、ということですね。その場合は、モデルを1つ上げるしかありません。
用途別の出発点
記事には、仕事の種類ごとに「どのモデルを、どの effort で始めるか」をまとめた表があります。日本語にすると次のとおりです。
| 仕事 | 始めるモデル | 始める effort | 理由 |
|---|---|---|---|
| 日常のエンジニアリングとデバッグ、複数の PR にまたがる機能開発 | Opus 5.5 | medium(既定)、次に high | 日常の仕事でコストと能力の釣り合いがよい |
| 分類、ルーティング、タグ付け、大量の抽出 | Haiku 5.5 | medium(既定) | ファミリーで最も安く、最も速い |
| ファイル検索、ログ読み、要約をするサブエージェント | Haiku 5.5 または Sonnet 5.5 | 各モデルの既定 | 間違いを見つけやすく、判断はメインのモデルが担う |
| チャットと対話的なセッション | Sonnet 5.5(単純なチャットを大量にさばくなら Haiku 5.5) | low または medium | Sonnet 5.5 は low や medium で特に速い |
| バグ修正、機能の改良、仕様に沿った実装など範囲の決まったコーディング | Sonnet 5.5 | medium、難しければ high | Opus 5.5 の半分のトークン単価で、範囲の決まった仕事をこなす |
| 日常の文書、スライド、スプレッドシート | Sonnet 5.5 | high(既定。Claude Code では medium) | 反復が速く、デザインの目も確か。複雑な財務モデルや大量の資料から作る文書は Opus 5.5 から |
| 調査、レビュー、下書きなど繰り返し実行するエージェントの仕事 | Sonnet 5.5 | medium | 定義のはっきりした繰り返しの仕事に大きいモデルはまず要らない |
| コンピューター操作と画像を多く扱うワークフロー | Opus 5.5 | medium | 大量のスクリーンショットや画像を扱う長いエージェントのループは Opus 5.5 の得意分野 |
| 大規模なリファクタリングと移行、アーキテクチャの計画、多数のサブエージェントの統率 | Fable 5.2 | medium、次に high(API の既定は high) | 技術分野で Anthropic の最も高性能な一般提供モデル |
| 深いリサーチ、科学や定量的な分析 | Fable 5.2 | medium、次に high(API の既定は high) | コーディング、金融、科学の最も難しい仕事のために作られている |
| まだ決めかねている | Opus 5.5 | medium(既定) | Claude Code が Pro、Max、Ultra、Team、Enterprise と Anthropic API で既定にしており、プラットフォームのドキュメントも出発点に勧めている |
(出典:Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku)
僕が目を留めたのは、サブエージェントの行です。記事は理由として「間違いを見つけやすい」ことを挙げています。速さや安さではなく、ミスの見つけやすさで任せる範囲を決めているわけです。この考え方は、後半のサブエージェントの話でも繰り返し出てきます。
4つのモデルを並べて比べる
記事には4つのモデルの仕様を並べた表もあります。価格は Claude API の定価です。
| Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.2 | |
|---|---|---|---|---|
| 向いている仕事 | 量が多く、コストに敏感な仕事 | 範囲の決まった仕事を速く確実に | 複雑なコーディングとナレッジワークの日常の主力 | 最も野心的で、答えの決まっていない技術的な仕事 |
| 速さ(相対) | 最も速い | 速い | 中程度 | 中程度 |
| 入力 / 出力(100万トークンあたり) | プロンプトが 10万トークンまで $0.10 / $0.50、超えると $0.50 / $2.50 | $2 / $10 | $4 / $20 | $8 / $40 |
| キャッシュ読み込み(100万トークンあたり) | 10万トークンまで $0.01、超えると $0.05 | $0.10 | $0.20 | $0.20 |
| コンテキストウィンドウ | 100万トークン | 100万トークン | 100万トークン | 100万トークン |
| 最大出力 | 12.8万トークン | 12.8万トークン | 12.8万トークン | 12.8万トークン |
| API での thinking | adaptive。既定でオン、オフにもできる | adaptive。既定でオン。between_tools で最初の思考を省ける | adaptive。常にオン | adaptive。常にオン |
| API での既定の effort | medium | high(Claude Code では medium) | medium | high(Claude Code では medium) |
| fast mode | なし | なし | あり | あり |
(出典:Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku)
Claude Code の effort の既定値は API と異なることがあります。記事は、自分の設定を /effort status で確認できると書いています。
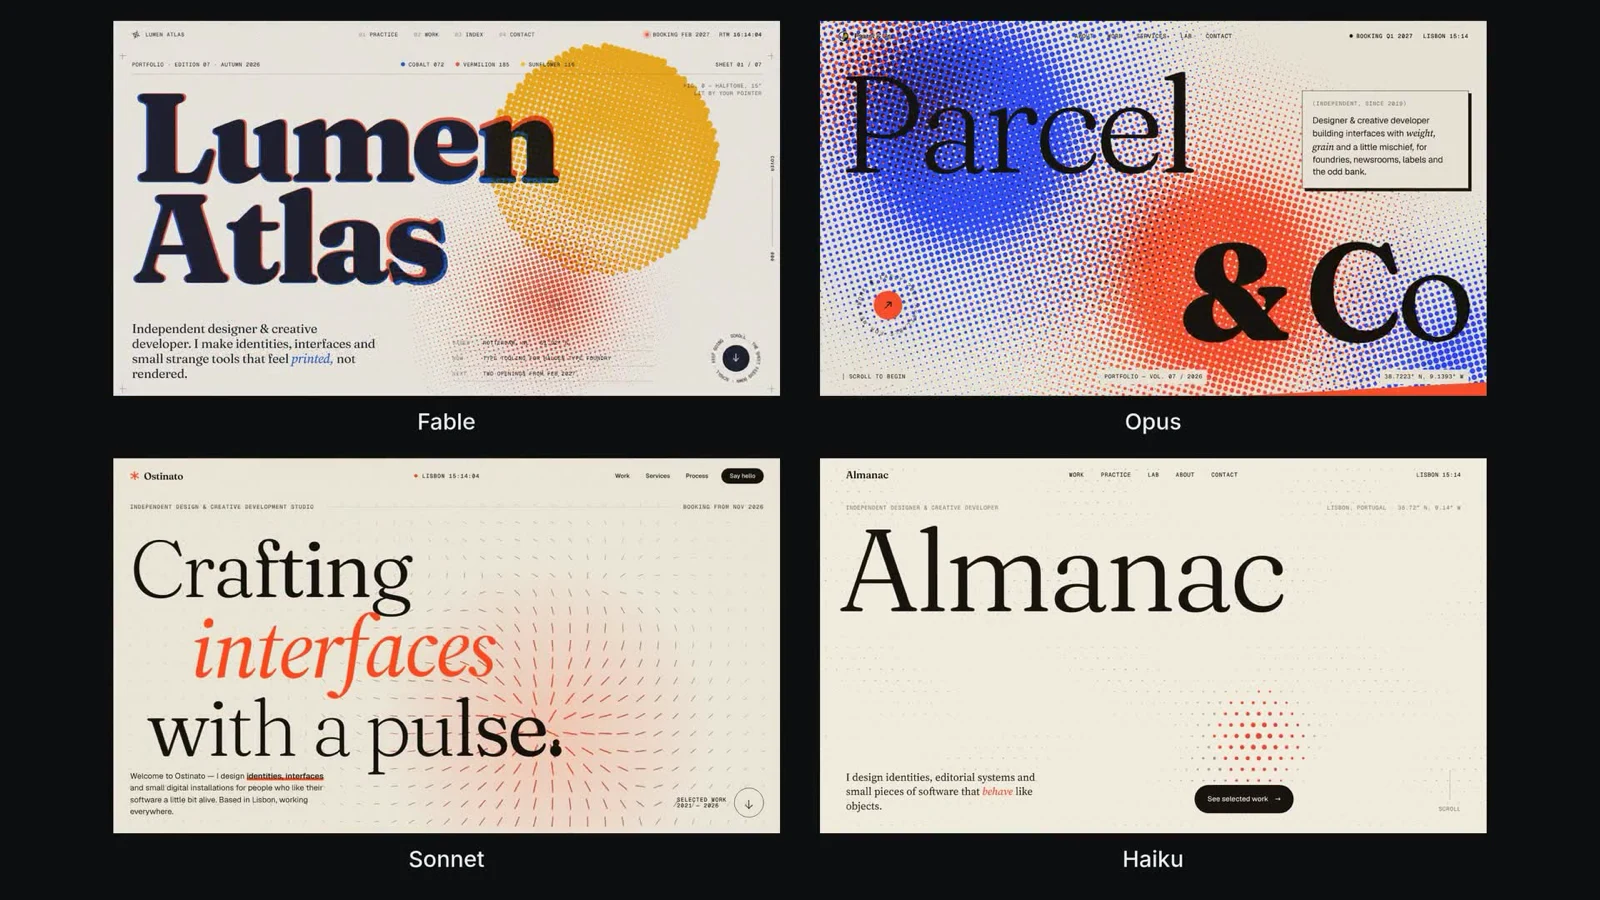 (出典:Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku)
上の図は、4つのモデルに同じポートフォリオサイトを作らせたデモで、Addy Osmani さんが作りました。
トークン単価が高くても、タスクあたりで高いとは限らない
一般に、大きいモデルほどトークン単価は高く、能力も高くなります。しかし記事は、タスク単位で見るとこの関係がいつも成り立つわけではないと指摘しています。
記事が挙げる例は2つです。
- Anthropic が Terminal-Bench 3.0 を走らせたところ、前世代の Fable 5.1 は max で 58.0% でした。一方の Opus 5.5 は high で 58.9% を取り、使ったトークンは半分でした
- FrontierCode 2.0 では、Fable 5.2 の high が 45.3%、Opus 5.5 の max が 45.5% でほぼ並びました。このとき Fable 5.2 のタスクあたりのコストは、Opus 5.5 のおよそ半分でした
(出典:Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku)
ここから記事は、難しい仕事で Opus 5.5 の effort を high より上げる前に Fable 5.2 を試すよう勧めています。日常の仕事なら、出発点は変わらず Opus 5.5 の medium です。
一方で記事は、小さいモデルの限界にも触れています。Claude Platform のコストと性能の測定では、小さいモデルは出力を検証しやすい大量の仕事では健闘しますが、長いエージェントのループには向きません。
もう1つ大事な指摘があります。2つのモデルを比べるときは、典型的なタスクだけでなく、最も難しいタスクの値段も見積もるべきだという点です。費用の大半は難しいタスクが占めるからです。記事によると、ある20問の検索ベンチマークでは、たった2問が費用の43%を占めました。
速さと正確さの釣り合いを考える
速い設定ほど早く終わりますが、取りこぼしも増えます。記事は、人がどれだけ待てるかを考えてからモデルと effort を選ぶよう勧めています。人が返事を待つ用途なら、Sonnet 5.5 を low か medium で始めるのが記事の推奨です。
世代が新しくなると速くなることもよくあります。記事によると、Fable 5.2 の出力は Fable 5.1 より最大30%速く、Sonnet 5.5 は Sonnet 5 より30%速く動きます。
effort と待ち時間は、おおむね比例します。記事は SWE-bench Pro での Opus 5.5 の結果を、high を基準に次のように示しています。
| effort | high と比べたスコア | high と比べたコスト |
|---|---|---|
| low | 約8ポイント低い | 約3分の1 |
| medium | 約2.5ポイント低い | 約70% |
| xhigh | 約1.4ポイント高い | 2.5倍 |
(出典:Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku)
届かないときに試す順番
記事は、effort を変えるより、モデルが自分の作業を検証できる手段を用意するほうが費用対効果がよく、待ち時間も増えにくいことが多いと書いています。モデルの力が足りないと感じたら、次の順に試すよう勧めています。
- モデルが自分の作業を検証できるか確かめる。テスト、ビルド、エンドポイントを呼ぶスクリプトなど
- effort を1段上げる
- 1つ上のモデルに移る。effort は、小さいモデルで使っていた値より低めから始める
結果を自動で判定できるなら、全件を low で走らせ、失敗したものだけを high でやり直す方法もあります。記事によると、先ほどと同じ SWE-bench Pro の一部で、Opus 5.5 を low で走らせて失敗分を high でやり直すと、約97%のタスクに通り、1件あたり約 $0.17 でした。全件を high で走らせた場合は 95.3% で、1件あたり $0.29 でした。
同じモデルのまま返事を速くしたいなら、能力を下げずにお金で速さを買う手もあります。Claude API では Opus 5.5 と Fable 5.2 に fast mode があり、割増料金で出力が速くなります。
コンテキストを大きくするとコストも増える
現行世代のモデルは、すべて100万トークンのコンテキストウィンドウを持っています。記事は、大きなコンテキストはタスクの完了を助ける一方で、ターンごとに送り直すため毎回コストがかかると指摘しています。ただ、長い実行では入力の大半がキャッシュ読み込みとして課金されます。
キャッシュ読み込みの単価は、Opus 5.5 と Fable 5.2 がどちらも100万トークンあたり $0.20、Sonnet 5.5 が $0.10 です。そのため、キャッシュの多い長い実行では、Fable と Opus の差はキャッシュされない入力と出力の部分だけになります。記事はそこで Fable のトークン単価が Opus の2倍になると説明しています。
記事が引く「What a task costs on Opus 5.5」の試算では、Opus 5.5 で1ターンのキャッシュ読み込みにかかる費用は、コンテキストが15万トークンなら約 $0.03、2万トークンなら約 $0.004 です。
ここから記事は、メインのモデルが大きいほど、メインのコンテキストを小さく保つ意味が大きくなると結論づけています。高いモデルのコンテキストは判断のために取っておき、長い資料を読む仕事は安いサブエージェントに任せる、という考え方です。
Haiku 5.5 だけはプロンプトの長さで単価が変わる
Haiku 5.5 は、プロンプトの長さでトークン単価が変わる唯一のモデルです。10万トークンまでのプロンプトは安い料金で、超えると5倍の料金になります。記事によると、長いプロンプトの料金でも Sonnet 5.5 のトークン単価の4分の1に収まり、短いプロンプトなら入力単価は Sonnet 5.5 の20分の1です。
そのため記事は、毎回長いプロンプトが必要な用途では、定価ではなく、完了したタスクあたりのコストで Haiku 5.5 と Sonnet 5.5 を比べるよう勧めています。
モデルを組み合わせる
記事の後半は、1つのシステムで複数のモデルを使い分ける方法です。
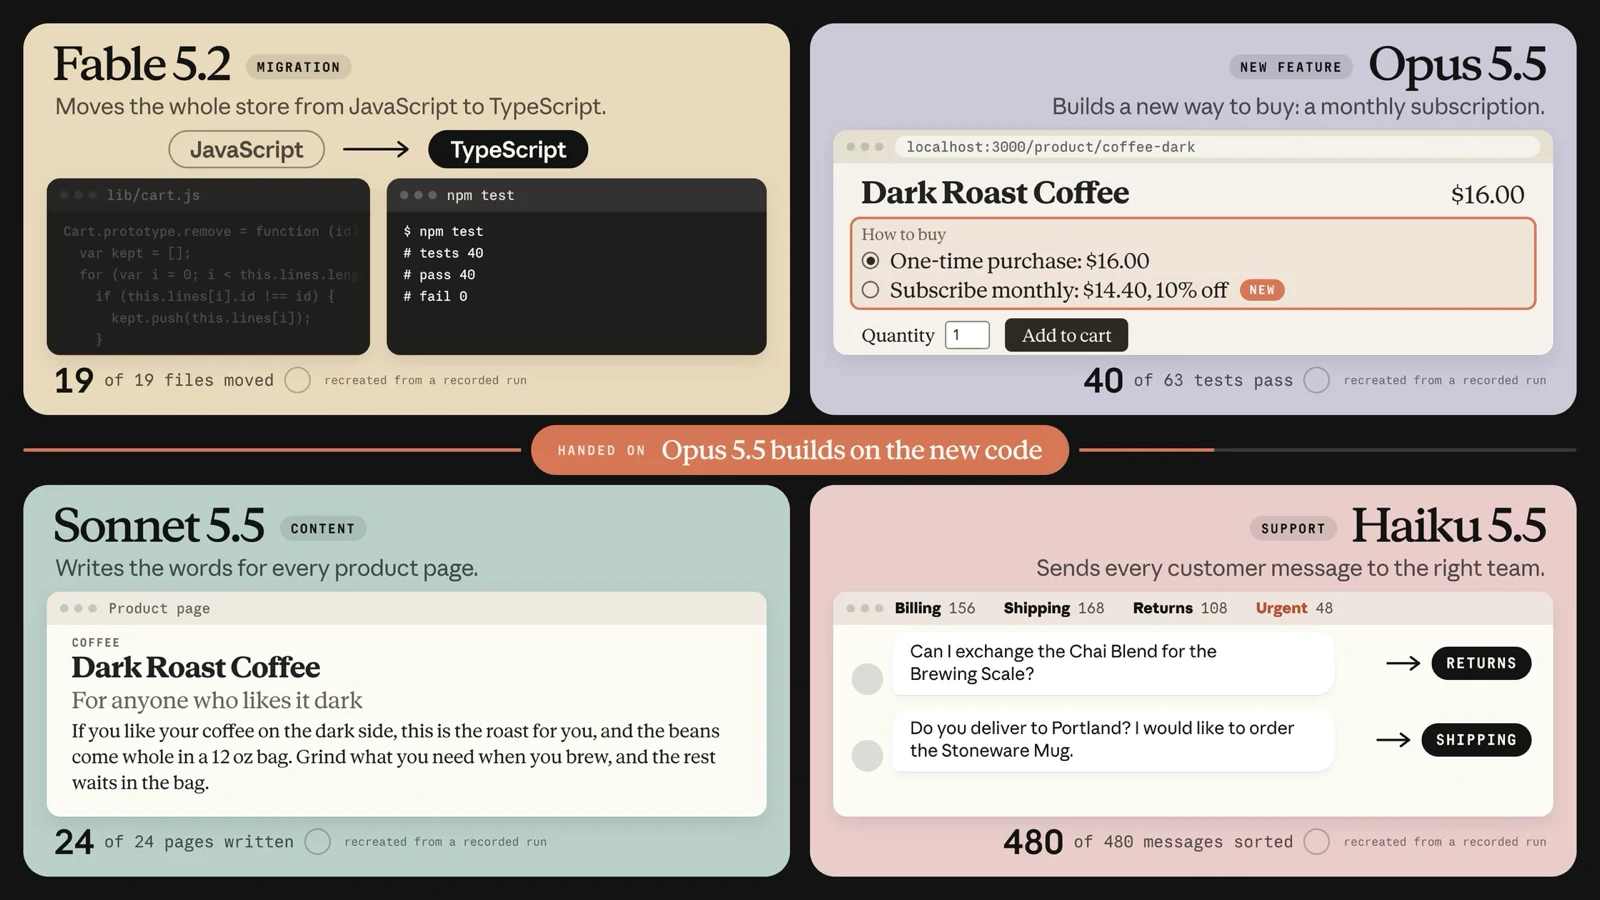 (出典:Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku)
上の図は、1つのプロジェクトで4つのモデルに別々の仕事を割り振ったデモで、Dan Fein さんが作りました。Fable 5.2 がオンラインショップを JavaScript から TypeScript に移し、その新しいコードの上で Opus 5.5 が月額定期購入の機能を作ります。Sonnet 5.5 は商品ページの文章を書き、Haiku 5.5 は顧客からのメッセージを振り分けます。
切り替えは区切りのいいところで
記事によると、プロンプトキャッシュはそれを書いたモデルのものです。新しいモデルに切り替えた最初のターンでは、会話全体にキャッシュ書き込みの料金がかかります。このターンを小さくするために、記事は Claude Code なら先に /compact を実行するか、短い計画を書いて新しいセッションを始めるよう勧めています。API なら、会話の履歴をすべて渡す代わりに、それまでの作業の要約から新しいモデルとの会話を始めます。
thinking のブロックも引き継げるとは限りません。各ブロックには書いたモデルが記録されていて、モデルごとに読めるブロックが決まっています。記事によると、Claude API と Google Cloud 上の Claude Models(Google 管理)では次のとおりです。
- Opus 5.5 は、Sonnet 5.5 と Haiku 5.5 のブロックを読める
- Sonnet 5.5 は、Haiku 5.5 のブロックを読める
- Fable 5.2 は、Opus 5.5、Sonnet 5.5、Haiku 5.5 のブロックを読める
- Claude API では、Fable 5.1 も Opus 5.5 のブロックを読める
モデルは上位のモデルのブロックを読めないので、1段下のモデルに移ると、それまでの推論は失われます。新しいモデルが前のモデルのブロックを読めないとき、API はそのブロックを捨て、リクエスト自体は成功します。記事は、Fable 5.2 から他の一般提供モデルに移ると、Fable 5.2 の推論はどれでも捨てられると書いています。エラーにならずに推論だけが消えるので、気づきにくい点だと思います。
サブエージェントは小さいモデルで動かす
サブエージェントは自分のコンテキストウィンドウで動き、要約を返します。トークンの料金は、サブエージェントが動いているモデルの単価で決まります。Claude Code では、サブエージェントの定義に model: haiku や model: sonnet を書きます。モデルを指定していないサブエージェントの既定は、環境変数 CLAUDE_CODE_SUBAGENT_MODEL で決められます。
記事には、.claude/agents/log-reader.md として保存する例が載っています。テストの出力とログを読み、失敗したケースを報告するだけのサブエージェントです。
---
name: log-reader
description: Reads test output and logs, and reports each failing case. Use after a test run.
tools: Read, Grep, Glob, Bash
model: haiku
---

Read the logs you're given. For each failure, report the file, the test name and the first error line. Don't edit any files.
記事は、小さいモデルにはファイル探し、テストの実行、ログ読みのように、間違いを見つけやすい仕事を任せるよう勧めています。コードの編集と判断はメインのモデルに残します。小さいモデルが検索結果を読み違えると、メインのモデルが間違ったファイルを開いてトークンを無駄にするからです。
Claude Code を使っている人に関係の深い注意点が3つあります。
- 組み込みの Explore サブエージェントは、Haiku 固定ではなくなりました。現行の Claude Code では、セッションと同じモデルで動きます。Claude API では、そのモデルは Opus が上限です。探索を安く済ませたい場合、記事は
model: haikuを指定した Explore という名前のサブエージェントを自分で定義するよう勧めています。haikuという別名が指すモデルはANTHROPIC_DEFAULT_HAIKU_MODELで固定できます - Anthropic API では、
haikuの別名が Haiku 5.5 を指すようになりました。これには Claude Code v2.1.293 以降が必要です。Amazon Bedrock、Google Cloud、Microsoft Foundry、AWS 上の Claude Platform では、まだ Haiku 4.5 を指します opusplanは記事の勧めと逆の分担になります。opusplanはプランモードでは Opus で計画を立て、実行は Sonnet で行う別名です。つまりコードの編集が Sonnet に回ります。記事はコードの編集をメインのモデルに残すよう勧めているので、opusplanを既定にする前に自分の仕事で測るよう求めています
難しい判断だけ advisor に相談する
advisor tool(ベータ)は、速くて安い実行役のモデル(executor)と、強い相談役のモデル(advisor)を組み合わせる仕組みです。executor がタスクを進め、途中で advisor に助言を求められます。トークンの大半は executor の単価で課金されます。
ただし記事の評価は慎重です。advisor が役に立つのは、executor にない能力を advisor が補い、かつ executor が実際に助言を求めたときだけです。effort が低いと、executor は助言をあまり求めません。記事によると、プラットフォームのコストガイドにある4つの組み合わせのうち、executor 単独をはっきり上回ったものは1つもありませんでした。
記事が示す例では、Opus 5.5 の high を executor、Fable 5.1 を advisor にした組み合わせが、社内のコーディングベンチマークで 90.1%、1回あたり $2.92 でした。Opus 5.5 を high で単独で動かした場合より1.7ポイント高い一方、費用は約2.1倍です。記事は、この程度の差は実行ごとのばらつきの範囲に近く、effort を上げても得られた程度の改善だと書いています。
組み合わせにも制約があります。どのモデルを advisor にできるかは、executor にするモデルによって決まっています。記事によると、Sonnet 5.5 を executor にした場合は、Fable 5.2、Opus 5.5、Opus 5、Sonnet 5.5 のどれでも advisor にできます。一方、Fable 5.2 を executor にした場合に advisor にできるのは、Fable 5.2 と Mythos 5.2 だけです。Fable 5.2 に作業させて、Opus 5.5 のような別のモデルに相談させる、という組み合わせはできません。
大量の仕事は安いワーカーに分ける
サブエージェントは、1つのメインのモデルが流れを握ったまま脇の仕事を任せる形でした。記事はこれとは別に、1つのコンテキストウィンドウに収まらない大きな仕事のための形も紹介しています。上位のモデルがリーダーとなって仕事を分け、多数の安いワーカーに並行して渡し、戻ってきた結果をまとめる形です。
記事によると、約2,200万トークンのソースコードから不具合を探す社内のベンチマークで、Opus 5.5 のリーダーが最大25個の Sonnet 5.5 のワーカーを同時に動かしたところ、Opus 5.5 を既定の effort で単独で動かすより費用が約3分の1少なく、スコアはほぼ同じでした。
Claude Platform では、Claude Managed Agents のマルチエージェント機能で、コーディネーターのエージェントとワーカーの一覧を用意できます。ただし記事は、前のステップの結果に依存する一本道の仕事や、1つのコンテキストウィンドウに収まる仕事には使わないよう勧めています。そうした仕事では、計画とまとめの費用のほうが節約分より大きくなるからです。
API で組み込むなら、移行する前に互換性を確かめる
API で Claude を組み込んだアプリを作っている方に向けて、記事はモデルを切り替える前に確かめておくべき違いもまとめています。たとえば、thinking をオフにできないモデルがあること、tool_choice でツールの使用を強制すると 400 エラーになるモデルがあること、会話の履歴を自前で書き換えているとエラーになる場合があること、などです。モデル名を書き換えるだけでは動かないことがあるので、該当する方は元の記事の一覧を確認しておくと安心です。
Claude Code で使っているだけなら、ここはほとんど気にしなくて大丈夫です。リクエストは Claude Code が組み立てるので、履歴の扱いについても対応は不要だと記事は書いています。1つだけ目にすることがあるのは、安全性のフォールバックです。サイバーセキュリティや生物学の内容が安全性の分類器に引っかかると、Claude Code はそのリクエストを古いモデルで実行し直すことがあります。そのときは、どのモデルに替わったかがトランスクリプトに表示されます。
自分の仕事で測る
記事は最後に、公開されたベンチマークの結果は出発点を決める材料にすぎないと念を押しています。候補が決まったら、自分のタスクで試してから決めます。記事が示す手順は次の4つです。
- 実際のタスクを何件か抜き出し、それぞれに成果の判定基準を書く。テストが通る、チケットが閉じる、行数が合う、など
- 候補のモデルを2〜3段階の effort で走らせる。キャッシュを共有しないよう、それぞれ別のセッションで動かす。完了したタスクごとのコストを、各応答の usage フィールドから記録する
- スコアと費用をグラフにする。複数モデルの構成は、どの単一モデルの点よりも優れている場合にだけ採用する
- 勝ったものを、実際のトラフィックの一部でシャドー運用してから切り替える
手早く確かめたいなら、Claude Code でバックログのタスクを1つ選び、/model で2つのモデルに解かせて、/usage の表示を比べる方法を記事は紹介しています。
まとめ
記事の内容を短くまとめると、次のようになります。
- 迷ったら Opus 5.5 を medium で始める
- 範囲の決まった仕事は Sonnet 5.5、単純で量の多い仕事は Haiku 5.5、最も難しい仕事や長時間の無人実行は Fable 5.2 に動かす
- モデルを替える前に effort を動かす。ただし high を超えるなら、1つ上のモデルを低めの effort で試す
- 力が足りないときは、検証手段の用意、effort を1段上げる、モデルを1つ上げる、の順に試す
- サブエージェントは、間違いを見つけやすい仕事だけ小さいモデルに任せる
- 決める前に、自分のタスクでスコアと費用を測る
僕にとって実用的だったのは、組み込みの Explore サブエージェントがセッションのモデルで動くようになったという指摘でした。Fable や Opus のセッションで探索を多用していると、気づかないうちに探索まで高いモデルで動いていることになります。model: haiku を指定した Explore を自分で定義する方法は、すぐに試せるので、気になる方は一度設定を見直してみてください。
参考リンク
- Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku(claude.dev Blog)
- Choosing a model(Claude Platform Docs)
- Optimizing for cost and intelligence(Claude Platform Docs)
- Effort(Claude Platform Docs)
- Model configuration(Claude Code Docs)
- Subagents(Claude Code Docs)