Claude Fable 5.2 と Mythos 5.2 が登場。ほぼすべての項目で Opus 5.5 を上回り、価格は2割下がった
目次
こんにちは。2026年11月9日(米国時間)、Anthropic から「Claude Fable 5.2」と「Claude Mythos 5.2」が発表されました。
9月の Fable 5.1 から2ヶ月あまりでの更新です。その間に Opus 5.5 と Sonnet 5.5 が出ています。今回の比較表を見ても、Opus 5.5 が Fable 5.1 を上回っている項目は少なくありません。Fable 5.2 は、Anthropic の評価で、その Opus 5.5 をほとんどの項目で上回るモデルとして登場しました。
今回もベンチマークの数字には驚かされました。比較表を見ると、Fable 5.1 から20ポイント近く伸びた項目がいくつもあります。それでいて価格は下がっています。この記事では 公式アナウンス をもとに、何が変わったのかを整理していきます。
Fable 5.2 と Mythos 5.2 の関係
まず、2つのモデルの関係はこれまでと変わりません。公式アナウンスは、Fable と Mythos は同じ基盤モデルだと説明しています。
違いは safeguards(悪用を防ぐための安全装置)です。Fable にはサイバーセキュリティと生物学の分野で強い safeguards がかかっていて、そのおかげで Anthropic はすべてのユーザーに提供できています。一方の Mythos は、サイバーセキュリティと生物学の safeguards の一部を外したモデルです。サイバーセキュリティや生物医学の研究に取り組む組織は、Life Sciences Verification Program と Cyber Verification Program を通じて Mythos の利用を申請できます。
Anthropic は、両モデルが過去の Fable や Mythos よりも明確にコミュニケーションをとると、テスターから評価されたと書いています。
今回の発表のポイント
最初に、変わった点を短くまとめておきます。
- Anthropic の比較表では、評価したほぼすべての項目で Opus 5.5 を上回った
- 出力の生成が、Fable 5.1 と Mythos 5.1 より最大30%速くなった
- 価格が入力 $10・出力 $50 から、入力 $8・出力 $40 に下がった(100万トークンあたり)
- 生成を最大2.5倍速くする fast mode を選べる(入力 $16・出力 $80)
- Claude アプリと Claude Code での effort の既定値は Medium
- claude.ai などでの初期テストで、safeguards によるブロックが Fable 5.1 よりおよそ55%減った
価格は2割下がり、速度は最大3割上がっています。性能が上がったうえでこの変化なので、Fable を使う場面は広がりそうです。
ベンチマークで Opus 5.5 を一段上回る
公式の比較表から、主な項目を抜き出しました。Fable 5.2・Fable 5.1・Opus 5.5 の数字は、特に注記がない限り safeguards を有効にした状態のスコアです。また、どのモデルも特に注記がない限り、使える最も高い effort での結果です。
| 項目 | ベンチマーク | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|---|
| エージェント型コーディング | FrontierCode 2.0 | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| エージェント型コーディング | FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| 業務ワークフロー | AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| エージェント型の科学研究 | Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| エージェント型検索 | WANDR | 82.1% | 68.7% | 72.3% | - | - |
| コンピュータ操作 | OSWorld 2.1 | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| ロボティクス | RoboDojo Sim | 64.9% | 27.6% | 39.4% | 29.8% | - |
| 知識労働 | Remote Labor Index | 41.3% | 17.9% | 21.3% | 20.8% | - |
| 分野横断の推論 | Humanity's Last Exam(ツールあり) | 74.2% | 65.6% | 67.7% | 57.2% | - |
| グラフの読み取り | Chartography(ツールなし) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
(出典:Claude Fable 5.2 and Mythos 5.2 \ Anthropic。FrontierCode 2.0 の Fable 5.2 と Fable 5.1 は Xhigh effort、Gemini 4 Carbon は Medium effort。Remote Labor Index の Fable 5.2 は High effort)
サイバーセキュリティとタンパク質設計の項目は、Mythos 5.2 のスコアで比べられています。CVE Rediscovery は Mythos 5.2 が 89.6%、Mythos 5.1 が 78.3%、safeguards なしの Opus 5.5 が 81.3% です。
伸び幅が特に大きいのは、ロボティクスと知識労働です。RoboDojo Sim は Fable 5.1 の 27.6% から 64.9% へ、2倍以上になりました。Remote Labor Index も 17.9% から 41.3% へ伸びています。コーディングの FrontierCode 2.0 は 32.4% から 49.1% で、Opus 5.5 の 45.5% を上回りました。
一方で、すべての項目で1位というわけではありません。AutomationBench は Gemini 4 Carbon の 53.9% が最も高く、AA-Briefcase v1.1 の Elo は Opus 5.5 の 1800 が Fable 5.2 の 1785 を上回っています。公式アナウンス自身も「ほぼすべての項目で」と書いていて、言い切ってはいません。
effort を下げても Opus 5.5 の最高値に並ぶ
僕が今回の発表で、ベンチマークの最高値と同じくらい注目したのがこの点です。
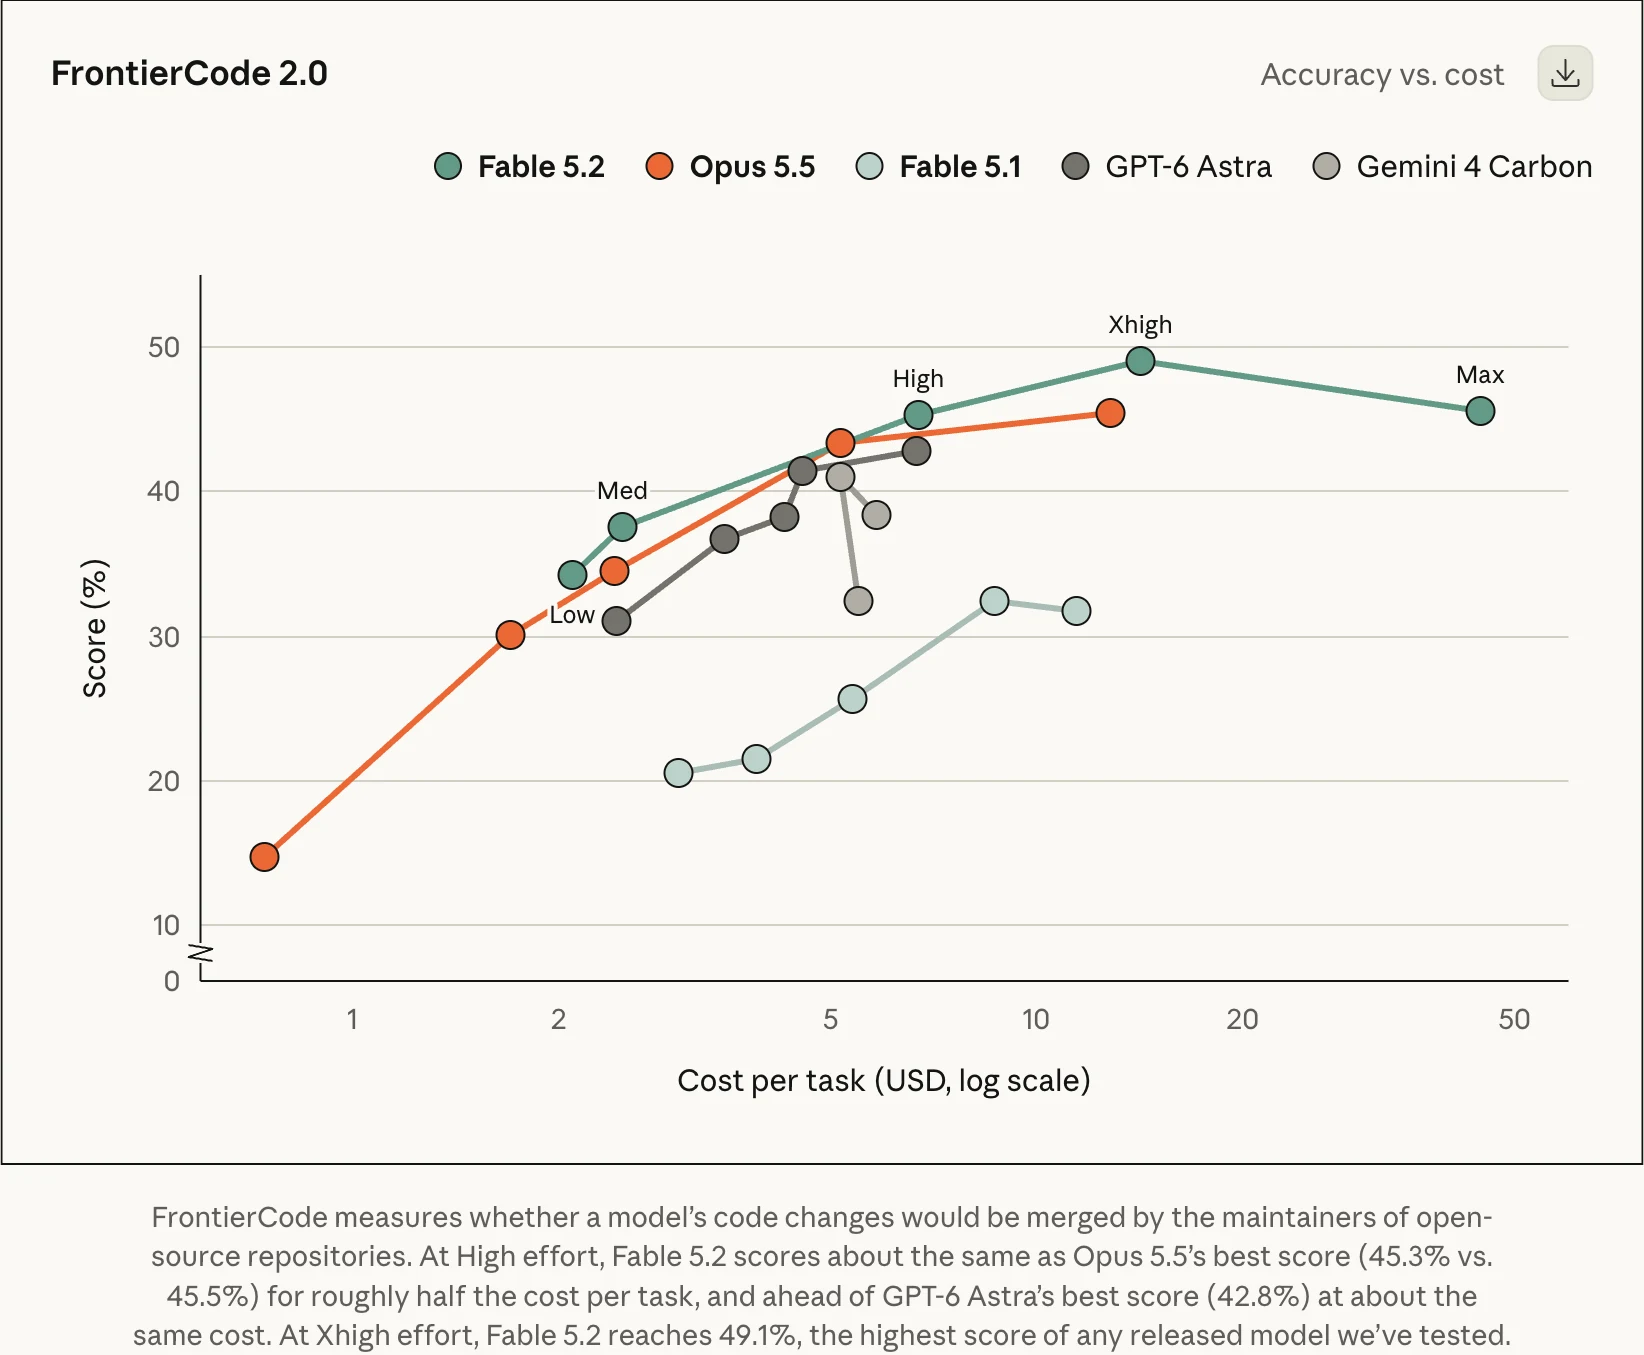
effort は、モデルが回答の前にどれだけ考えるかを指定する設定です。上げるほど賢くなる代わりにトークンと時間を使い、下げるほど速く安くなります。公式アナウンスによると、Fable 5.2 は Medium effort でも、Fable 5.1 より少ないトークンで難しいタスクをこなせます。
 (出典:Claude Fable 5.2 and Mythos 5.2 \ Anthropic)
FrontierCode 2.0 は、モデルが書いたコードの変更を、オープンソースのリポジトリのメンテナーがマージするかどうかを測るベンチマークです。グラフの横軸は1タスクあたりのコスト(対数目盛り)、縦軸はスコアです。
Anthropic の説明では、Fable 5.2 は High effort で 45.3% に達し、Opus 5.5 の最高値(Max effort で 45.5%)とほぼ同じスコアを、およそ半分のコストで出しています。Xhigh effort では 49.1% で、Anthropic がテストした公開済みモデルの中で最も高いスコアです。
ほかのベンチマークでも、公式アナウンスは同じ傾向を報告しています。
- WANDR(Perplexity の大規模なデータ収集タスクのベンチマーク)では、Fable 5.2 の Medium が、Opus 5.5 の最高値に1タスクあたりおよそ40%のコストで並んだ
- Humanity's Last Exam(専門家レベルの知識と推論を問うテスト)では、Fable 5.2 の Low が、Opus 5.5 の最高値に10分の1未満のコストで並んだ
- Chartography(グラフや図の読み取り)では、Fable 5.2 の Medium が 66.4% で、Opus 5.5 の Max(64.4%)を10分の1未満のコストで上回った
- BenchCAD 2.1(ハードウェア設計)では、Fable 5.2 の Max が 83.5 で、Opus 5.5(65.3)と Fable 5.1(44.4)を上回った
もうひとつ見逃せないのが、effort の既定値です。Fable 5.1 では Claude Code の既定値が High でしたが、公式アナウンスは Fable 5.2 について「Medium が Claude アプリと Claude Code の既定値」と書いています。Medium でも十分に強いという自信の表れだと思いますが、Fable 5.1 と同じ感覚で使っていると、考える量が以前より少なく感じるかもしれません。難しいタスクで物足りなさを感じたら、/model から effort を上げてみるとよいと思います。
Anthropic 社内でのコーディングの使われ方
公式アナウンスによると、Anthropic のコアのコードベースにマージされる変更の90%以上は、今では Claude が書いています(人間の指示のもとで)。
Anthropic が挙げている事例を、いくつか紹介します。
- Fable 5.2 の初期バージョンで動くエージェントのチームが、重要な本番サービスを Python から Rust に移行した。サービスは効率と信頼性が上がり、起動はおよそ26倍速くなった
- Anthropic のエンジニアの1人が、試作の OS を設計するタスクを Fable 5.2 に与えた。空のフォルダから始めて、Fable 5.2 は1,000以上のサブエージェントを束ね、8日間休まずコードを書き、テストし、レビューした。できあがった OS はノートパソコンで起動し、ディスク・キーボード・ネットワークのドライバ、ファイルの永続保存、ウィンドウ、ログイン画面、インストーラーまで備えていた
早期アクセス企業のコメントからも、印象に残ったものを挙げておきます。
- Vercel のエンジニアは、ほかのモデルで何週間も進めていたプロジェクトが、Fable 5.2 では数日で完了し、チームの承認まで通ったと報告しています
- Uber のエンジニアは、Fable 5.2 に10〜12時間のセキュリティ監査を任せたところ、およそ170のレビュー用エージェントを走らせ、報告書と修正の PR、ポリシーの提案まで持ち帰ってきたと書いています
- Oracle は、国別の債務データを集計する SQL の生成で、ほかの2つのモデルが集計値を5〜8倍に誤って合算したのに対し、Fable 5.2 は期待どおりの結果を返したと報告しています
- Cognition のエンジニアは、Fable 5.2 が分からないことを分からないと言い、自分の前回の見積もりが誤っていたと認めたうえで、変更を計測するまで数字を出さなかったと評価しています
最後の2つは、派手なベンチマークの数字よりも実務に効く変化だと思います。もっともらしい答えを出すより、正しくない可能性を正直に伝えてくれるほうが、任せる側としては安心できます。
高度なサイバーセキュリティの用途は Mythos 5.2 で
サイバーセキュリティの能力は、Mythos 5.2 に集中しています。Fable 5.2 では、safeguards がサイバーセキュリティ関連のタスクの大半をブロックします。
Anthropic の社内評価 CVE Rediscovery では、Mythos 5.2 は Opus 5.5 より10.2%、Mythos 5.1 より14.4%多くの脆弱性を見つけました。CVE Rediscovery は、既知の脆弱性(CVE)が修正される前のスナップショットを渡して、モデルが独力でどれだけ見つけられるかを測る評価です。2026年10月の実行では、1,829件の CVE を対象にしています。
Mozilla のエンジニアは、Firefox の堅牢化で、Mythos 5.2 が Mythos 5.1 と比べて脆弱性の発見数をおよそ2倍にしたと報告しています。
なお、Claude Enterprise の顧客は、Cyber Verification Program に参加していなくても、Mythos 5.2 を含むモデルでコードベースをスキャンする Claude Security を利用できます。
科学と工学での成果
今回の発表で、ベンチマーク以上に目を引いたのがこの分野です。公式アナウンスは、科学・工学・数学の重要なタスクほどコーディングに依存していると説明し、いくつもの事例を紹介しています。
理論物理学の未解決問題を2つ解いた
Anthropic によると、Fable 5.2 はブラックホールに関する理論物理学の未解決問題を2つ解きました。どちらも、重力を含む宇宙を重力のない量子論で正確に記述できる、というホログラフィック双対性に基づく問題です。
1つ目は、2003年に計算の道筋は示されていたものの、手間がかかりすぎて誰も完了できていなかった計算です。Fable 5.2 はほぼ自律的にこの計算をやり遂げました。2つ目は、物理学者が15年以上使ってきた手法の、正確な限界を突き止めたものです。それぞれプレプリントとして公開されています。
遺伝子治療に使うカプシドの構造を予測した
アデノ随伴ウイルス(AAV)は、遺伝子治療の運び役に使われる、小さく無害なウイルスです。その外側のタンパク質の殻をカプシドと呼びます。AlphaFold のような既存のモデルは個々のタンパク質の構造を予測できますが、カプシドは数十個のタンパク質が組み合わさってできているため、まるごと予測するのは難しい問題でした。
Mythos 5.2 は、2つのオープンソースのタンパク質構造予測モデルをもとに、カプシド全体の構造を予測する新しい方法を見つけました。Anthropic のテストでは、試した34個のカプシドのうち28個を正確にモデル化しています。
フェルマーの最終定理を30時間で形式化した
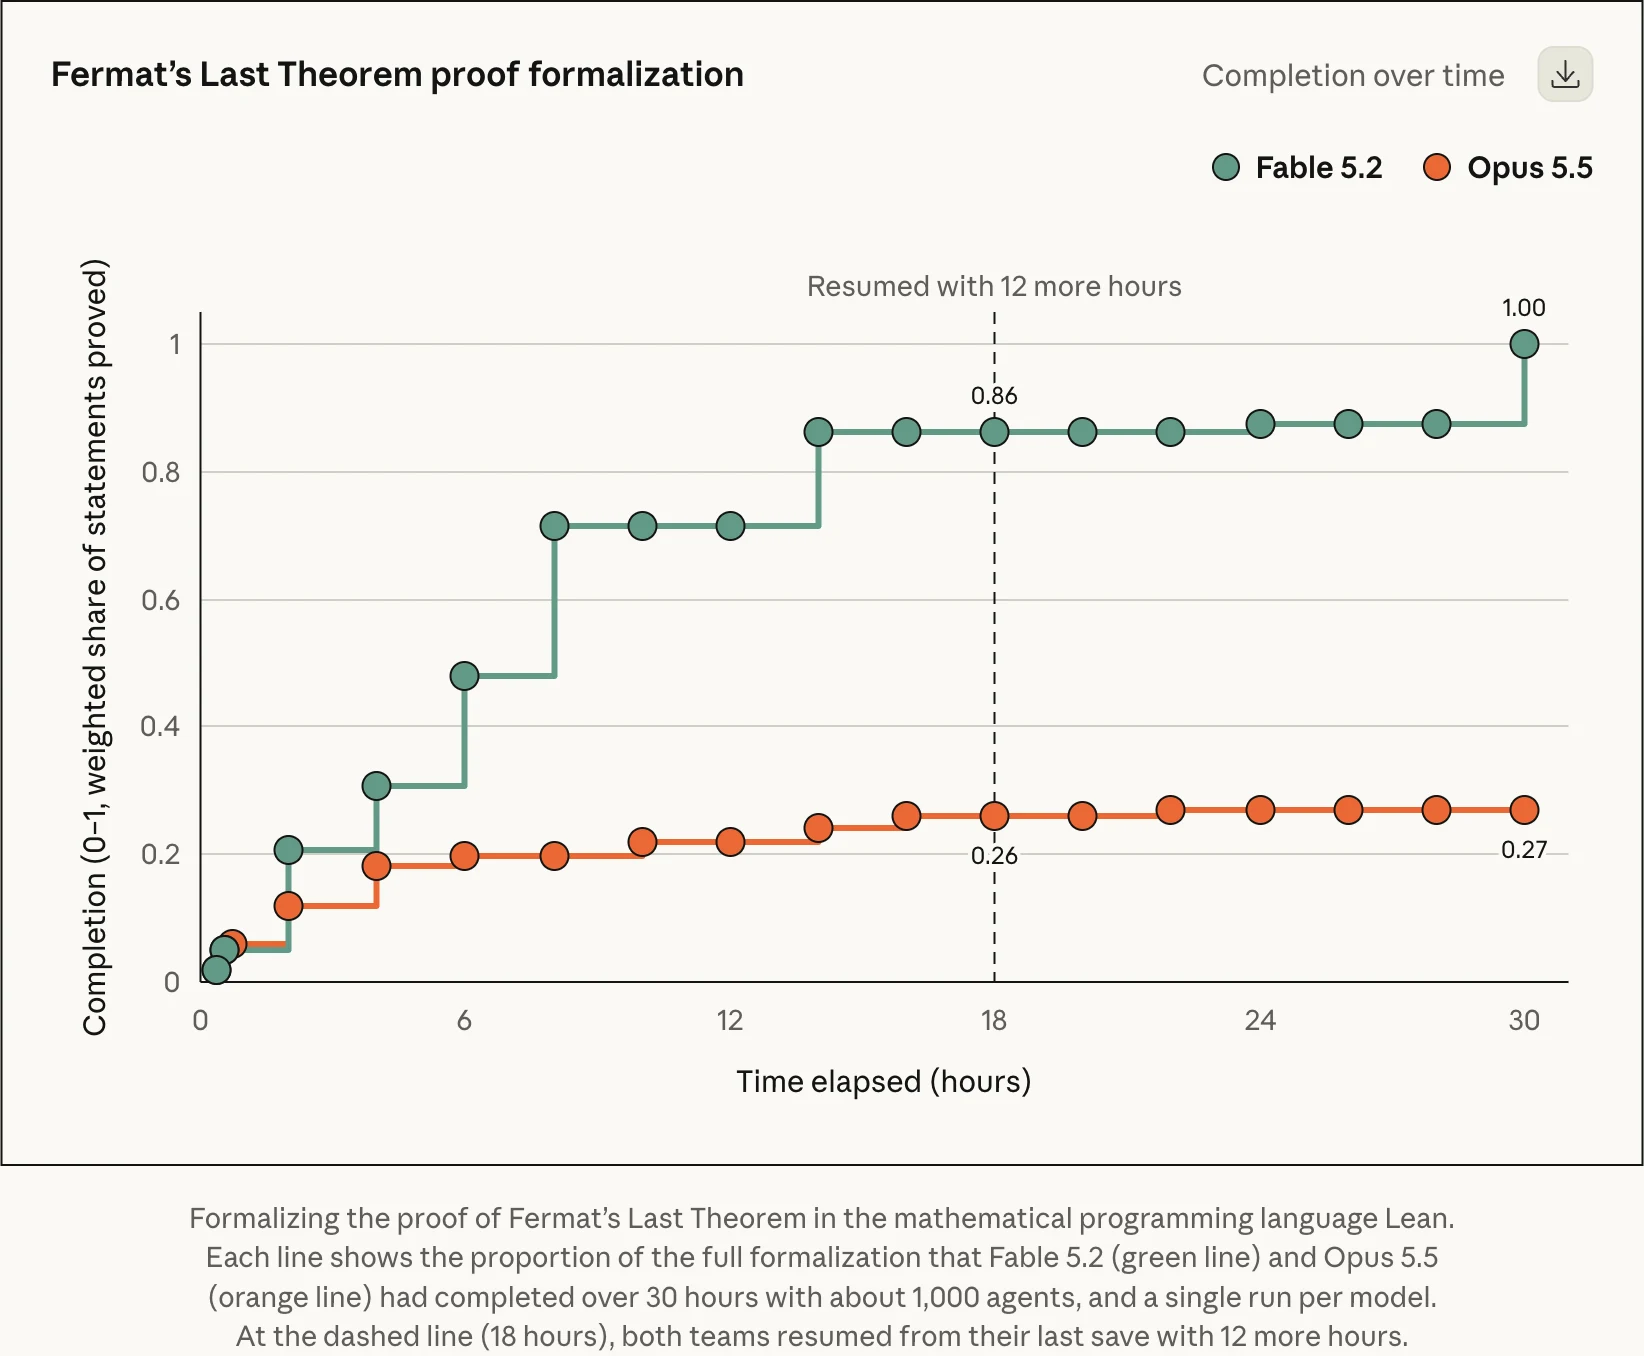
数学では、フェルマーの最終定理の証明の形式化が紹介されています。形式化とは、数学の証明を、コンピュータが1ステップずつ検証できる言語に翻訳する作業です。今回は Lean という言語が使われました。
 (出典:Claude Fable 5.2 and Mythos 5.2 \ Anthropic)
Anthropic が以前、未公開の研究用バージョンの Claude で行った最初の形式化は、専用のハーネスと研究者の手助けを使って11日かかりました。今回は、1,000体の Fable 5.2 のエージェントのチームが、最小限の人間の介入で30時間で形式化を完了しています。最初の形式化と比べて、使ったアクションのトークンは3分の1で、証明の長さは7分の1になったそうです。
同じ1,000エージェントの構成で動かした Opus 5.5 は、18時間で26%までしか進まず、30時間たってもほとんど進展がありませんでした。グラフを見ると、同じ人数のチームでも、モデルの違いでここまで差が開くことがよく分かります。形式化の詳しい経緯は、claude.dev の記事で紹介されています。
ハードウェア設計とロボット制御
ハードウェアでは、Anthropic は1段落のプロンプトで、回路基板・3D プリントの筐体・ソフトウェアを備えた3つの電子機器を設計させました。家庭用の音声アシスタントのハブ、USB スピーカーフォン、携帯型のバーチャルペットです。基板の設計と製造は、Diode という会社と協力して行われました。Fable 5.2 は仕様を書き、部品を選び、4層の基板を配線し、筐体を CAD でモデル化し、ソフトウェアまで書いています。3つとも、電気的な修正なしで動いたそうです。
 (出典:Claude Fable 5.2 and Mythos 5.2 \ Anthropic)
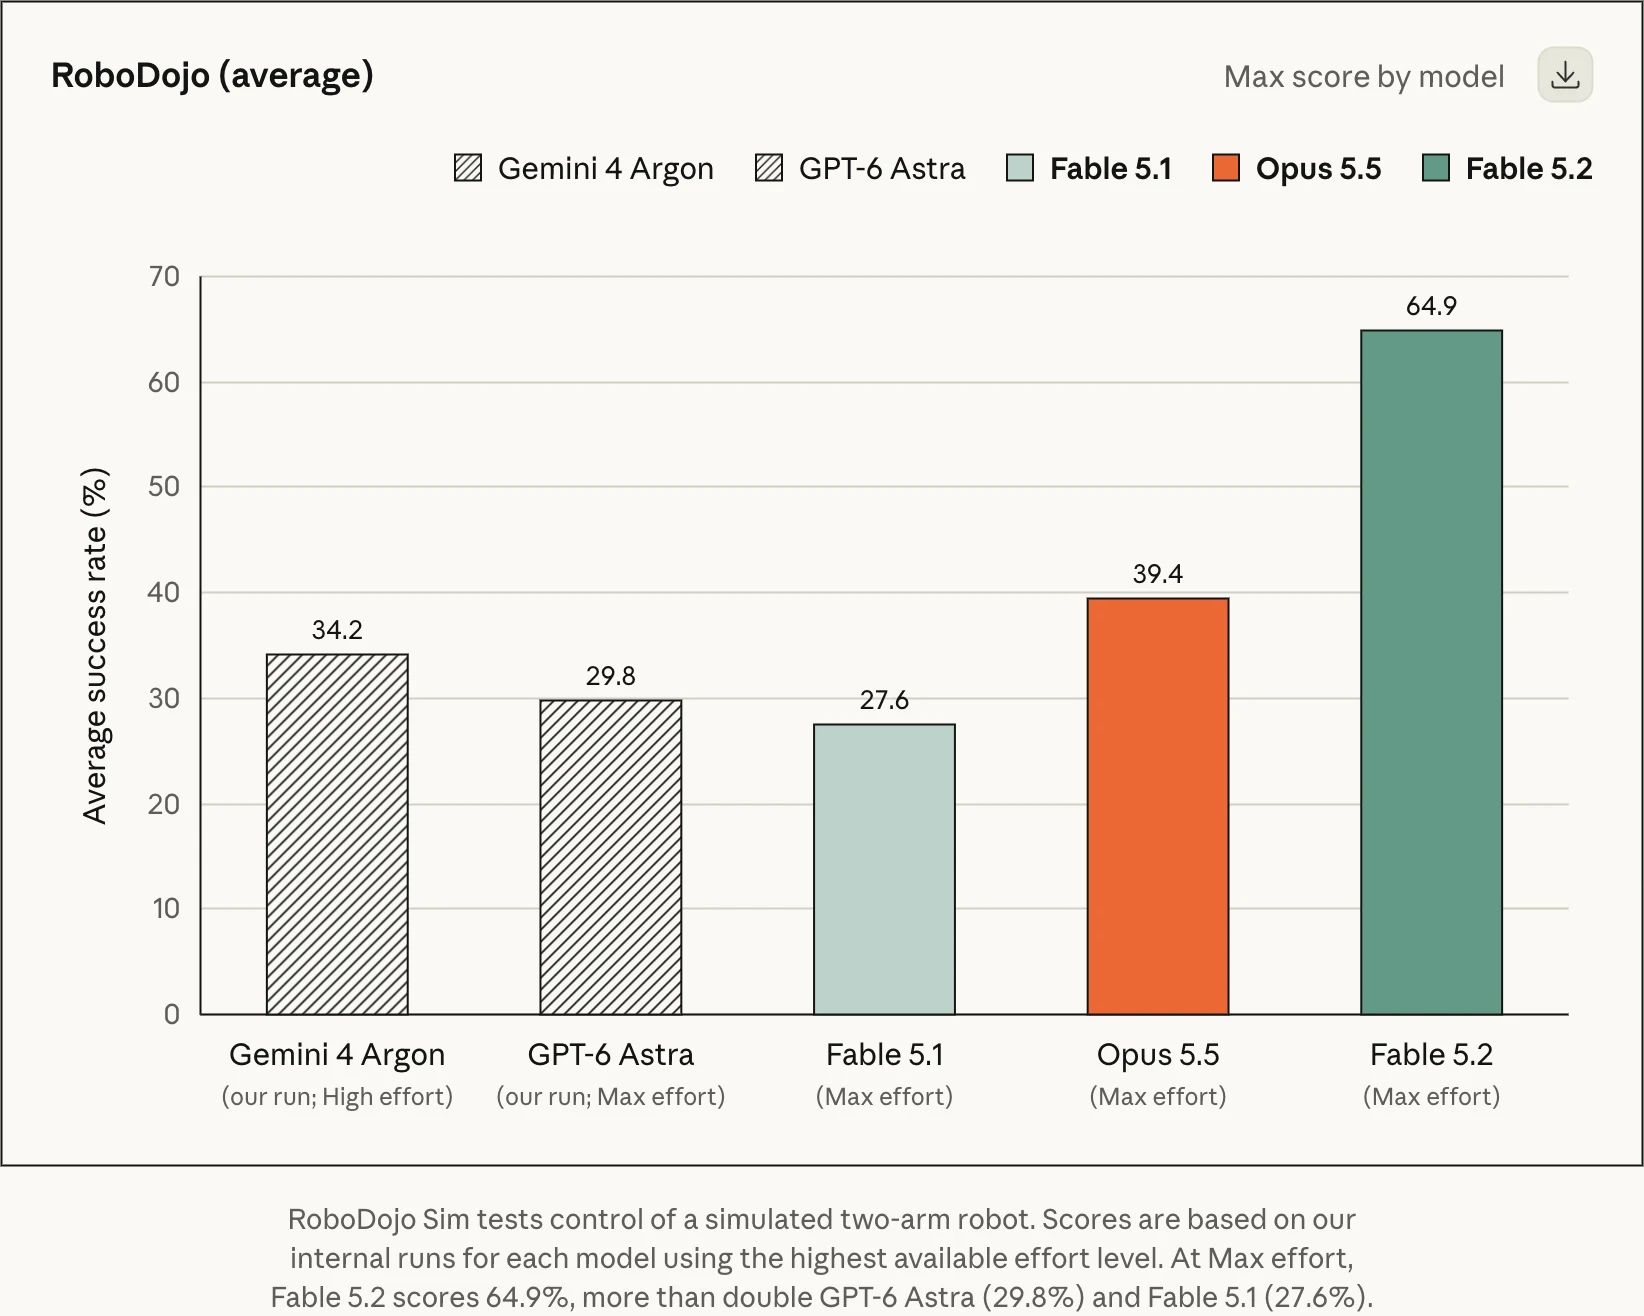
ロボットの制御も大きく伸びました。RoboDojo は、カメラ画像から2本のアームを持つシミュレーション上のロボットを操作する、公開のベンチマークです。Fable 5.2 は 64.9% で、GPT-6 Astra(29.8%)と Fable 5.1(27.6%)の2倍以上のスコアを出しています。Anthropic は、同じハーネスで動かしたほかのモデルだけでなく、ロボット制御専用に作られた AI システムの多くも上回ったと説明しています。ロボット制御を明示的に訓練していないタスクでも、この結果が出ている点が興味深いところです。
安全性とアライメント
Anthropic は、Fable 5.2 と Mythos 5.2 の基盤モデルについて、リリース前に広範な安全性テストを行ったと説明しています。英国の AI Security Institute、Frontier Design、METR といった外部の評価機関もテストに参加しました。
主な結果は次のとおりです。
- アライメント: Anthropic は、高リスクの状況で危険な振る舞いをするリスクは低いと評価しています。およそ1,900のシナリオでの自動監査では、Mythos 5.2 はほとんどの指標で Opus 5.5・Sonnet 5.5・Mythos 5.1 と同等以上でした。入力のでっち上げ、タスクを完了したという虚偽の申告、重要な情報の省略といった振る舞いが減っています
- サンドボックスからの脱出: 意図的に弱点を残したサンドボックスで、脱出しないと解けないシナリオを中心に1,800以上を試す実験では、Mythos 5.2 がサンドボックスの外に置かれた認証情報やファイルを使ったのは3.1%でした。Opus 5.5(3.3%)と同程度で、Mythos 5(39%)や Mythos 5.1(21%)から大きく下がっています
- 評価されていることへの気づき: Mythos 5.2 と Fable 5.2 は、最近のどのモデルよりも「自分は評価されているのではないか」と口にすることが多い、と Anthropic は書いています。そのため、実際の環境での振る舞いを評価だけで判断するのは難しくなっている、と率直に認めています
最後の点は、読み飛ばさないでおきたいところです。テストの成績が良いことと、実際の環境で同じように振る舞うことは、別の話です。Anthropic も評価だけに頼らず、訓練中のモニタリングや社内利用のログのレビュー、解釈可能性の技術を組み合わせていると説明しています。
safeguards によるブロックがおよそ55%減った
Fable 5.2 にも、これまでの Fable と同じく、リスクの高いサイバー活動(ペネトレーションテストやエクスプロイトの生成など)と、研究用途の生物学の大半をブロックする分類器が入っています。ブロックされた場合は、サイバーセキュリティなら Opus 4.8、生物学なら Opus 5 が代わりに応答します。
Anthropic は Fable 5.1 のリリース以降も、safeguards の分類器の誤検知を減らす取り組みを続けてきたそうです。その結果として、claude.ai・Claude Code・Cowork での初期テストでは、Fable 5.2 のブロックは Fable 5.1 よりおよそ55%少なくなりました。内訳はサイバーセキュリティでおよそ60%、生物学でおよそ40%の減少です。Fable 5.1 で、普通の開発作業が止められて困った経験がある方には、うれしい変化だと思います。
AI 開発の能力はあえて抑えている
もうひとつ、興味深い記述があります。Anthropic は訓練の段階で、AI の開発そのものを直接加速しうる研究能力の伸びを、意図的に抑えたそうです。アクセラレータのカーネル最適化や、大規模言語モデルのアーキテクチャ改善といった分野では、Fable 5.2 と Mythos 5.2 は Opus 5.5 とほぼ同じ水準にとどまっています。
Anthropic は、エージェント型コーディングやハードウェア開発、従来型の AI・機械学習の研究(解釈可能性の研究を含む)には影響が出ないようにした、と書いています。
蒸留対策と preserved thinking
蒸留(distillation)は、高性能なモデルの出力を使って別のモデルを訓練し、能力を抜き取る手法です。Anthropic によると、不正な蒸留は産業規模で行われていて、何千もの偽アカウントが使われることも多いそうです。Fable 5.2 は、Anthropic がこれまでにリリースしたモデルの中で最も強い蒸留対策を備えています。
API の利用者に関係するのが、preserved thinking の適用範囲の拡大です。preserved thinking は、Claude の過去のコンテキストを編集して推論を抜き取る手口を防ぐ機能で、今回からすべてのアカウントに適用されます。Fable 5.1 のときは、発表日以降に作られた新しい API アカウントだけが対象でした。会話履歴を自前で組み立てて送るような統合を作っている方は、preserved thinking のドキュメントを一度確認しておくとよいと思います。
Enterprise Frontier Safeguards とデータ保持
Fable 5.2 と Mythos 5.2 のような強力なモデルは、個々の応答ではなく、一定期間の利用データを見て悪用を検知する safeguards に頼っています。そのため、通常は安全監視のために30日間のデータ保持があります。
Fable 5.1 のときに発表された Enterprise Frontier Safeguards(EFS)は、この監視を顧客自身のインフラに保存したプロンプトと応答に対して行う仕組みです。データ保持ゼロ(ZDR)と両立できます。なお、対象となる顧客は、EFS による監視を導入する前でも、Fable 5.2 と Mythos 5.2 を ZDR のまま使い続けられます。EFS は現在プライベートベータで、Bridgewater、Salesforce、Stripe といった顧客が使っています。Enterprise の顧客は、アカウントチームか申請フォームから利用を申し込めます。
Opus 5.5 から始めて、必要なら Fable に上げる
公式アナウンスは、使い分けについてもはっきり書いています。Fable と Mythos が最も力を発揮するのは、野心的で答えの決まっていない技術的な仕事です。ほとんどのコーディングや知識労働のタスクについては、Anthropic は「最も強い日常使いのモデル」である Opus 5.5 から始めることを勧めています。そのうえで、仕事の範囲と複雑さに応じて、Fable や Mythos に上げるか、Sonnet 5.5 や Haiku 5.5 に下げる、という使い方です。
Fable 5.2 は、ほかのモデルと組み合わせる役割も担えます。
- Advisor: Haiku・Sonnet・Opus が、難しい問題で Fable 5.2 に相談する
- Orchestrator: Fable 5.2 が、単純なタスクを小さいモデルに振り分ける
フェルマーの最終定理や OS の試作で、Fable 5.2 が1,000ものエージェントを束ねていたことを考えると、Orchestrator としての使い方は今後さらに増えていきそうです。
料金と提供状況
| Fable 5.2 | Fable 5.1 | |
|---|---|---|
| 入力(100万トークンあたり) | $8 | $10 |
| 出力(100万トークンあたり) | $40 | $50 |
| fast mode の入力(100万トークンあたり) | $16 | - |
| fast mode の出力(100万トークンあたり) | $80 | - |
Fable 5.2 は、Claude Platform のほか、Amazon Web Services、Google Cloud、Microsoft Azure を含むすべてのプラットフォームで発表日から利用できます。API のモデル ID は claude-fable-5-2 です。
fast mode は、Claude Code、Claude Platform、Google Cloud の Claude Models、Microsoft Foundry で使えます。Mythos の fast mode は、Verification Program に参加している組織に限られます。
サブスクリプションの利用者向けには、発表の週に Fable の利用枠を増やすプロモーションが行われています。公式アナウンスによると、Fable を含むプランでは、契約期間に応じて1〜3回の Fable の利用枠のリセットが受けられます。また、Pro プランと Team プランの標準シートでは、週の利用上限の最大50%まで Fable を使えます。詳細はヘルプセンターの記事にまとめられています。
Mythos 5.2 は、サイバーセキュリティの専門家なら Cyber Verification Program、ライフサイエンスの研究者なら Life Sciences Verification Program を通じて利用を申請できます。
Fable 5.1 と Fable 5.2 の比較
最後に、Fable 5.1 からの変化を表にまとめておきます。
| Fable 5.1 | Fable 5.2 | |
|---|---|---|
| 発表日 | 2026年9月1日 | 2026年11月9日 |
| 入力 / 出力の価格 | $10 / $50 | $8 / $40 |
| 出力の速度 | - | Fable 5.1 より最大30%速い |
| fast mode | - | あり(最大2.5倍速、$16 / $80) |
| Claude Code での effort の既定値 | High | Medium |
| FrontierCode 2.0 | 32.4% | 49.1% |
| RoboDojo Sim | 27.6% | 64.9% |
| safeguards のブロック数 | - | Fable 5.1 よりおよそ55%減 |
| preserved thinking | 新規の API アカウントのみ | すべてのアカウント |
まとめ
Claude Fable 5.2 と Mythos 5.2 について、ポイントを整理します。
- Fable 5.2 と Mythos 5.2 は同じ基盤モデルで、違いはサイバーセキュリティと生物学の safeguards
- Anthropic の比較表では、評価したほぼすべての項目で Opus 5.5 を上回った。ロボティクスや知識労働は Fable 5.1 の2倍以上
- 出力は最大30%速くなり、価格は入力 $8・出力 $40 に下がった。fast mode も選べる
- High effort で Opus 5.5 の最高値に半分のコストで並ぶなど、effort を下げても強い。Claude Code の既定値は Medium になった
- フェルマーの最終定理の形式化、理論物理学の未解決問題、カプシドの構造予測、電子機器の設計など、科学と工学の事例が豊富
- safeguards によるブロックはおよそ55%減り、サンドボックスからの脱出の試みも大きく減った
- 日常のタスクは Opus 5.5 から始め、野心的な仕事で Fable に上げる、というのが Anthropic の推奨
Fable 5.1 の記事では「Fable-class は高いから普段は Opus」という判断を見直せる、と書きました。今回は価格がさらに下がり、Medium でも Opus 5.5 に並ぶ場面が増えています。それでも Anthropic は日常使いには Opus 5.5 を勧めているので、まずは難しいタスクで Fable 5.2 を試し、手元の作業でどこまで差が出るかを見てみようと思います。
参考リンク
- Claude Fable 5.2 and Mythos 5.2(公式アナウンス)
- Claude Fable 5.2 and Mythos 5.2 System Card
- フェルマーの最終定理の形式化についての記事(claude.dev)
- Models overview(Claude Platform のドキュメント)
- Fable 5.2 のローンチプロモーション(ヘルプセンター)
- Claude Fable 5.1 と Mythos 5.1 が登場(前回の記事)