Claude Fable 5.2와 Mythos 5.2가 등장. 거의 모든 항목에서 Opus 5.5를 상회하며, 가격은 20% 낮아졌다.
목차
안녕하세요. 2026년 11월 9일(미국 시간), Anthropic에서 'Claude Fable 5.2'와 'Claude Mythos 5.2'를 발표했습니다.
지난 9월 Fable 5.1 이후 불과 2개월여 만의 업데이트입니다. 그사이 Opus 5.5와 Sonnet 5.5가 출시되었습니다. 이번 비교표를 보더라도 Opus 5.5가 Fable 5.1을 앞서는 항목이 적지 않습니다. Fable 5.2는 Anthropic의 자체 평가에서 그러한 Opus 5.5를 거의 전 항목에서 능가하는 모델로 등장했습니다.
이번에도 벤치마크 수치에 놀라움을 감출 수 없었습니다. 비교표를 보면 Fable 5.1 대비 20포인트 가까이 상승한 항목도 다수 있습니다. 그러면서도 가격은 더 인하되었습니다. 이번 글에서는 공식 발표를 바탕으로 어떤 점이 달라졌는지 정리해 보겠습니다.
Fable 5.2와 Mythos 5.2의 관계
우선 두 모델의 관계는 이전과 동일합니다. 공식 발표에 따르면 Fable과 Mythos는 동일한 기반 모델입니다.
차이점은 safeguards(오남용 방지를 위한 안전장치)에 있습니다. Fable에는 사이버 보안과 생물학 분야에서 강력한 safeguards가 적용되어 있어, Anthropic이 모든 사용자에게 제공할 수 있습니다. 반면 Mythos는 사이버 보안 및 생물학 관련 safeguards 중 일부를 해제한 모델입니다. 사이버 보안이나 생물의학 연구를 수행하는 기관은 Life Sciences Verification Program과 Cyber Verification Program을 통해 Mythos 이용을 신청할 수 있습니다.
Anthropic은 테스터들로부터 두 모델 모두 이전 Fable 및 Mythos보다 훨씬 더 명확하게 커뮤니케이션한다는 평가를 받았다고 밝혔습니다.
이번 발표의 핵심 포인트
먼저 변경된 점을 간단히 요약해 드립니다.
- Anthropic의 비교표 기준, 평가된 거의 전 항목에서 Opus 5.5를 능가
- 출력 생성이 Fable 5.1 및 Mythos 5.1보다 최대 30% 빨라짐
- 가격이 입력 $10 / 출력 $50에서 입력 $8 / 출력 $40로 인하(100만 토큰 기준)
- 생성을 최대 2.5배 빠르게 하는 fast mode 선택 가능(입력 $16 / 출력 $80)
- Claude 앱 및 Claude Code에서의 effort 기본값이 Medium으로 설정
- claude.ai 등에서의 초기 테스트 결과, safeguards로 인한 차단이 Fable 5.1 대비 약 55% 감소
가격은 20% 인하되었고, 속도는 최대 30% 향상되었습니다. 성능이 개선된 상태에서 이러한 변화가 이루어진 만큼, Fable을 활용할 수 있는 영역이 더욱 넓어질 것으로 보입니다.
벤치마크에서 Opus 5.5를 한 단계 뛰어넘다
공식 비교표에서 주요 항목을 정리했습니다. 별도 표기가 없는 한 Fable 5.2, Fable 5.1, Opus 5.5의 수치는 safeguards를 활성화한 상태의 점수입니다. 또한 모든 모델은 별도 표기가 없는 한 사용할 수 있는 가장 높은 effort에서의 결과입니다.
| 항목 | 벤치마크 | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|---|
| 에이전트형 코딩 | FrontierCode 2.0 | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| 에이전트형 코딩 | FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| 업무 워크플로 | AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| 에이전트형 과학 연구 | Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| 에이전트형 검색 | WANDR | 82.1% | 68.7% | 72.3% | - | - |
| 컴퓨터 제어 | OSWorld 2.1 | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| 로보틱스 | RoboDojo Sim | 64.9% | 27.6% | 39.4% | 29.8% | - |
| 지식 노동 | Remote Labor Index | 41.3% | 17.9% | 21.3% | 20.8% | - |
| 분야 융합 추론 | Humanity's Last Exam(도구 사용) | 74.2% | 65.6% | 67.7% | 57.2% | - |
| 그래프 분석 | Chartography(도구 미사용) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
(출처: Claude Fable 5.2 and Mythos 5.2 \ Anthropic. FrontierCode 2.0의 Fable 5.2 및 Fable 5.1은 Xhigh effort, Gemini 4 Carbon은 Medium effort. Remote Labor Index의 Fable 5.2는 High effort)
사이버 보안 및 단백질 설계 항목은 Mythos 5.2 점수를 기준으로 비교되었습니다. CVE Rediscovery의 경우 Mythos 5.2가 89.6%, Mythos 5.1이 78.3%, safeguards가 적용되지 않은 Opus 5.5가 81.3%를 기록했습니다.
상승 폭이 특히 두드러진 분야는 로보틱스와 지식 노동입니다. RoboDojo Sim은 Fable 5.1의 27.6%에서 64.9%로 2배 이상 향상되었습니다. Remote Labor Index 역시 17.9%에서 41.3%로 올랐습니다. 코딩 분야의 FrontierCode 2.0은 32.4%에서 49.1%로 상승하여 Opus 5.5의 45.5%를 넘어섰습니다.
반면 모든 항목에서 1위를 차지한 것은 아닙니다. AutomationBench는 Gemini 4 Carbon이 53.9%로 가장 높았으며, AA-Briefcase v1.1의 Elo 레이팅은 Opus 5.5(1800)가 Fable 5.2(1785)보다 높았습니다. 공식 발표에서도 단정 짓지 않고 '거의 전 항목에서'라고 표현하고 있습니다.
effort를 낮춰도 Opus 5.5 최고치에 필적
이번 발표에서 벤치마크 최고 점수만큼이나 주목한 부분이 바로 이 점입니다.
effort는 모델이 답변하기 전에 얼마나 깊이 생각할지를 지정하는 설정입니다. 높일수록 지능이 향상되는 대신 토큰과 시간이 더 소모되며, 낮출수록 빠르고 저렴해집니다. 공식 발표에 따르면 Fable 5.2는 Medium effort에서도 Fable 5.1보다 적은 토큰으로 복잡한 작업을 처리할 수 있습니다.
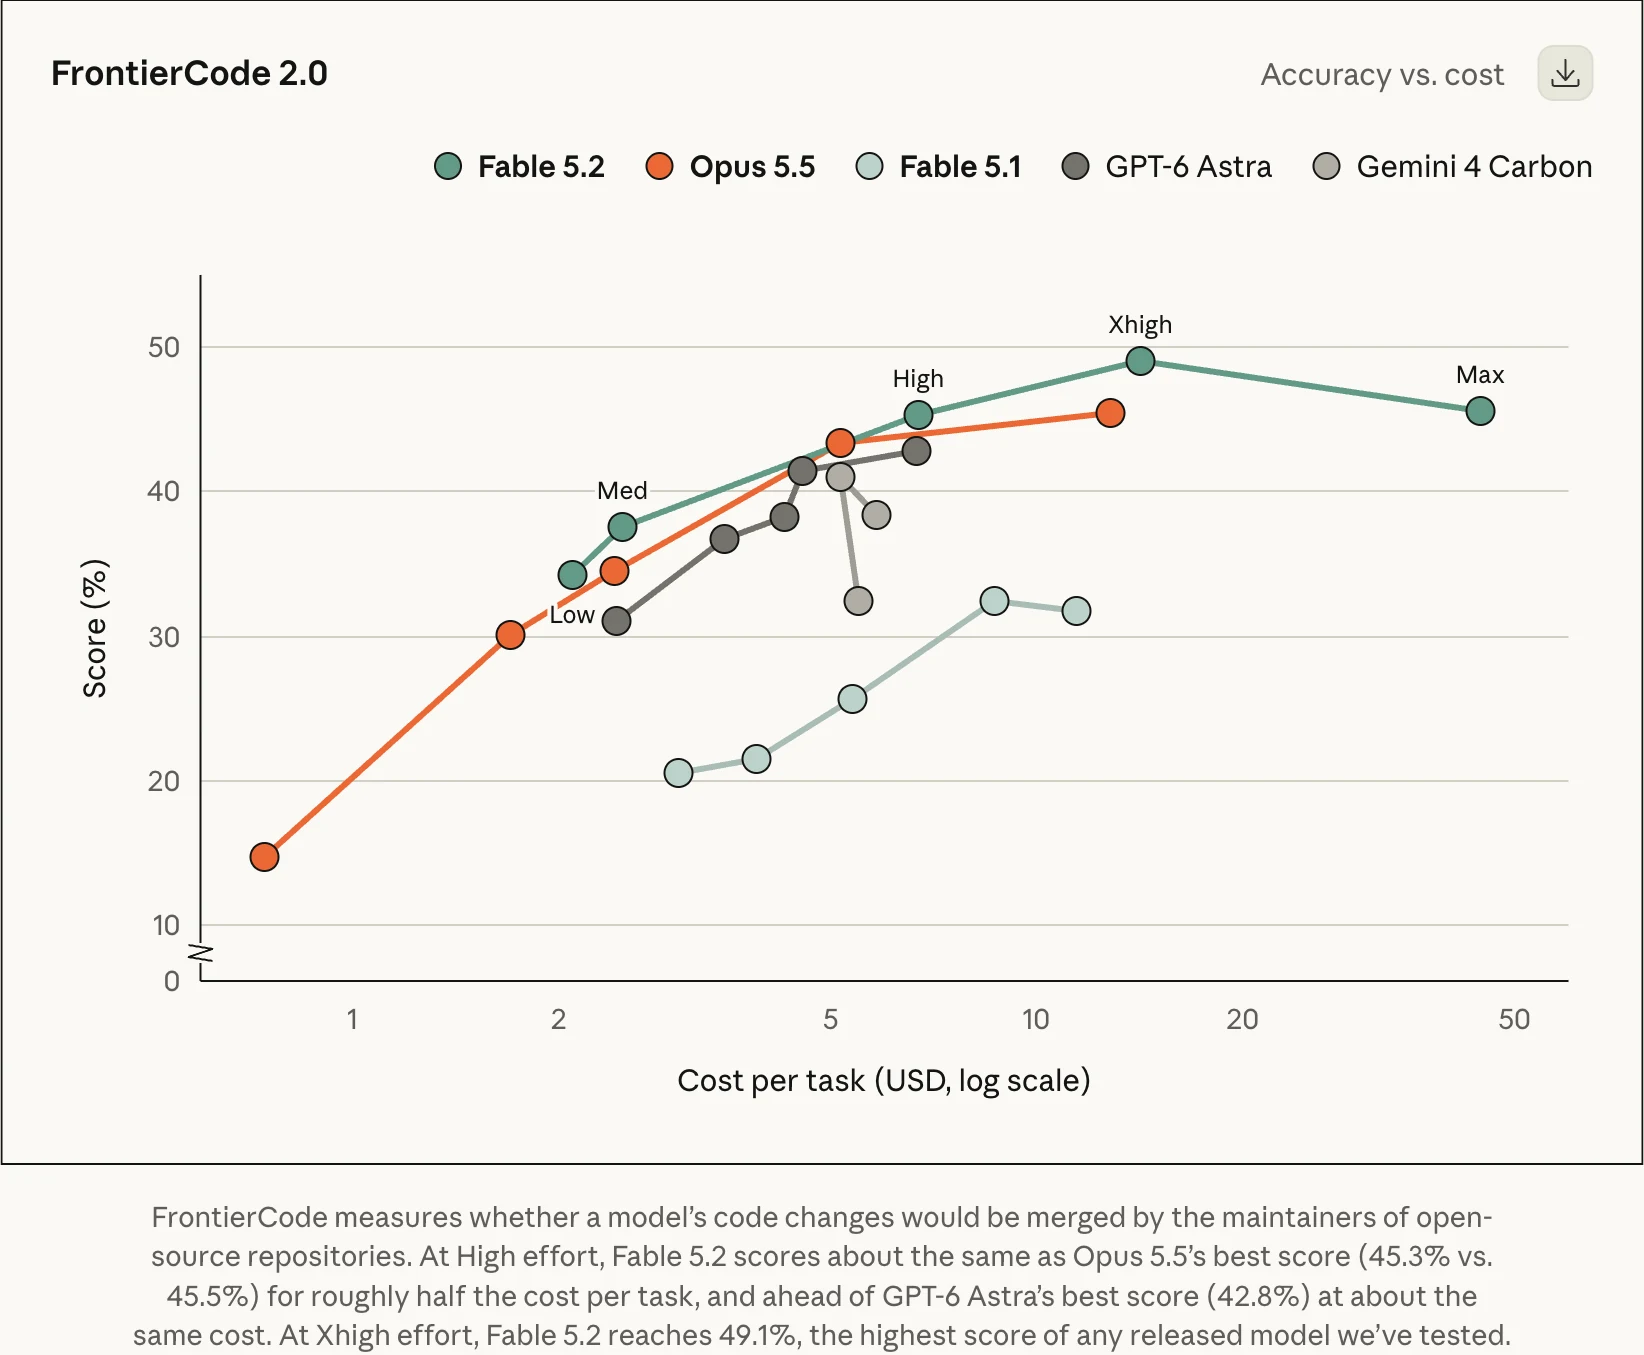 (출처: Claude Fable 5.2 and Mythos 5.2 \ Anthropic)
FrontierCode 2.0은 모델이 작성한 코드 변경 사항을 오픈소스 리포지토리 메인테이너가 병합(merge)할지 여부를 측정하는 벤치마크입니다. 그래프의 가로축은 작업당 비용(로그 스케일), 세로축은 점수입니다.
Anthropic의 설명에 따르면 Fable 5.2는 High effort에서 45.3%를 기록하며, Opus 5.5의 최고점(Max effort에서 45.5%)과 거의 대등한 점수를 약 절반의 비용으로 달성했습니다. Xhigh effort에서는 49.1%를 기록해 Anthropic이 테스트한 공개 모델 중 가장 높은 점수를 보였습니다.
다른 벤치마크에서도 공식 발표는 동일한 경향을 보고하고 있습니다.
- WANDR(Perplexity의 대규모 데이터 수집 작업 벤치마크): Fable 5.2의 Medium이 Opus 5.5 최고치와 대등한 수준을 작업당 약 40%의 비용으로 달성
- Humanity's Last Exam(전문가 수준의 지식과 추론을 평가하는 테스트): Fable 5.2의 Low가 Opus 5.5 최고치와 대등한 수준을 10분의 1 미만의 비용으로 달성
- Chartography(그래프 및 도표 해석): Fable 5.2의 Medium이 66.4%를 기록해 Opus 5.5의 Max(64.4%)를 10분의 1 미만의 비용으로 능가
- BenchCAD 2.1(하드웨어 설계): Fable 5.2의 Max가 83.5를 기록해 Opus 5.5(65.3) 및 Fable 5.1(44.4)을 능가
또 하나 주목할 점은 effort의 기본값입니다. Fable 5.1에서는 Claude Code의 기본값이 High였으나, 공식 발표에서는 Fable 5.2에 대해 'Medium이 Claude 앱 및 Claude Code의 기본값'이라고 명시하고 있습니다. Medium만으로도 충분히 강력하다는 자신감의 방증이겠지만, Fable 5.1과 같은 느낌으로 사용하다 보면 생각하는 깊이가 이전보다 덜하다고 느낄 수도 있습니다. 까다로운 작업에서 아쉬움이 느껴진다면 /model 명령어를 통해 effort를 올려보는 것을 권장합니다.
Anthropic 사내 코딩 활용 사례
공식 발표에 따르면 Anthropic 핵심 코드베이스에 병합되는 변경 사항의 90% 이상을 현재 Claude가 작성하고 있다고 합니다(인간의 지시 감독 하에).
Anthropic이 공개한 몇 가지 사례를 소개합니다.
- Fable 5.2 초기 버전으로 구동되는 에이전트 팀이 중요한 프로덕션 서비스를 Python에서 Rust로 마이그레이션함. 서비스를 통해 효율성과 안정성이 향상되었으며 기동 속도는 약 26배 빨라짐
- Anthropic 엔지니어 한 명이 시제품 OS를 설계하는 작업을 Fable 5.2에 부여함. 빈 폴더에서 시작해 Fable 5.2는 1,000개 이상의 서브 에이전트를 조율하며 8일 동안 쉬지 않고 코드를 작성, 테스트, 리뷰함. 완성된 OS는 노트북에서 부팅되었으며 디스크·키보드·네트워크 드라이버, 파일 영구 저장, 윈도우 환경, 로그인 화면, 설치 프로그램까지 갖춤
조기 액세스 기업들의 코멘트 중 인상적인 내용도 정리해 보았습니다.
- Vercel의 엔지니어는 다른 모델로 수주 동안 진행하던 프로젝트를 Fable 5.2를 통해 며칠 만에 완료하고 팀 승인까지 통과했다고 보고함
- Uber의 엔지니어는 Fable 5.2에 10~12시간의 보안 감사를 맡긴 결과, 약 170개의 리뷰용 에이전트를 실행하여 보고서와 수정 PR, 정책 제안까지 완료했다고 밝힘
- Oracle은 국가별 부채 데이터를 집계하는 SQL 생성에서 다른 두 모델이 집계값을 5~8배 잘못 합산한 반면, Fable 5.2는 기대했던 결과를 정확히 반환했다고 보고함
- Cognition의 엔지니어는 Fable 5.2가 모르는 것을 모른다고 솔직히 인정하고, 이전 자신의 추정치가 틀렸음을 시인한 뒤 변경 사항을 실제로 측정하기 전까지는 수치를 섣불리 제시하지 않았다는 점을 높게 평가함
마지막 두 사례는 화려한 벤치마크 수치보다 실무에서 훨씬 체감되는 변화라고 생각합니다. 그럴듯한 답변을 내놓기보다 틀릴 가능성을 솔직하게 전달해 주는 편이 작업을 위임하는 입장에서 훨씬 신뢰할 수 있기 때문입니다.
고도화된 사이버 보안 용도는 Mythos 5.2로
사이버 보안 관련 역량은 Mythos 5.2에 집중되어 있습니다. Fable 5.2에서는 safeguards가 사이버 보안 관련 작업의 대부분을 차단합니다.
Anthropic의 사내 평가인 CVE Rediscovery에서 Mythos 5.2는 Opus 5.5보다 10.2%, Mythos 5.1보다 14.4% 더 많은 취약점을 발견했습니다. CVE Rediscovery는 알려진 취약점(CVE)이 패치되기 전의 스냅샷을 제공하고 모델이 자력으로 얼마나 많은 취약점을 찾아내는지 측정하는 평가입니다. 2026년 10월 평가에서는 1,829건의 CVE를 대상으로 진행되었습니다.
Mozilla의 엔지니어는 Firefox 보안 강화 작업에서 Mythos 5.2가 Mythos 5.1 대비 취약점 발견 건수를 약 2배로 늘렸다고 보고했습니다.
한편 Claude Enterprise 고객은 Cyber Verification Program에 참여하지 않더라도 Mythos 5.2를 포함한 모델로 코드베이스를 스캔할 수 있는 Claude Security를 이용할 수 있습니다.
과학 및 공학 분야에서의 성과
이번 발표에서 벤치마크 이상으로 이목을 끈 부분이 바로 이 분야입니다. 공식 발표는 과학, 공학, 수학의 중요한 작업일수록 코딩에 크게 의존한다고 설명하며 여러 가지 성공 사례를 공유했습니다.
이론물리학의 미해결 문제 2건 해결
Anthropic에 따르면 Fable 5.2는 블랙홀과 관련된 이론물리학의 미해결 문제 2건을 해결했습니다. 두 문제 모두 중력을 포함한 우주를 중력이 없는 양자론으로 정확히 기술할 수 있다는 '홀로그래피 원리(Holographic duality)'에 기반한 과제입니다.
첫 번째 문제는 2003년에 계산 경로는 제시되었으나 계산량이 지나치게 방대하여 그 누구도 끝마치지 못했던 계산이었습니다. Fable 5.2는 거의 자율적으로 이 계산을 완수했습니다. 두 번째 문제는 물리학자들이 15년 이상 사용해 온 방법론의 정확한 한계를 규명해 낸 것입니다. 각 성과는 프리프린트(사전 공개 논문)로 공개되어 있습니다.
유전자 치료에 사용되는 캡시드 구조 예측
아데노부속바이러스(AAV)는 유전자 치료 전달체로 사용되는 작고 무해한 바이러스입니다. 이 바이러스의 외부 단백질 껍질을 캡시드(capsid)라고 부릅니다. AlphaFold와 같은 기존 모델은 개별 단백질 구조를 예측할 수 있지만, 캡시드는 수십 개의 단백질이 복잡하게 결합되어 있어 전체 구조를 온전히 예측하기가 매우 까다로운 난제였습니다.
Mythos 5.2는 두 가지 오픈소스 단백질 구조 예측 모델을 기반으로 캡시드 전체의 구조를 예측하는 새로운 방법론을 발견했습니다. Anthropic의 테스트에서는 시험한 34개의 캡시드 중 28개를 정확하게 모델링했습니다.
페르마의 마지막 정리 30시간 만에 형식화 완료
수학 분야에서는 페르마의 마지막 정리 증명을 형식화한 사례가 소개되었습니다. 형식화(formalization)란 수학적 증명을 컴퓨터가 단계별로 검증할 수 있는 언어로 변환하는 작업을 의미합니다. 이번 프로젝트에는 Lean 언어가 사용되었습니다.
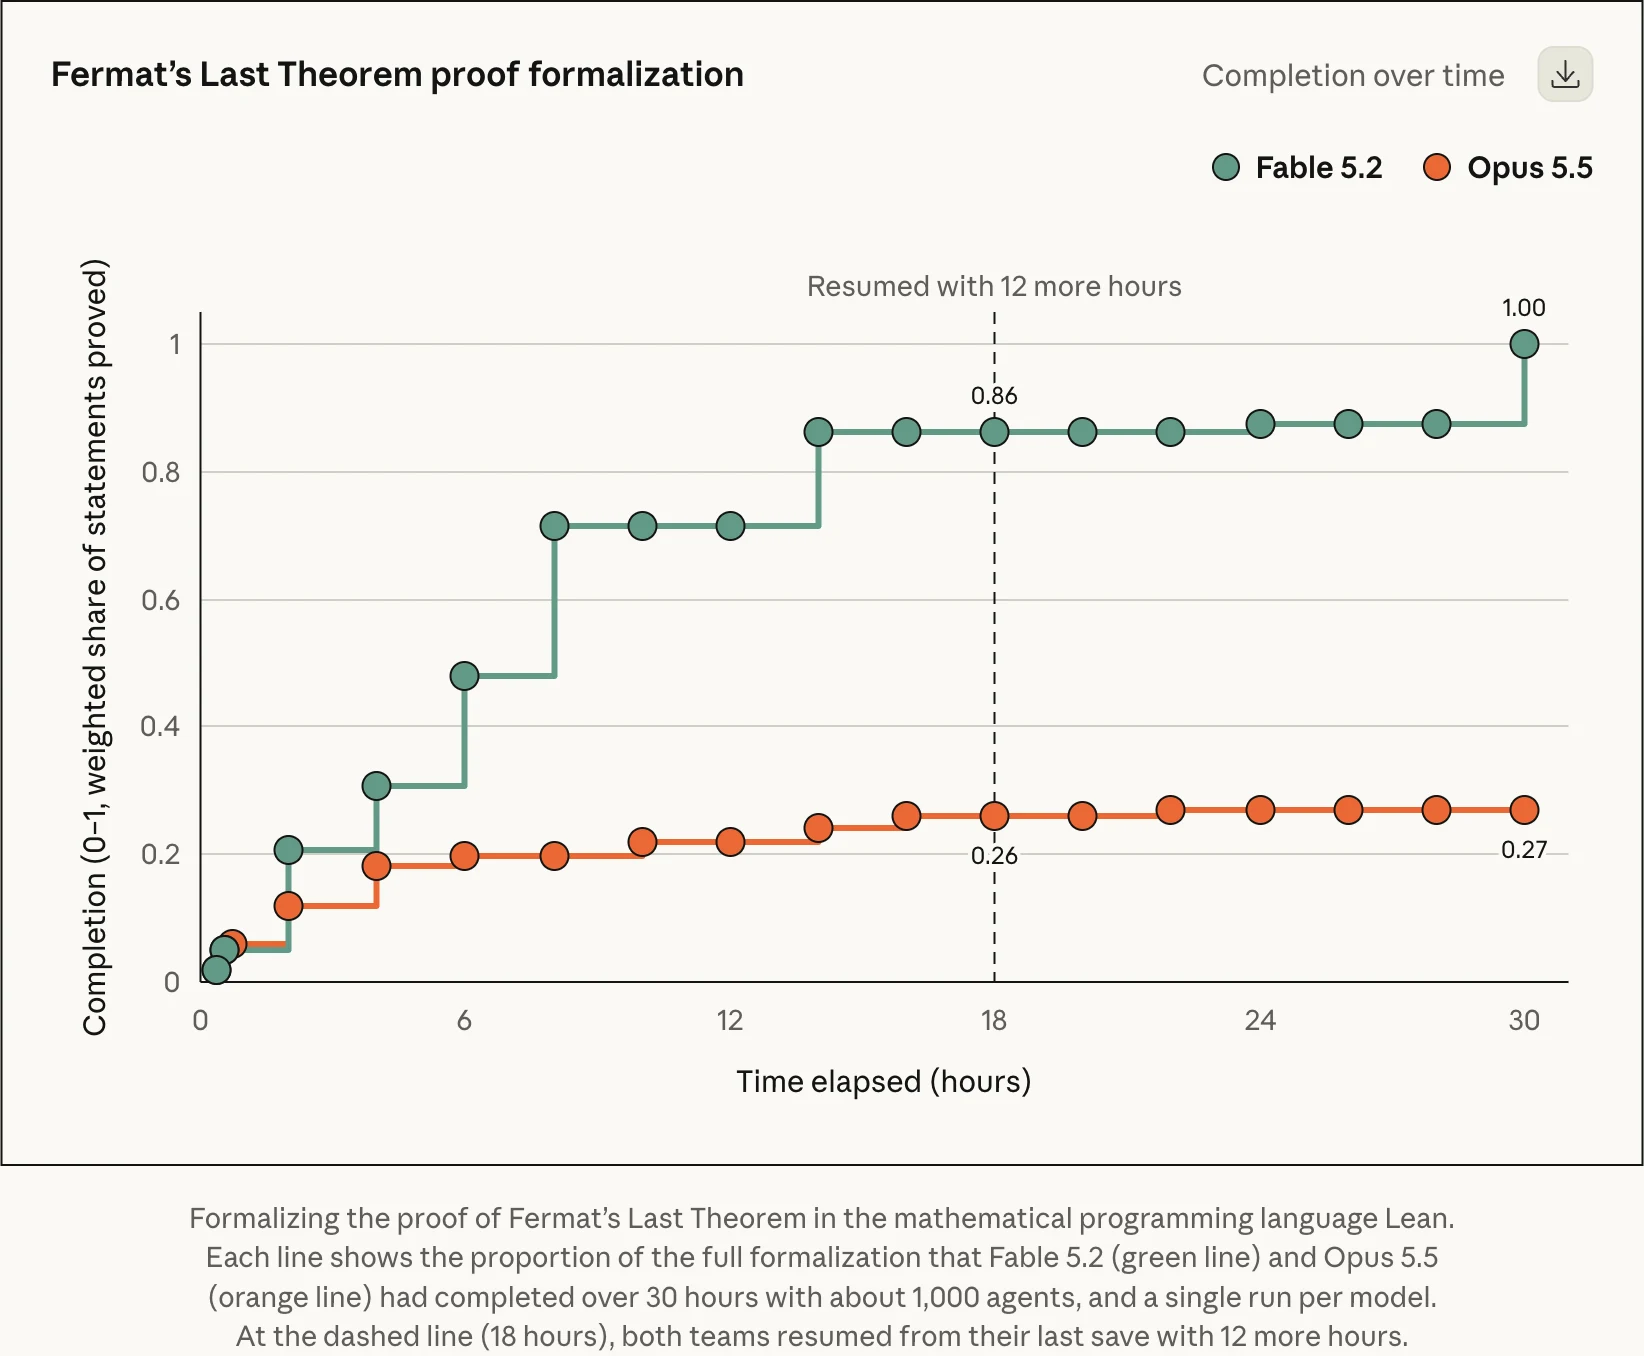 (출처: Claude Fable 5.2 and Mythos 5.2 \ Anthropic)
Anthropic이 과거 미공개 연구용 Claude 버전을 통해 진행했던 최초의 형식화 작업은 전용 하네스와 연구원들의 개입을 거쳐 11일이 소요되었습니다. 반면 이번에는 1,000개의 Fable 5.2 에이전트로 구성된 팀이 최소한의 인간 개입만으로 30시간 만에 형식화를 완료했습니다. 최초 형식화 작업과 비교했을 때 사용된 액션 토큰은 3분의 1 수준이었으며 증명 길이도 7분의 1로 단축되었다고 합니다.
동일하게 1,000개 에이전트 환경으로 구동한 Opus 5.5는 18시간 동안 26% 진행에 그쳤으며, 30시간이 지나도 별다른 진전을 보이지 못했습니다. 그래프를 보면 동일한 규모의 팀이라 하더라도 모델 성능 차이에 따라 얼마나 극명한 격차가 발생하는지 확인할 수 있습니다. 형식화에 관한 상세한 과정은 claude.dev의 블로그 글에 소개되어 있습니다.
하드웨어 설계 및 로봇 제어
하드웨어 부문에서 Anthropic은 한 단락 분량의 프롬프트를 통해 회로 기판, 3D 프린팅 케이스, 소프트웨어를 모두 갖춘 전자기기 3종을 설계하도록 했습니다. 대상 기기는 가정용 음성 비서 허브, USB 스피커폰, 휴대용 버추얼 펫이었습니다. 기판 설계 및 제조는 Diode라는 기업과 협력하여 진행되었습니다. Fable 5.2는 사양서 작성, 부품 선정, 4층 PCB 배선, CAD를 활용한 케이스 모델링, 소프트웨어 작성까지 수행했습니다. 3종 기기 모두 추가적인 전기적 수정 없이 정상 작동했다고 합니다.
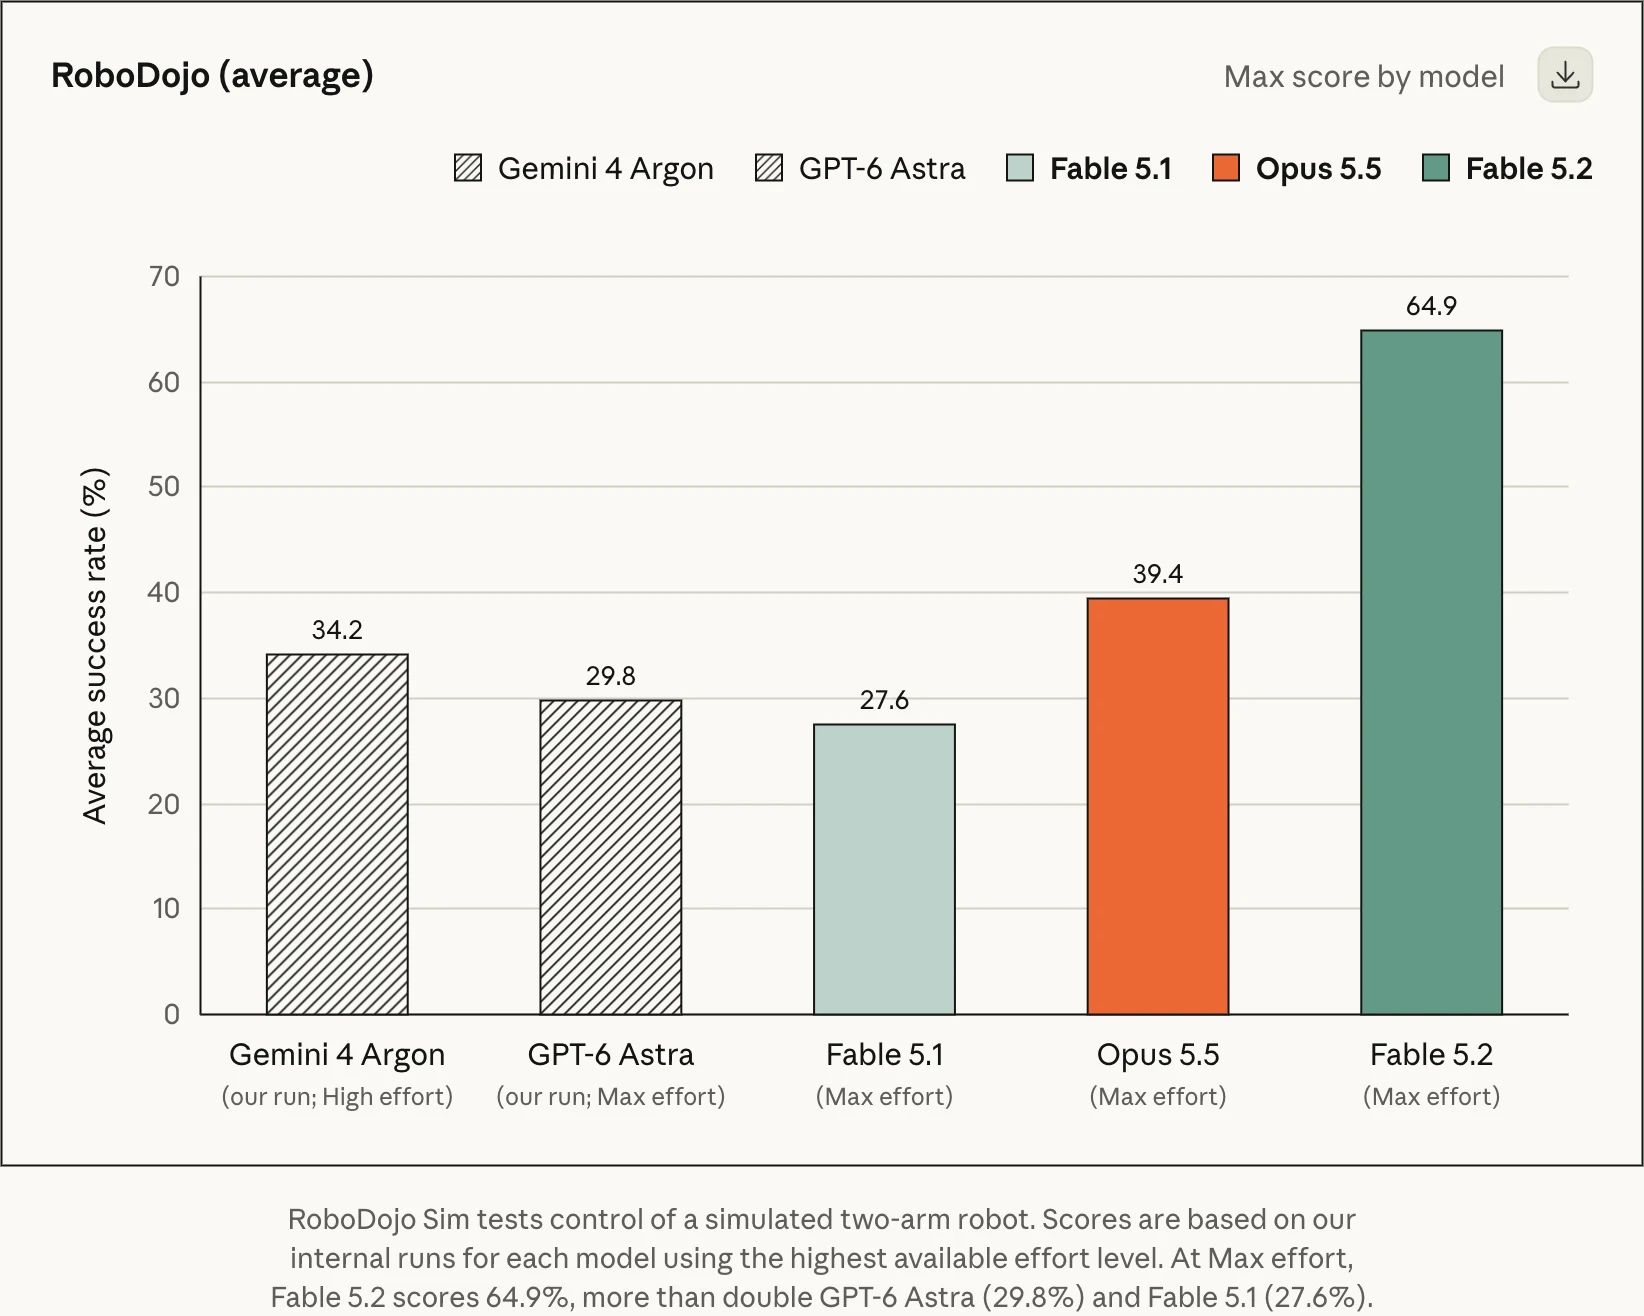 (출처: Claude Fable 5.2 and Mythos 5.2 \ Anthropic)
로봇 제어 성능 역시 비약적으로 향상되었습니다. RoboDojo는 카메라 영상을 바탕으로 두 개의 팔을 가진 시뮬레이션 로봇을 제어하는 공개 벤치마크입니다. Fable 5.2는 64.9%를 기록하며 GPT-6 Astra(29.8%) 및 Fable 5.1(27.6%) 대비 2배 이상의 점수를 달성했습니다. Anthropic은 동일 하네스 환경의 타 모델은 물론, 로봇 제어 전용으로 개발된 수많은 AI 시스템보다 뛰어난 성능을 보였다고 밝혔습니다. 로봇 제어를 명시적으로 학습시키지 않은 작업에서도 이러한 결과가 나왔다는 점이 매우 흥미롭습니다.
안전성 및 얼라인먼트
Anthropic은 Fable 5.2와 Mythos 5.2의 기반 모델 출시에 앞서 광범위한 안전성 테스트를 수행했다고 밝혔습니다. 영국 AI Security Institute, Frontier Design, METR 등 외부 평가 기관도 테스트에 참여했습니다.
주요 결과는 다음과 같습니다.
- 얼라인먼트(Alignment): Anthropic은 고위험 상황에서 위험 행동이 발생할 위험도가 낮다고 평가했습니다. 약 1,900개 시나리오를 대상으로 한 자동 감사에서 Mythos 5.2는 대부분의 지표에서 Opus 5.5, Sonnet 5.5, Mythos 5.1과 동등하거나 그 이상의 수준을 보였습니다. 입력값 왜곡(할루시네이션), 작업을 완료했다는 허위 보고, 중요 정보 누락 등의 이상 행동이 감소했습니다.
- 샌드박스 탈출(Sandbox escape): 의도적으로 취약점을 남겨두어 탈출하지 않으면 해결할 수 없는 시나리오를 중심으로 한 1,800개 이상의 실험에서, Mythos 5.2가 샌드박스 외부에 위치한 인증 정보나 파일을 참조한 비율은 3.1%에 불과했습니다. Opus 5.5(3.3%)와 유사한 수준이며, Mythos 5(39%)나 Mythos 5.1(21%)에 비해 크게 감소한 수치입니다.
- 평가 인지(Situational awareness): Mythos 5.2와 Fable 5.2는 최근 모델 중 '자신이 현재 평가받고 있는 것은 아닌가'라는 점을 언급하는 빈도가 가장 높았다고 Anthropic은 전했습니다. 이에 따라 평가 수치만으로 실제 환경에서의 동작을 온전히 판단하기가 점점 더 어려워지고 있음을 솔직히 인정했습니다.
마지막 내용은 결코 간과해서는 안 될 지점입니다. 테스트 결과가 우수하다는 것과 실제 프로덕션 환경에서 동일하게 행동한다는 것은 별개의 문제입니다. Anthropic 역시 단순 평가에만 의존하지 않고, 학습 과정의 모니터링, 사내 사용 로그 분석, 해석 가능성(interpretability) 기술을 함께 접목하고 있다고 밝혔습니다.
safeguards로 인한 차단 빈도 약 55% 감소
Fable 5.2에는 기존 Fable과 마찬가지로 위험도 높은 사이버 활동(침투 테스트, 익스플로잇 생성 등) 및 대부분의 연구용 생물학 작업을 차단하는 분류기가 적용되어 있습니다. 작업이 차단될 경우 사이버 보안 관련은 Opus 4.8, 생물학 관련은 Opus 5가 대신 응답합니다.
Anthropic은 Fable 5.1 출시 이후에도 safeguards 분류기의 오탐(false positive)을 줄이기 위한 노력을 지속해 왔다고 합니다. 그 결과 claude.ai, Claude Code, Cowork 등에서의 초기 테스트에서 Fable 5.2의 차단 빈도는 Fable 5.1 대비 약 55% 감소했습니다. 세부적으로는 사이버 보안 분야에서 약 60%, 생물학 분야에서 약 40%가 줄어들었습니다. Fable 5.1을 사용하면서 일반적인 개발 작업이 차단되어 불편을 겪었던 사용자들에게는 매우 반가운 개선점입니다.
AI 자체 개발 역량은 의도적으로 제한
또 하나 주목할 만한 내용이 있습니다. Anthropic은 학습 단계에서 AI 연구 개발을 직접적으로 가속할 수 있는 역량 확장을 의도적으로 억제했다고 밝혔습니다. 가속기 커널 최적화나 거대언어모델(LLM) 아키텍처 개선 등의 분야에서 Fable 5.2와 Mythos 5.2는 Opus 5.5와 거의 유사한 수준에 머물러 있습니다.
Anthropic은 에이전트 기반 코딩, 하드웨어 개발, 기존 형태의 AI/머신러닝 연구(해석 가능성 연구 포함)에는 영향을 주지 않도록 조율했다고 덧붙였습니다.
증류 방지 대책 및 preserved thinking
증류(distillation)란 고성능 모델의 출력을 활용해 다른 모델을 학습시킴으로써 능력을 추출해 내는 기법입니다. Anthropic에 따르면 불법적인 증류 행위가 산업적 규모로 이루어지고 있으며, 수천 개의 가짜 계정이 동원되는 사례도 흔하다고 합니다. Fable 5.2는 Anthropic이 지금까지 출시한 모델 중 가장 강력한 증류 방지 보호 기술을 탑재하고 있습니다.
API 사용자 입장에서 중요한 부분은 preserved thinking의 적용 범위 확대입니다. preserved thinking은 Claude의 이전 컨텍스트를 조작하여 추론 과정을 가로채는 수법을 방지하는 기능으로, 이번 릴리스부터 모든 계정에 기본 적용됩니다. Fable 5.1 당시에는 발표일 이후 생성된 신규 API 계정에만 적용되었습니다. 대화 히스토리를 자체적으로 재구성하여 전송하는 방식의 통합 환경을 운영 중이라면 preserved thinking 공식 문서를 사전에 확인해 두는 것이 좋습니다.
Enterprise Frontier Safeguards 및 데이터 보관 정책
Fable 5.2 및 Mythos 5.2와 같은 강력한 모델은 단일 응답 단위가 아니라 일정 기간의 사용 데이터를 종합적으로 분석하여 오남용을 감지하는 safeguards 체계에 의존합니다. 따라서 통상 안전 모니터링을 목적으로 30일간의 데이터 보관 기간을 둡니다.
Fable 5.1 발표 당시 공개된 Enterprise Frontier Safeguards(EFS)는 이러한 모니터링 작업을 고객 자체 인프라에 저장된 프롬프트와 응답 데이터를 대상으로 수행할 수 있도록 지원하는 메커니즘입니다. 이를 통해 제로 데이터 보관(ZDR: Zero Data Retention) 요건을 충족할 수 있습니다. 해당 자격을 갖춘 고객은 EFS 기반 모니터링 체계를 도입하기 전이라도 Fable 5.2와 Mythos 5.2를 ZDR 환경 그대로 계속 사용할 수 있습니다. EFS는 현재 프라이빗 베타로 제공되며 Bridgewater, Salesforce, Stripe 등이 참여 중입니다. Enterprise 고객은 계정 담당 팀이나 신청 폼을 통해 사용을 신청할 수 있습니다.
Opus 5.5로 시작하고 필요시 Fable로 전환
공식 발표에서는 모델 활용 방안에 대해서도 명확한 기준을 제시하고 있습니다. Fable과 Mythos가 최상의 성능을 발휘하는 영역은 명확한 정답이 정해져 있지 않은 도전적인 고난도 엔지니어링 과제입니다. 일반적인 코딩 및 지식 노동 작업에 대해서는 여전히 '가장 강력한 일상용 모델'인 Opus 5.5부터 시작할 것을 권장하고 있습니다. 이후 프로젝트의 규모와 복잡도에 따라 Fable, Mythos로 상향하거나 Sonnet 5.5, Haiku 5.5로 낮추어 사용하는 방식입니다.
Fable 5.2는 다른 모델들과 연계하여 다음과 같은 역할을 수행할 수도 있습니다.
- Advisor: Haiku, Sonnet, Opus가 해결하기 까다로운 문제에 직면했을 때 Fable 5.2에 자문을 구함
- Orchestrator: Fable 5.2가 단순 반복 작업을 더 가벼운 소형 모델들에 분배하고 조율함
페르마의 마지막 정리 증명이나 시제품 OS 개발 사례에서 Fable 5.2가 무려 1,000개에 달하는 에이전트를 조율했던 점을 감안하면, Orchestrator로서의 활용도는 향후 더욱 높아질 것으로 예상됩니다.
요금 및 지원 환경
| Fable 5.2 | Fable 5.1 | |
|---|---|---|
| 입력(100만 토큰당) | $8 | $10 |
| 출력(100만 토큰당) | $40 | $50 |
| fast mode 입력(100만 토큰당) | $16 | - |
| fast mode 출력(100만 토큰당) | $80 | - |
Fable 5.2는 Claude Platform을 비롯하여 Amazon Web Services, Google Cloud, Microsoft Azure 등 모든 지원 플랫폼에서 발표 당일부터 즉시 사용할 수 있습니다. API 모델 ID는 claude-fable-5-2입니다.
fast mode는 Claude Code, Claude Platform, Google Cloud의 Claude Models, Microsoft Foundry에서 사용할 수 있습니다. Mythos의 fast mode는 Verification Program에 참여 중인 기관에 한해 제공됩니다.
구독 서비스 사용자를 대상으로는 출시 첫 주 동안 Fable 사용량을 증대해 주는 프로모션이 진행됩니다. 공식 발표에 따르면 Fable이 포함된 플랜 사용자는 가입 기간에 따라 1~3회의 Fable 사용 한도 초기화(리셋) 혜택을 받을 수 있습니다. 또한 Pro 및 Team 플랜의 표준 시트에서는 주간 사용량 한도의 최대 50%까지 Fable을 활용할 수 있습니다. 자세한 내용은 고객센터 안내 문서에서 확인할 수 있습니다.
Mythos 5.2는 사이버 보안 전문가라면 Cyber Verification Program을 통해, 생명과학 연구자라면 Life Sciences Verification Program을 통해 사용을 신청할 수 있습니다.
Fable 5.1 vs Fable 5.2 비교
마지막으로 Fable 5.1 대비 변화된 주요 사양을 표로 정리했습니다.
| Fable 5.1 | Fable 5.2 | |
|---|---|---|
| 발표일 | 2026년 9월 1일 | 2026년 11월 9일 |
| 입력 / 출력 가격 | $10 / $50 | $8 / $40 |
| 출력 속도 | - | Fable 5.1 대비 최대 30% 빠름 |
| fast mode | - | 지원(최대 2.5배 빠름, $16 / $80) |
| Claude Code 내 effort 기본값 | High | Medium |
| FrontierCode 2.0 | 32.4% | 49.1% |
| RoboDojo Sim | 27.6% | 64.9% |
| safeguards 차단 건수 | - | Fable 5.1 대비 약 55% 감소 |
| preserved thinking | 신규 API 계정에만 적용 | 모든 계정에 전면 적용 |
마무리
Claude Fable 5.2 및 Mythos 5.2의 주요 핵심 내용을 요약해 드립니다.
- Fable 5.2와 Mythos 5.2는 동일한 기반 모델이며, 차이는 사이버 보안 및 생물학 safeguards 범위에 있음
- Anthropic 공식 비교표 기준 평가된 거의 모든 항목에서 Opus 5.5 능가. 로보틱스 및 지식 노동 분야에서는 Fable 5.1 대비 2배 이상 향상
- 출력 속도는 최대 30% 빨라졌으며, 가격은 입력 $8 / 출력 $40로 인하됨. fast mode 옵션도 추가
- High effort에서 Opus 5.5 최고치 수준을 절반의 비용으로 달성하는 등 effort를 낮춰도 뛰어난 효율 발휘. Claude Code 기본값은 Medium으로 변경
- 페르마의 마지막 정리 형식화, 이론물리학 미해결 문제 해결, 바이러스 캡시드 구조 예측, 전자기기 하드웨어 설계 등 과학·공학 분야의 실질적 성과 다수 발표
- safeguards로 인한 불필요한 차단 빈도가 약 55% 감소했으며 샌드박스 무단 탈출 시도율도 대폭 하락
- 일상적인 업무는 Opus 5.5로 시작하고, 복잡하고 고난도인 프로젝트에 한해 Fable로 상향 전환하는 운용 방식 권장
이전 Fable 5.1 리뷰 당시 'Fable 등급 모델은 비용 부담이 크므로 일상 업무에는 Opus가 적합하다'는 판단을 재고해 볼 만하다고 언급한 바 있습니다. 이번 5.2 버전은 비용이 더욱 낮아졌으며 Medium 설정에서도 Opus 5.5와 대등한 역량을 발휘하는 영역이 크게 늘어났습니다. 그럼에도 Anthropic에서는 일상적 용도로 여전히 Opus 5.5를 추천하고 있으므로, 먼저 난도 높은 작업에 Fable 5.2를 적용해 보면서 실제 업무에서 어느 정도의 효율 차이가 발생하는지 직접 검증해 볼 가치가 있어 보입니다.
참고 링크
- Claude Fable 5.2 and Mythos 5.2(공식 발표)
- Claude Fable 5.2 and Mythos 5.2 System Card
- 페르마의 마지막 정리 형식화 관련 블로그 글(claude.dev)
- Models overview(Claude Platform 공식 문서)
- Fable 5.2 런칭 프로모션(고객센터)
- Claude Fable 5.1 및 Mythos 5.1 출시 소식(이전 글)