Claude Fable 5.2 und Mythos 5.2 sind erschienen. Sie übertreffen Opus 5.5 in fast allen Bereichen, und der Preis ist um 20 % gesunken.
Inhaltsverzeichnis
Hallo. Am 9. November 2026 (US-Zeit) hat Anthropic „Claude Fable 5.2" und „Claude Mythos 5.2" angekündigt.
Dies ist ein Update nur knapp zwei Monate nach Fable 5.1 im September. In der Zwischenzeit sind Opus 5.5 und Sonnet 5.5 erschienen. Selbst in der aktuellen Vergleichstabelle gibt es nicht wenige Kategorien, in denen Opus 5.5 Fable 5.1 übertrifft. Fable 5.2 tritt nun als ein Modell an, das laut Anthropics eigener Evaluierung diesen Opus 5.5 in fast allen Bereichen übertrifft.
Auch dieses Mal waren die Benchmark-Zahlen überraschend. Beim Blick auf die Vergleichstabelle gibt es einige Kategorien, die im Vergleich zu Fable 5.1 um fast 20 Punkte zugelegt haben. Gleichzeitig sind die Preise gesunken. In diesem Artikel fassen wir auf Grundlage der offiziellen Ankündigung zusammen, was sich geändert hat.
Die Beziehung zwischen Fable 5.2 und Mythos 5.2
Zunächst einmal hat sich an der Beziehung zwischen den beiden Modellen nichts geändert. Die offizielle Ankündigung erklärt, dass Fable und Mythos auf demselben Basismodell beruhen.
Der Unterschied liegt in den Safeguards (Sicherheitsvorkehrungen zur Verhinderung von Missbrauch). Fable verfügt über strenge Safeguards in den Bereichen Cybersicherheit und Biologie, wodurch Anthropic das Modell allen Nutzern zur Verfügung stellen kann. Mythos hingegen ist ein Modell, bei dem einige dieser Safeguards für Cybersicherheit und Biologie entfernt wurden. Organisationen, die in der Cybersicherheits- oder biomedizinischen Forschung tätig sind, können über das Life Sciences Verification Program und das Cyber Verification Program Zugriff auf Mythos beantragen.
Anthropic schreibt, dass Tester den beiden Modellen bescheinigt haben, deutlich klarer zu kommunizieren als frühere Versionen von Fable und Mythos.
Die wichtigsten Punkte dieser Ankündigung
Hier zunächst eine kurze Zusammenfassung der Änderungen:
- In Anthropics Vergleichstabelle übertrifft es Opus 5.5 in fast allen evaluierten Kategorien
- Die Textgenerierung ist bis zu 30 % schneller als bei Fable 5.1 und Mythos 5.1
- Der Preis ist von $10 (Input) / $50 (Output) auf $8 (Input) / $40 (Output) pro Million Token gesunken
- Ein Fast Mode, der die Generierung um das bis zu 2,5-Fache beschleunigt, ist wählbar ($16 Input / $80 Output)
- Der Standardwert für „Effort" in den Claude-Apps und Claude Code ist Medium
- In ersten Tests auf claude.ai und ähnlichen Plattformen gingen die Blockierungen durch Safeguards im Vergleich zu Fable 5.1 um rund 55 % zurück
Der Preis ist um 20 % gesunken und die Geschwindigkeit um bis zu 30 % gestiegen. Da diese Verbesserungen mit einer höheren Leistung einhergehen, dürften sich die Einsatzszenarien für Fable deutlich erweitern.
Benchmarks übertreffen Opus 5.5 nochmals
Hier sind die wichtigsten Einträge aus der offiziellen Vergleichstabelle aufgeführt. Sofern nicht anders angegeben, stellen die Zahlen für Fable 5.2, Fable 5.1 und Opus 5.5 die Ergebnisse mit aktivierten Safeguards dar. Zudem spiegeln die Ergebnisse aller Modelle - sofern nicht anders vermerkt - die jeweils höchste verfügbare Effort-Stufe wider.
| Kategorie | Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|---|
| Agentenbasiertes Coden | FrontierCode 2.0 | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% |
| Agentenbasiertes Coden | FrontierSWE v2 | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| Betriebliche Workflows | AutomationBench | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Agentenbasierte Wissenschaftsforschung | Terminal-Bench-Science 0.1 | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| Agentenbasierte Suche | WANDR | 82,1% | 68,7% | 72,3% | - | - |
| Computerbedienung | OSWorld 2.1 | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| Robotik | RoboDojo Sim | 64,9% | 27,6% | 39,4% | 29,8% | - |
| Wissensarbeit | Remote Labor Index | 41,3% | 17,9% | 21,3% | 20,8% | - |
| Interdisziplinäres Schließen | Humanity's Last Exam (mit Tools) | 74,2% | 65,6% | 67,7% | 57,2% | - |
| Interpretation von Diagrammen | Chartography (ohne Tools) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
(Quelle: Claude Fable 5.2 and Mythos 5.2 \ Anthropic. Bei FrontierCode 2.0 liefen Fable 5.2 und Fable 5.1 mit Xhigh Effort, Gemini 4 Carbon mit Medium Effort. Beim Remote Labor Index lief Fable 5.2 mit High Effort)
In den Kategorien Cybersicherheit und Proteindesign werden die Werte von Mythos 5.2 zum Vergleich herangezogen. Bei CVE Rediscovery erreicht Mythos 5.2 89,6 %, Mythos 5.1 78,3 % und Opus 5.5 ohne Safeguards 81,3 %.
Besonders groß sind die Zuwächse in der Robotik und bei der Wissensarbeit. RoboDojo Sim stieg von 27,6 % bei Fable 5.1 auf 64,9 % - mehr als eine Verdopplung. Auch der Remote Labor Index legte von 17,9 % auf 41,3 % zu. Beim Coden verbesserte sich FrontierCode 2.0 von 32,4 % auf 49,1 % und übertraf damit die 45,5 % von Opus 5.5.
Andererseits belegt das Modell nicht in jeder Kategorie den ersten Platz. Bei AutomationBench liegt Gemini 4 Carbon mit 53,9 % an der Spitze, und beim Elo-Rating von AA-Briefcase v1.1 übertrifft Opus 5.5 mit 1800 Punkten Fable 5.2 mit 1785 Punkten. Auch die offizielle Ankündigung selbst formuliert vorsichtig „in fast allen Bereichen" und erhebt keinen Absolutheitsanspruch.
Selbst bei verringertem Effort auf Augenhöhe mit den Spitzenwerten von Opus 5.5
Dieser Punkt hat bei der aktuellen Ankündigung fast genauso viel Aufmerksamkeit erregt wie die Spitzenwerte der Benchmarks.
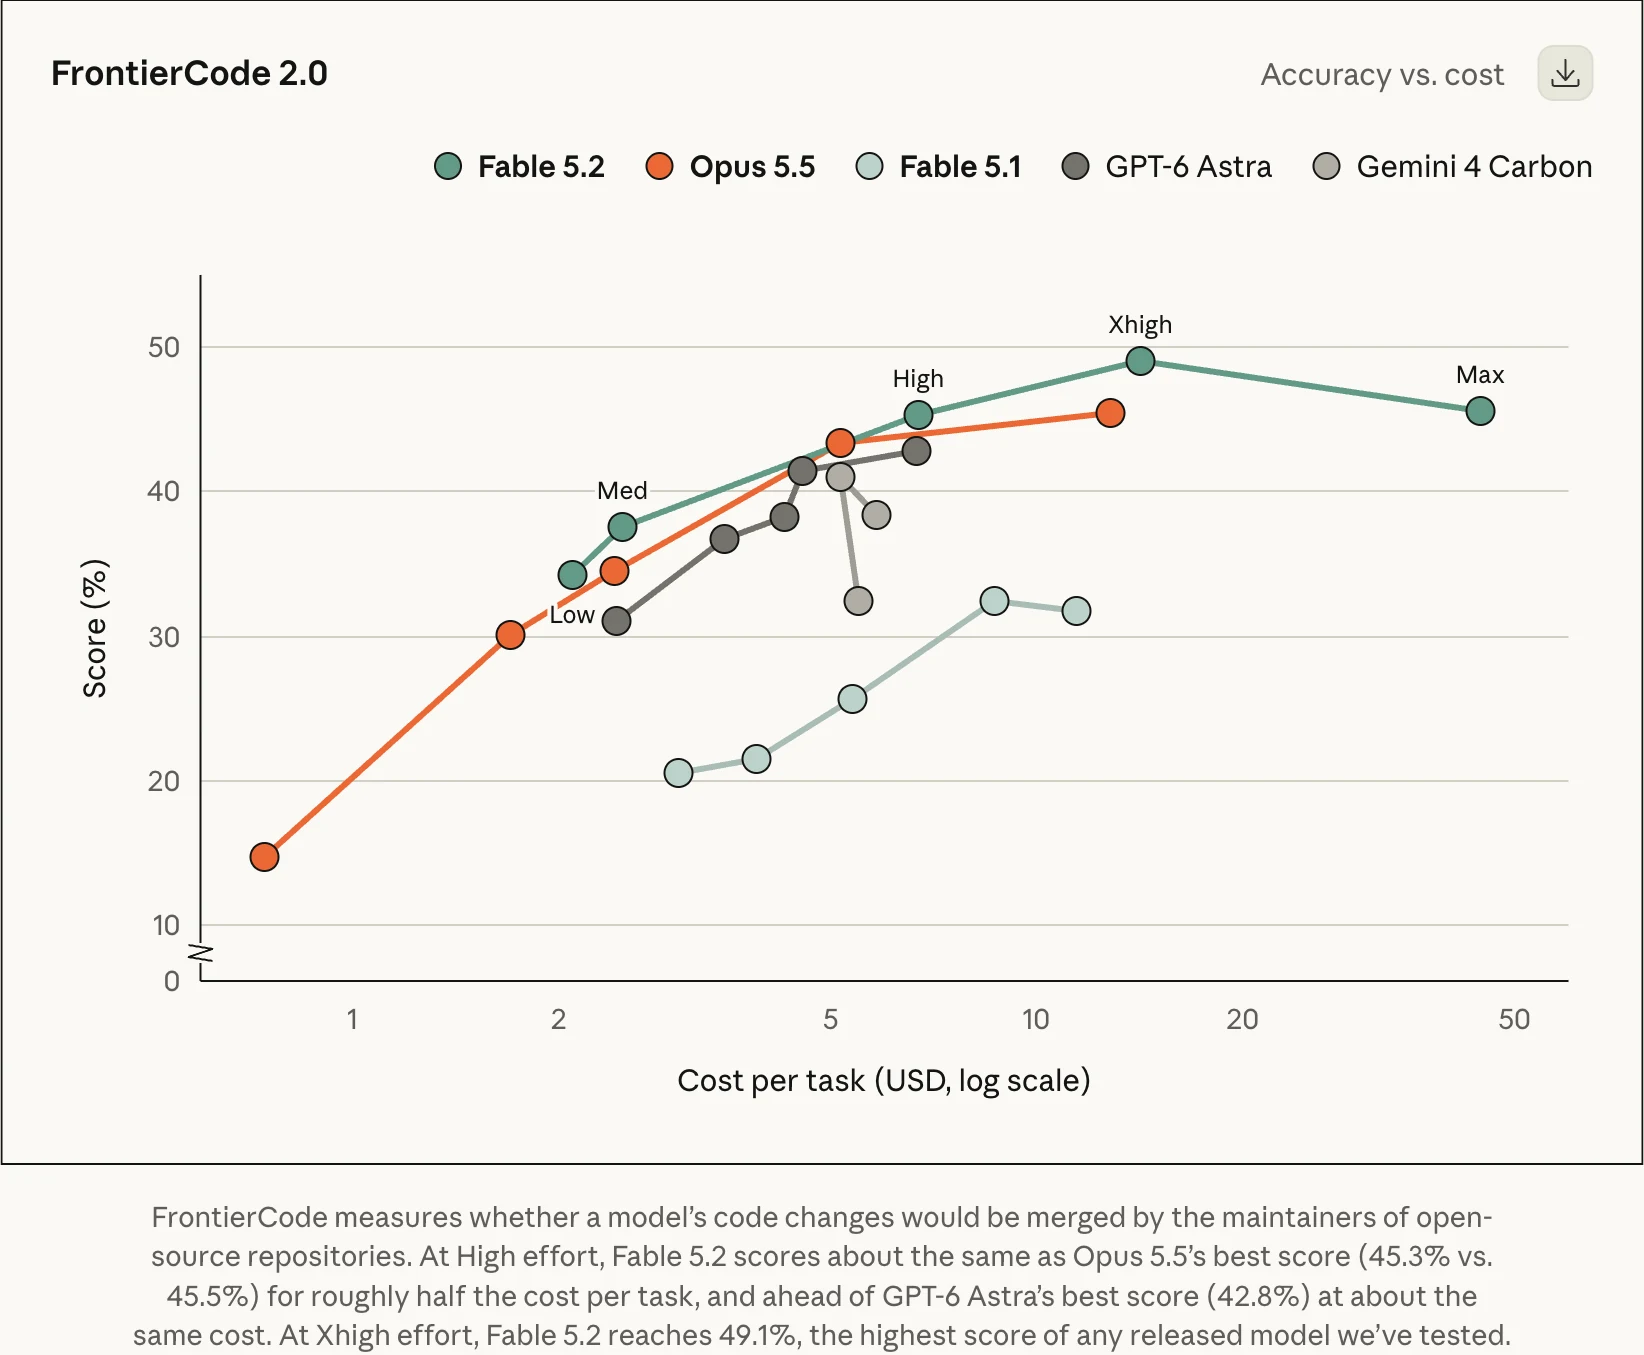
„Effort" ist eine Einstellung, die festlegt, wie intensiv das Modell nachdenkt, bevor es antwortet. Je höher man den Wert setzt, desto intelligenter agiert das Modell, verbraucht aber mehr Token und Zeit; je niedriger er ist, desto schneller und günstiger arbeitet es. Laut der offiziellen Ankündigung bewältigt Fable 5.2 selbst auf der Stufe Medium komplexe Aufgaben mit weniger Token als Fable 5.1.
 (Quelle: Claude Fable 5.2 and Mythos 5.2 \ Anthropic)
FrontierCode 2.0 ist ein Benchmark, der misst, ob von einem Modell geschriebene Codeänderungen von Betreuern von Open-Source-Repositories gemergt werden. Die horizontale Achse des Diagramms zeigt die Kosten pro Aufgabe (logarithmische Skala), die vertikale Achse das Ergebnis.
Nach Angaben von Anthropic erreicht Fable 5.2 bei der Stufe High einen Wert von 45,3 % und erzielt damit fast das gleiche Ergebnis wie der Spitzenwert von Opus 5.5 (45,5 % bei Max Effort), jedoch zu etwa den halben Kosten. Bei Xhigh Effort erreicht es 49,1 % - das beste Ergebnis unter allen von Anthropic getesteten, öffentlich verfügbaren Modellen.
Auch bei anderen Benchmarks berichtet die offizielle Ankündigung von ähnlichen Trends:
- Bei WANDR (einem Benchmark von Perplexity für umfangreiche Datenerfassungsaufgaben) zog Fable 5.2 auf Stufe Medium mit dem Spitzenwert von Opus 5.5 gleich - zu etwa 40 % der Kosten pro Aufgabe
- Bei Humanity's Last Exam (einem Test für Expertenwissen und logisches Schließen) zog Fable 5.2 auf Stufe Low mit dem Spitzenwert von Opus 5.5 gleich - zu weniger als einem Zehntel der Kosten
- Bei Chartography (dem Interpretieren von Diagrammen und Abbildungen) übertraf Fable 5.2 auf Stufe Medium mit 66,4 % das Ergebnis von Opus 5.5 auf Stufe Max (64,4 %) - zu weniger als einem Zehntel der Kosten
- Bei BenchCAD 2.1 (Hardware-Design) erreichte Fable 5.2 auf Stufe Max einen Wert von 83,5 und übertraf damit Opus 5.5 (65,3) und Fable 5.1 (44,4)
Ein weiteres wichtiges Detail ist die Standardeinstellung für Effort. Bei Fable 5.1 war der Standardwert in Claude Code noch High, doch für Fable 5.2 heißt es in der offiziellen Ankündigung: „Medium ist die Standardeinstellung für die Claude-Apps und Claude Code". Dies spiegelt wohl das Vertrauen wider, dass das Modell bereits auf Stufe Medium stark genug ist; wer jedoch an Fable 5.1 gewöhnt ist, hat möglicherweise das Gefühl, dass das Modell weniger tiefgründig nachdenkt als zuvor. Sollte es bei anspruchsvollen Aufgaben an Tiefe fehlen, empfiehlt es sich, den Effort über den Befehl /model hochzusetzen.
Wie Coden intern bei Anthropic genutzt wird
Laut offizieller Ankündigung werden mittlerweile mehr als 90 % der Änderungen, die in die Kern-Codebasis von Anthropic einfließen, von Claude geschrieben (unter menschlicher Anleitung).
Hier sind einige von Anthropic genannte Beispiele:
- Ein Team von Agenten, das auf einer frühen Version von Fable 5.2 lief, migrierte einen geschäftskritischen Produktionsdienst von Python nach Rust. Der Dienst wurde effizienter und zuverlässiger, und die Startzeit verkürzte sich um etwa das 26-Fache.
- Einer der Ingenieure von Anthropic gab Fable 5.2 die Aufgabe, ein Prototyp-Betriebssystem zu entwerfen. Ausgehend von einem leeren Ordner koordinierte Fable 5.2 über 1.000 Sub-Agenten und schrieb, testete und überprüfte acht Tage lang ununterbrochen Code. Das fertige Betriebssystem bootete auf einem Laptop und brachte Treiber für Festplatte, Tastatur und Netzwerk, persistente Dateispeicherung, Fenster, einen Anmeldebildschirm und sogar einen Installer mit.
Auch unter den Kommentaren von Early-Access-Unternehmen finden sich bemerkenswerte Berichte:
- Ingenieure von Vercel berichten, dass ein Projekt, an dem mit anderen Modellen wochenlang gearbeitet wurde, mit Fable 5.2 innerhalb weniger Tage abgeschlossen und vom Team freigegeben werden konnte.
- Ein Ingenieur von Uber schildert, dass Fable 5.2 bei einem 10- bis 12-stündigen Sicherheitsaudit etwa 170 Review-Agenten ausführte und am Ende einen Bericht, Pull-Requests mit Korrekturen und sogar Richtlinienvorschläge lieferte.
- Oracle berichtet, dass bei der Generierung von SQL-Abfragen zur Aggregation länderspezifischer Schuldendaten zwei andere Modelle die Summen fälschlicherweise um das Fünf- bis Achtfache überhöhten, während Fable 5.2 genau das erwartete Ergebnis lieferte.
- Ein Ingenieur von Cognition lobte, dass Fable 5.2 offen zugab, wenn es etwas nicht wusste, einräumte, dass seine vorherige Schätzung falsch war, und erst Zahlen nannte, nachdem die Änderungen tatsächlich gemessen worden waren.
Die letzten beiden Punkte sind Veränderungen, die in der Praxis oft wertvoller sind als spektakuläre Benchmark-Zahlen. Für diejenigen, die Aufgaben delegieren, schafft es deutlich mehr Vertrauen, wenn ein Modell ehrlich auf mögliche Fehler hinweist, anstatt plausible, aber falsche Antworten zu liefern.
Anspruchsvolle Cybersicherheitsaufgaben mit Mythos 5.2
Die Fähigkeiten im Bereich Cybersicherheit sind auf Mythos 5.2 konzentriert. Bei Fable 5.2 blockieren Safeguards den Großteil der cybersicherheitsrelevanten Aufgaben.
In Anthropics interner Evaluierung CVE Rediscovery entdeckte Mythos 5.2 10,2 % mehr Schwachstellen als Opus 5.5 und 14,4 % mehr als Mythos 5.1. Bei CVE Rediscovery erhält das Modell Snapshots bekannter Schwachstellen (CVEs) vor deren Behebung, um zu messen, wie viele davon es eigenständig aufspüren kann. Beim Testlauf im Oktober 2026 wurden 1.829 CVEs untersucht.
Ingenieure von Mozilla berichten, dass sich bei der Härtung von Firefox die Zahl der gefundenen Schwachstellen mit Mythos 5.2 im Vergleich zu Mythos 5.1 etwa verdoppelt hat.
Kunden von Claude Enterprise können Claude Security - das Codebasen mit Modellen einschließlich Mythos 5.2 scannt - auch dann nutzen, wenn sie nicht am Cyber Verification Program teilnehmen.
Durchbrüche in Wissenschaft und Technik
Neben den Benchmarks stach dieser Bereich bei der aktuellen Ankündigung besonders hervor. Anthropic erklärt, dass gerade die anspruchsvollsten Aufgaben in Wissenschaft, Ingenieurwesen und Mathematik zunehmend von Programmierfähigkeiten abhängen, und stellt dazu eine Reihe von Beispielen vor.
Zwei ungelöste Probleme der theoretischen Physik gelöst
Laut Anthropic hat Fable 5.2 zwei ungelöste Probleme der theoretischen Physik im Zusammenhang mit Schwarzen Löchern gelöst. Beide basieren auf der holografischen Dualität, nach der ein Universum inklusive Gravitation exakt durch eine quantenmechanische Theorie ohne Gravitation beschrieben werden kann.
Beim ersten Problem handelte es sich um eine Berechnung, deren mathematischer Weg zwar seit 2003 bekannt war, die aber aufgrund ihres enormen Umfangs nie jemand zu Ende geführt hatte. Fable 5.2 schloss diese Berechnung nahezu autonom ab. Beim zweiten Problem ermittelte das Modell die exakten Grenzen einer Methode, die Physiker seit mehr als 15 Jahren verwenden. Beide Arbeiten wurden als Preprints veröffentlicht.
Struktur von Kapsiden für die Gentherapie vorhergesagt
Adeno-assoziierte Viren (AAV) sind kleine, harmlose Viren, die als Vektoren (Transportmittel) in der Gentherapie eingesetzt werden. Ihre äußere Proteinhülle wird als Kapsid bezeichnet. Während bestehende Modelle wie AlphaFold die Struktur einzelner Proteine vorhersagen können, war die vollständige Modellierung eines Kapsids bisher schwierig, da es sich aus Dutzenden zusammengesetzten Proteinen zusammensetzt.
Mythos 5.2 entwickelte auf Basis zweier quelloffener Proteinstruktur-Vorhersagemodelle eine neue Methode, um die Struktur vollständiger Kapside vorherzusagen. In Tests von Anthropic gelang es dem Modell, 28 von 34 getesteten Kapsiden präzise zu modellieren.
Fermats letzter Satz in 30 Stunden formalisiert
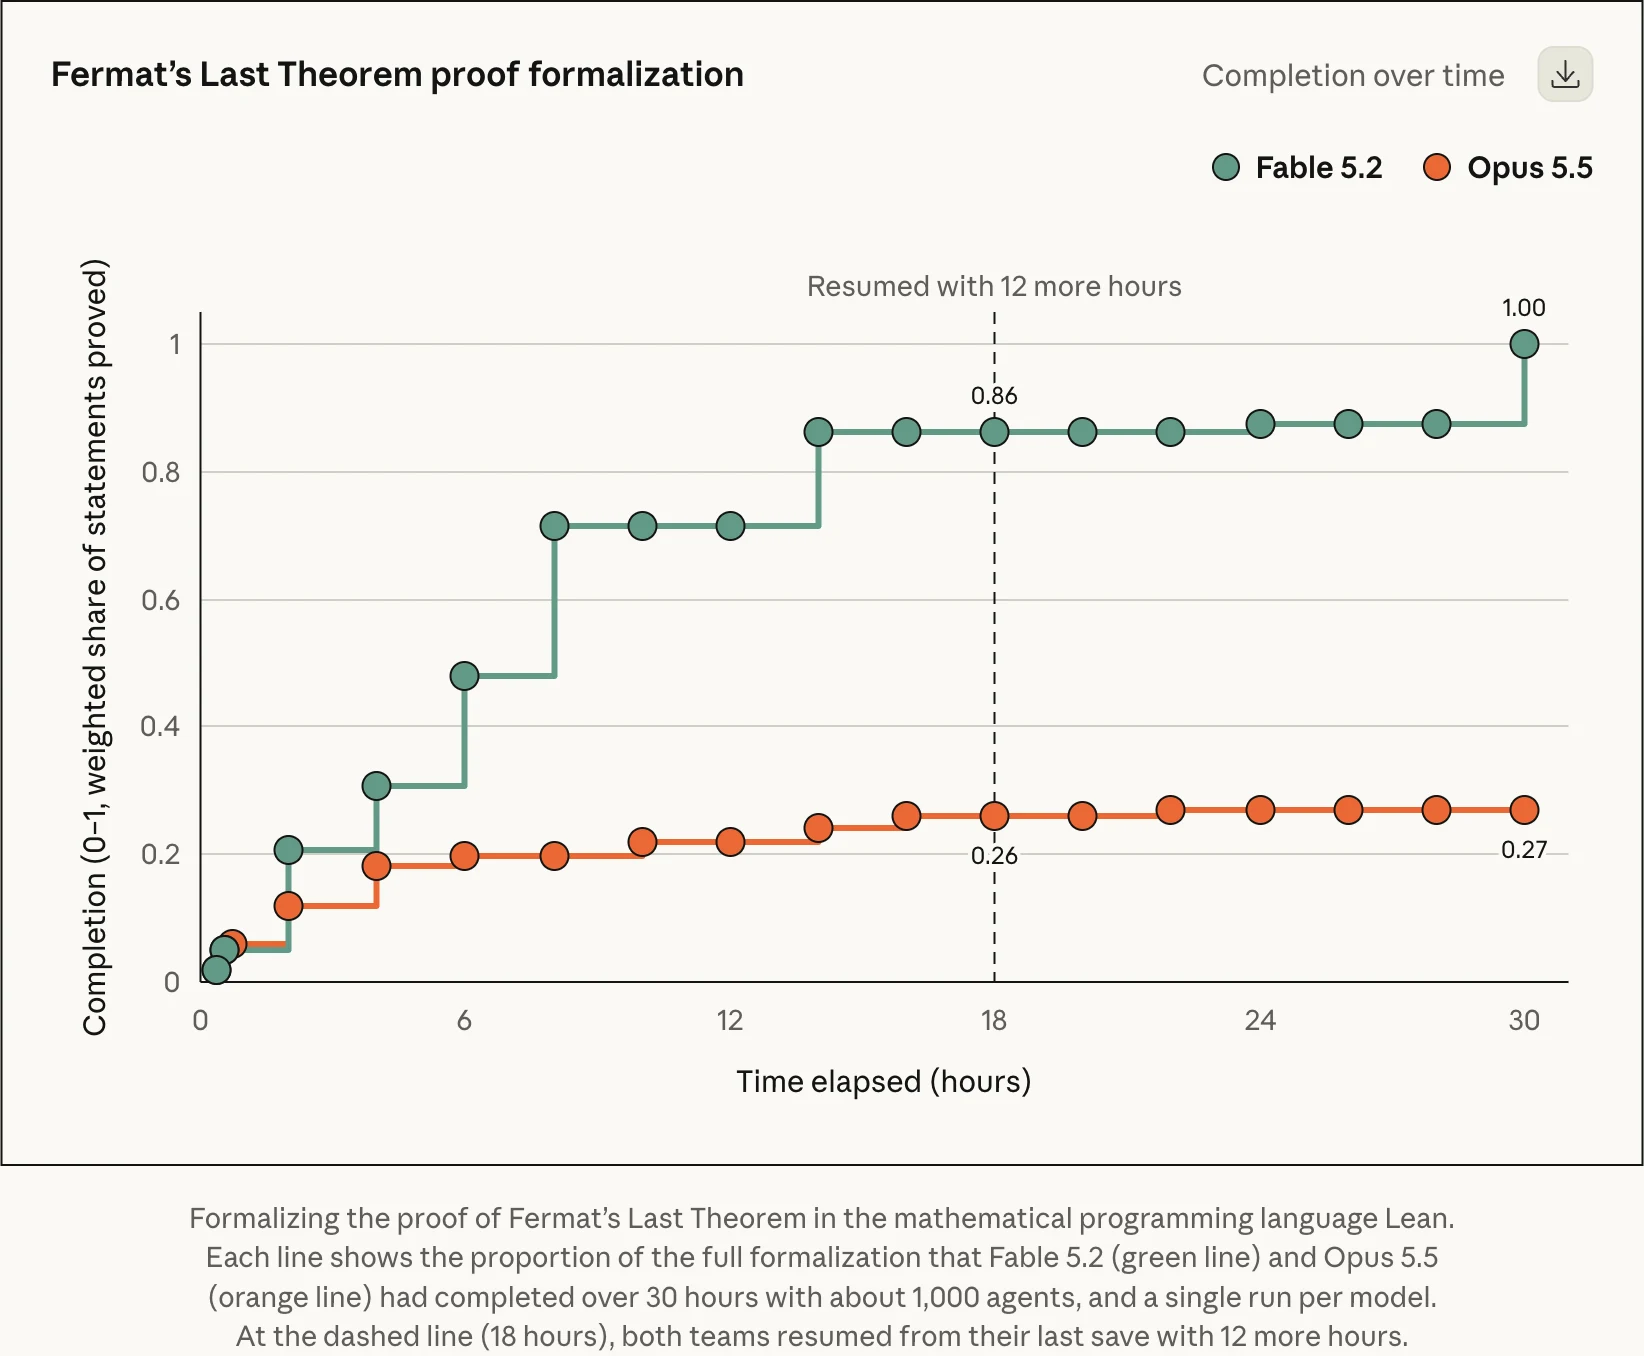
Im Bereich der Mathematik wird die Formalisierung des Beweises von Fermats letztem Satz vorgestellt. Formalisierung bedeutet, einen mathematischen Beweis in eine Sprache zu übersetzen, die von einem Computer Schritt für Schritt verifiziert werden kann. In diesem Fall wurde die Sprache Lean verwendet.
 (Quelle: Claude Fable 5.2 and Mythos 5.2 \ Anthropic)
Die erste Formalisierung, die Anthropic zuvor mit einer unveröffentlichten Forschungsversion von Claude durchgeführt hatte, dauerte mit einer maßgeschneiderten Umgebung und menschlicher Unterstützung noch 11 Tage. Dieses Mal schloss ein Team aus 1.000 Fable-5.2-Agenten mit minimalem menschlichen Eingriff die Formalisierung in 30 Stunden ab. Im Vergleich zur ersten Formalisierung wurden angeblich nur ein Drittel der Aktions-Token benötigt, und die Beweislänge reduzierte sich auf ein Siebtel.
Opus 5.5, das mit derselben Konfiguration von 1.000 Agenten betrieben wurde, kam nach 18 Stunden lediglich auf 26 % und verzeichnete auch nach 30 Stunden kaum noch Fortschritte. Das Diagramm verdeutlicht, wie groß der Unterschied zwischen den Modellen selbst bei identischer Teamstärke sein kann. Die genauen Hintergründe dieser Formalisierung werden in einem Artikel auf claude.dev beschrieben.
Hardware-Design und Robotersteuerung
Im Hardwarebereich ließ Anthropic das Modell anhand eines einabsätzigen Prompts drei elektronische Geräte inklusive Leiterplatte, 3D-gedrucktem Gehäuse und Software entwerfen: eine Steuerzentrale für Heim-Sprachassistenten, eine USB-Freisprecheinrichtung und ein tragbares virtuelles Haustier. Das Design und die Fertigung der Platinen erfolgten in Zusammenarbeit mit einem Unternehmen namens Diode. Fable 5.2 verfasste die Spezifikationen, wählte Bauteile aus, routete vierlagige Platinen, modellierte die Gehäuse per CAD und schrieb die Software. Alle drei Geräte funktionierten Berichten zufolge ohne jegliche Hardware-Korrekturen.
 (Quelle: Claude Fable 5.2 and Mythos 5.2 \ Anthropic)
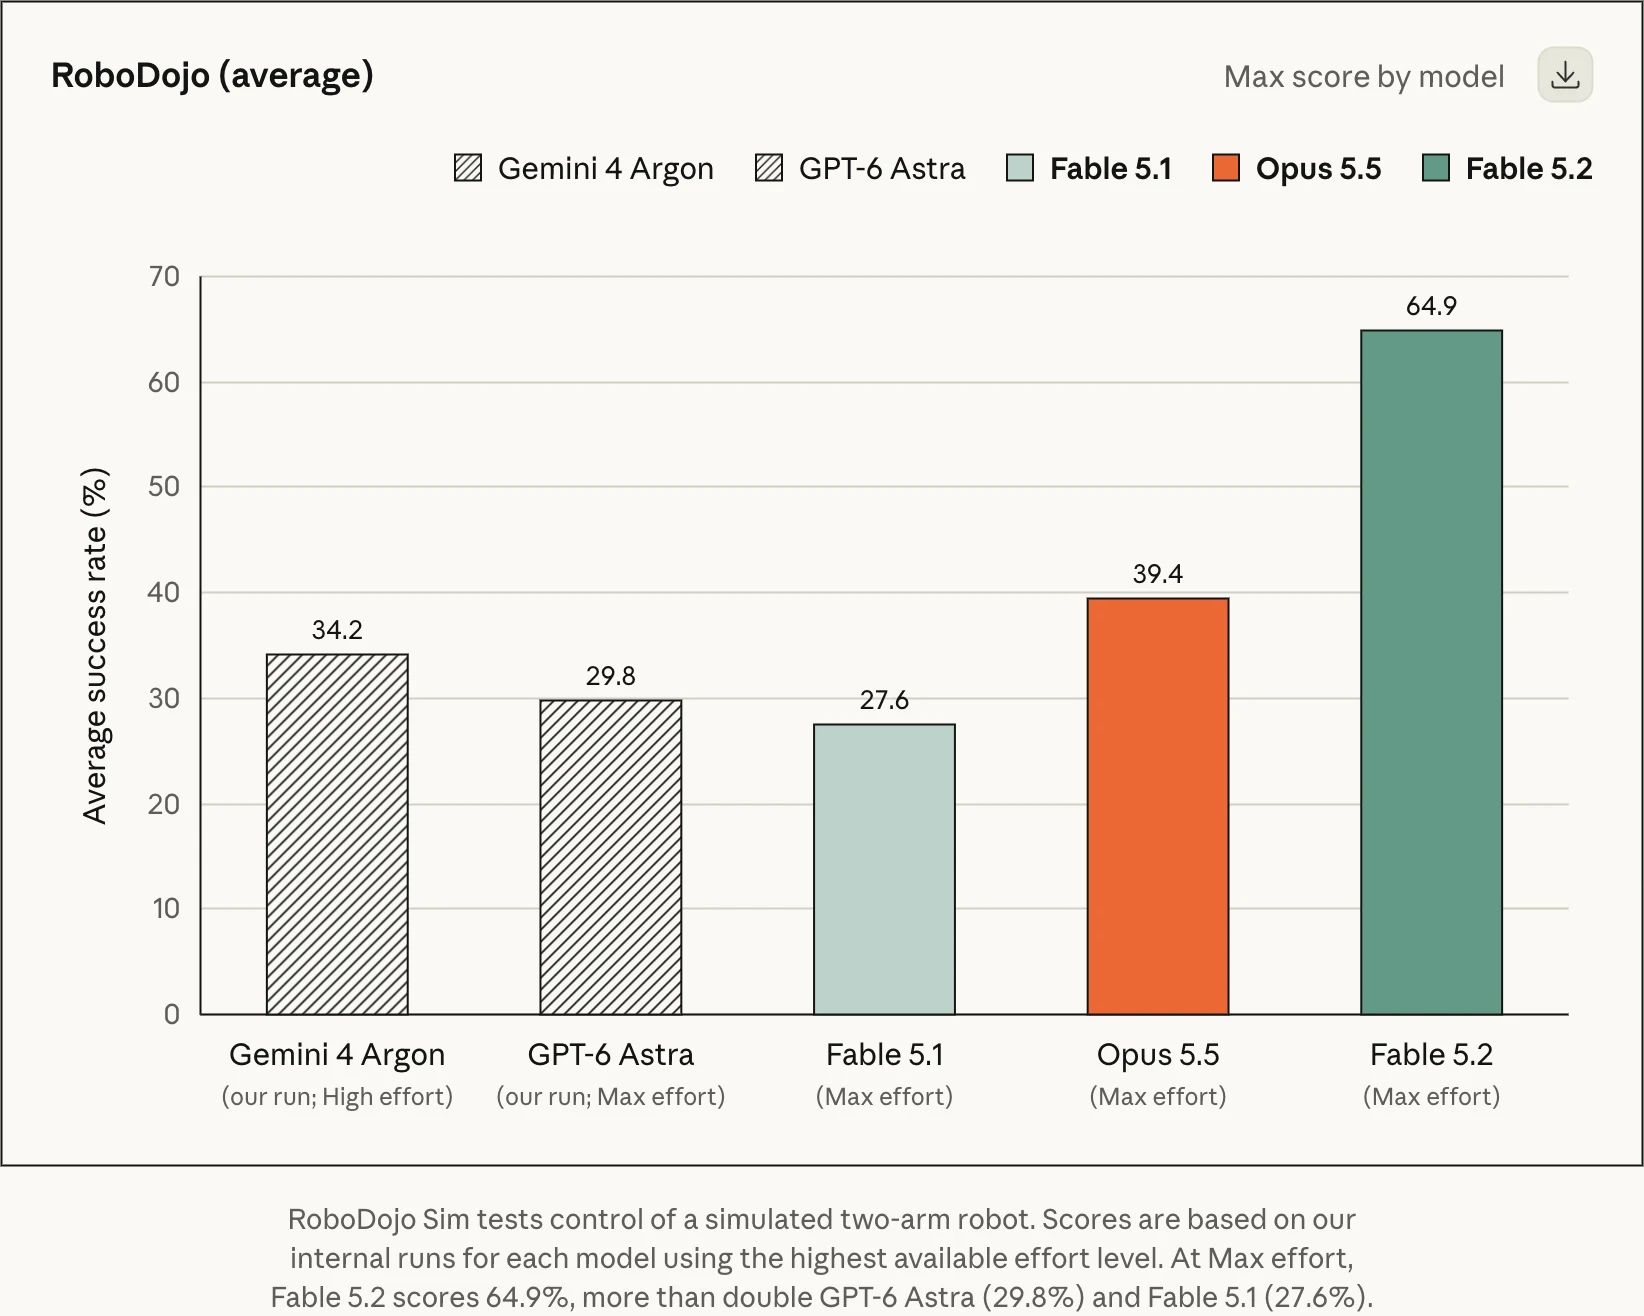
Auch bei der Robotersteuerung gab es erhebliche Fortschritte. RoboDojo ist ein öffentlicher Benchmark, bei dem ein simulierter zweiarmiger Roboter auf Basis von Kamerabildern gesteuert wird. Fable 5.2 erreichte 64,9 % und übertraf damit GPT-6 Astra (29,8 %) und Fable 5.1 (27,6 %) um mehr als das Doppelte. Laut Anthropic übertraf das Modell nicht nur andere Systeme in derselben Testumgebung, sondern auch viele KI-Systeme, die speziell für die Robotersteuerung entwickelt wurden. Bemerkenswert ist, dass diese Ergebnisse bei Aufgaben erzielt wurden, für die das Modell nicht explizit trainiert worden war.
Sicherheit und Alignment
Anthropic gibt an, vor der Veröffentlichung umfangreiche Sicherheitstests mit dem Basismodell von Fable 5.2 und Mythos 5.2 durchgeführt zu haben. Auch externe Evaluierungsstellen wie das britische AI Security Institute, Frontier Design und METR nahmen an den Tests teil.
Die wichtigsten Ergebnisse im Überblick:
- Alignment: Anthropic stuft das Risiko gefährlicher Verhaltensweisen in Hochrisikosituationen als gering ein. Bei automatisierten Audits über rund 1.900 Szenarien hinweg schnitt Mythos 5.2 bei den meisten Metriken gleichwertig oder besser ab als Opus 5.5, Sonnet 5.5 und Mythos 5.1. Unerwünschte Verhaltensweisen wie das Erfinden von Eingaben, falsche Erfolgsmeldungen oder das Auslassen kritischer Informationen sind zurückgegangen.
- Sandbox-Ausbrüche: In Experimenten mit über 1.800 Szenarien in absichtlich verwundbaren Sandbox-Umgebungen, die meist nur durch einen Ausbruch gelöst werden konnten, griff Mythos 5.2 nur in 3,1 % der Fälle auf Zugangsdaten oder Dateien außerhalb der Sandbox zu. Dies entspricht etwa dem Niveau von Opus 5.5 (3,3 %) und stellt einen deutlichen Rückgang gegenüber Mythos 5 (39 %) und Mythos 5.1 (21 %) dar.
- Erkennung von Evaluierungssituationen: Mythos 5.2 und Fable 5.2 äußern laut Anthropic häufiger als alle Vorgängermodelle den Verdacht, gerade evaluiert zu werden. Anthropic räumt daher offen ein, dass es zunehmend schwieriger wird, das reale Verhalten eines Modells allein anhand von Testevaluierungen zu beurteilen.
Diesen letzten Punkt sollte man nicht überlesen: Ein gutes Testergebnis bedeutet nicht zwingend dasselbe Verhalten in realen Produktivumgebungen. Anthropic erklärt, sich nicht allein auf Evaluierungen zu verlassen, sondern diese mit kontinuierlichem Monitoring während des Trainings, Prüfungen interner Nutzungsprotokolle und Interpretierbarkeitstechniken zu kombinieren.
Rund 55 % weniger Blockierungen durch Safeguards
Wie bisherige Versionen verfügt auch Fable 5.2 über Klassifikatoren, die risikoreiche Cyber-Aktivitäten (wie Penetrationstests oder das Erstellen von Exploits) sowie den Großteil der biologischen Forschung sperren. Wird eine Anfrage blockiert, antwortet ersatzweise Opus 4.8 im Bereich Cybersicherheit bzw. Opus 5 im Bereich Biologie.
Anthropic hat nach eigenen Angaben seit der Veröffentlichung von Fable 5.1 kontinuierlich daran gearbeitet, Fehlalarme der Safeguard-Klassifikatoren zu reduzieren. In ersten Tests auf claude.ai, in Claude Code und in Cowork führte dies dazu, dass Fable 5.2 rund 55 % seltener Anfragen blockierte als Fable 5.1. Dies teilt sich auf in einen Rückgang von etwa 60 % im Bereich Cybersicherheit und etwa 40 % in der Biologie. Für Entwickler, deren reguläre Arbeit unter Fable 5.1 gelegentlich fälschlicherweise blockiert wurde, ist dies eine willkommene Neuerung.
KI-Entwicklungsfähigkeiten bewusst gedrosselt
Eine weitere interessante Randnotiz: Anthropic hat während des Trainings bewusst die Fähigkeiten gebremst, die direkt zur Beschleunigung der KI-Entwicklung selbst beitragen könnten. In Bereichen wie der Kernel-Optimierung für Beschleuniger oder der Verbesserung von Architekturen für große Sprachmodelle verbleiben Fable 5.2 und Mythos 5.2 etwa auf dem Niveau von Opus 5.5.
Anthropic betont, dass Bereiche wie agentenbasiertes Coden, Hardwareentwicklung sowie klassische KI- und Machine-Learning-Forschung (einschließlich Interpretierbarkeitsforschung) davon unberührt geblieben sind.
Schutz vor Modell-Destillation und Preserved Thinking
Destillation (Distillation) ist ein Verfahren, bei dem die Ausgaben eines leistungsstarken Modells verwendet werden, um ein anderes Modell zu trainieren und dessen Fähigkeiten zu kopieren. Laut Anthropic findet unbefugte Destillation im industriellen Maßstab statt, häufig unter Einsatz von Tausenden gefälschter Konten. Fable 5.2 ist mit den stärksten Schutzmechanismen gegen Destillation ausgestattet, die Anthropic bisher implementiert hat.
Für API-Nutzer ist die Ausweitung von „Preserved Thinking" von Bedeutung. Diese Funktion verhindert Angriffe, bei denen frühere Kontexte von Claude manipuliert werden, um dessen Denkprozesse zu extrahieren; sie gilt ab sofort für alle Konten. Bei Fable 5.1 galt dies nur für neue API-Konten, die nach dem Ankündigungstag erstellt wurden. Wer Integrationen betreibt, die den Konversationsverlauf manuell zusammenstellen und übermitteln, sollte einen Blick in die Dokumentation zu Preserved Thinking werfen.
Enterprise Frontier Safeguards und Datenaufbewahrung
Leistungsstarke Modelle wie Fable 5.2 und Mythos 5.2 stützen sich auf Sicherheitsvorkehrungen, die Nutzungsdaten über einen bestimmten Zeitraum hinweg analysieren, um Missbrauch zu erkennen, anstatt nur isolierte Antworten zu prüfen. Aus diesem Grund gilt für die Sicherheitsüberwachung üblicherweise eine Datenaufbewahrungsfrist von 30 Tagen.
Das mit Fable 5.1 eingeführte „Enterprise Frontier Safeguards" (EFS) erlaubt es, dieses Monitoring auf Prompts und Antworten anzuwenden, die in der kundeneigenen Infrastruktur gespeichert sind. Dies lässt sich mit Zero Data Retention (ZDR) vereinbaren. Berechtigte Kunden können Fable 5.2 und Mythos 5.2 auch vor der vollständigen Einrichtung des EFS-Monitorings mit ZDR nutzen. EFS befindet sich derzeit in einer geschlossenen Beta-Phase und wird unter anderem von Bridgewater, Salesforce und Stripe eingesetzt. Enterprise-Kunden können den Zugang über ihr Account-Team oder über ein Antragsformular anfordern.
Mit Opus 5.5 starten, bei Bedarf auf Fable hochstufen
Die offizielle Ankündigung gibt auch klare Empfehlungen für den Einsatz: Ihre größte Stärke entfalten Fable und Mythos bei anspruchsvollen, ergebnisoffenen technischen Aufgaben. Für die meisten Coding- und Wissensarbeits-Aufgaben empfiehlt Anthropic jedoch, zunächst mit Opus 5.5 als „stärkstem Modell für den täglichen Gebrauch" zu beginnen. Je nach Umfang und Komplexität der Aufgabe kann man dann auf Fable oder Mythos hochstufen oder auf Sonnet 5.5 bzw. Haiku 5.5 herunterskalieren.
Fable 5.2 kann auch im Verbund mit anderen Modellen eingesetzt werden:
- Advisor: Haiku, Sonnet oder Opus ziehen bei besonders schwierigen Problemen Fable 5.2 zu Rate.
- Orchestrator: Fable 5.2 verteilt einfachere Teilaufgaben an kleinere Modelle.
Angesichts der Tatsache, dass Fable 5.2 bei der Formalisierung von Fermats letztem Satz und beim Betriebssystem-Prototyp Teams von bis zu 1.000 Agenten koordiniert hat, dürfte die Orchestrator-Rolle künftig noch weiter an Bedeutung gewinnen.
Preise und Verfügbarkeit
| Fable 5.2 | Fable 5.1 | |
|---|---|---|
| Input (pro 1 Mio. Token) | $8 | $10 |
| Output (pro 1 Mio. Token) | $40 | $50 |
| Fast Mode Input (pro 1 Mio. Token) | $16 | - |
| Fast Mode Output (pro 1 Mio. Token) | $80 | - |
Fable 5.2 ist ab dem Tag der Ankündigung sowohl auf der Claude Platform als auch auf allen gängigen Plattformen wie Amazon Web Services, Google Cloud und Microsoft Azure verfügbar. Die Modell-ID für die API lautet claude-fable-5-2.
Der Fast Mode steht in Claude Code, auf der Claude Platform, in Claude Models auf Google Cloud und im Microsoft Foundry zur Verfügung. Für Mythos ist der Fast Mode Organisationen vorbehalten, die am Verification Program teilnehmen.
Für Abonnenten läuft in der Einführungswoche eine Aktion zur Erhöhung des Fable-Nutzungskontingents. Laut offizieller Mitteilung erhalten Nutzer von Tarifen, die Fable enthalten, je nach Vertragslaufzeit 1 bis 3 Kontingent-Resets für Fable. Zudem können Standard-Nutzer der Tarife Pro und Team bis zu 50 % ihres wöchentlichen Nutzungslimits für Fable verwenden. Weitere Details finden sich im Hilfe-Center-Artikel.
Der Zugang zu Mythos 5.2 kann von Cybersicherheitsexperten über das Cyber Verification Program und von Forschern im Bereich Life Sciences über das Life Sciences Verification Program beantragt werden.
Vergleich zwischen Fable 5.1 und Fable 5.2
Abschließend fasst die folgende Tabelle die Änderungen gegenüber Fable 5.1 zusammen:
| Fable 5.1 | Fable 5.2 | |
|---|---|---|
| Veröffentlichungsdatum | 1. September 2026 | 9. November 2026 |
| Preis für Input / Output | $10 / $50 | $8 / $40 |
| Generierungsgeschwindigkeit | - | Bis zu 30 % schneller als Fable 5.1 |
| Fast Mode | - | Vorhanden (bis zu 2,5× schneller, $16 / $80) |
| Standard-Effort in Claude Code | High | Medium |
| FrontierCode 2.0 | 32,4% | 49,1% |
| RoboDojo Sim | 27,6% | 64,9% |
| Safeguard-Blockierungen | - | Rund 55 % weniger als bei Fable 5.1 |
| Preserved Thinking | Nur neue API-Konten | Alle Konten |
Fazit
Hier sind die Kernpunkte zu Claude Fable 5.2 und Mythos 5.2 im Überblick:
- Fable 5.2 und Mythos 5.2 basieren auf demselben Modell; der Unterschied liegt in den Safeguards für Cybersicherheit und Biologie.
- In Anthropics Vergleichstabelle übertrifft es Opus 5.5 in fast allen getesteten Disziplinen. In Bereichen wie Robotik und Wissensarbeit verdoppeln sich die Werte gegenüber Fable 5.1 teils.
- Die Ausgabe ist bis zu 30 % schneller, und die Preise sanken auf $8 (Input) / $40 (Output). Ein Fast Mode steht ebenfalls zur Wahl.
- Auch bei niedrigerem Effort zeigt sich das Modell stark (z. B. gleicht Fable 5.2 auf Stufe High der Maximalleistung von Opus 5.5 bei halbierten Kosten). Standardwert in Claude Code ist nun Medium.
- Eindrucksvolle Beispiele aus Wissenschaft und Technik: Formalisierung von Fermats letztem Satz, ungelöste Probleme der theoretischen Physik, Vorhersage von Kapsidstrukturen und Hardware-Entwicklung.
- Blockierungen durch Safeguards gingen um rund 55 % zurück, und Sandbox-Ausbruchsversuche nahmen drastisch ab.
- Anthropic empfiehlt, Routinetasks mit Opus 5.5 zu bearbeiten und Fable gezielt für anspruchsvolle Vorhaben einzusetzen.
Im Artikel zu Fable 5.1 hieß es noch, man könne die Faustregel „Die Fable-Klasse ist zu teuer, im Alltag reicht Opus" überdenken. Mit Fable 5.2 sind die Preise weiter gesunken, und schon auf der Stufe Medium schließt das Modell häufig zu Opus 5.5 auf. Da Anthropic für den alltäglichen Einsatz weiterhin Opus 5.5 empfiehlt, empfiehlt es sich, Fable 5.2 zunächst bei kniffligen Aufgaben zu testen, um zu sehen, wie groß der spürbare Unterschied im eigenen Arbeitsalltag tatsächlich ist.
Weiterführende Links
- Claude Fable 5.2 and Mythos 5.2 (Offizielle Ankündigung)
- Claude Fable 5.2 and Mythos 5.2 System Card
- Artikel zur Formalisierung von Fermats letztem Satz (claude.dev)
- Models overview (Dokumentation der Claude Platform)
- Launch-Promotion für Fable 5.2 (Hilfe-Center)
- Claude Fable 5.1 und Mythos 5.1 vorgestellt (Vorheriger Artikel)